numpy + pandas + matplotlib
第一章 导论
1.1 介绍
| 功能 | Excel | Python(Pandas) |
|---|---|---|
| 数据处理量 | 1万行以内 | 100万行以上 |
| 自动化 | 手动操作 | 代码一键运行 |
| 学习难度 | 简单 | 需要基础编程知识 |
数据分析的完整流程
- 数据收集
- 数据清洗
- 数据分析
- 数据可视化
数据分析工具链
- Numpy:高性能数值计算(矩阵/向量) 数据的”发动机”
- Pandas:表格数据处理(类似高级Excel) 数据的”手术刀”
- Matplotlib:数据可视化(绘图库) 数据的”翻译官”
第二章 Numpy科学计算
2.1 Numpy介绍
numpy是python中科学计算的基础包
它是一个Python库,提供多维数组对象、各种派生对象(例如掩码数组和矩阵)以及用于对数组进行快速操作的各种方法,包括数学、逻辑、形状操作、排序、选择、I/O、离散、傅立叶变换、基本线性代数、基本统计运算、随机模拟等等
部分功能如下:
- ndarray:一个具有矢量算术运算和复杂广播能力的快速且节省空间的多维数组
- 用于对整组数据进行快速运算的标准数学函数(无需编写循环)
- 用于读写磁盘数据的工具以及用于操作内存映射文件的工具
- 线性代数、随机数生成以及傅立叶变换功能
- 用于集成由C、C++、Fortran等语言编写的代码的API
2.2 ndarray
Numpy数组(ndarray)的核心特性
- 多维性:支持0维(标量)、1维(向量)、2维(矩阵)及更高维数组
- 同质性:所有元素类型必须一致(通过dtype指定)
- 高效性:基于连续内存块存储,支持向量化运算(如果有不同数据类型会被强制转换为相同数据类型)
import numpy as np

# 创建数组
a = np.array([1, 2, 3])

# 创建多维数组
b = np.array([[1, 2, 3], [4, 5, 6]])

def getF(a):
    return a, a.ndim, a.dtype

print(getF(a)) # (array([1, 2, 3]), 1, dtype('int64'))
print(getF(b)) # (array([[1, 2, 3],
       				 # [4, 5, 6]]), 2, dtype('int64'))
一、ndarray属性
- shape 数组的形状:行数和列数(或更高维度的尺寸)
- ndim 维度数量:数组是几维的(1维、2维、3维等)
- size 总元素个数:数组中所有元素的总数
- dtype 元素类型:数组中元素的类型(整数、浮点数等)
- T 转置:行变列,列变行
- itemsize 单个元素占用的内存字节数
- nbytes 数组总内存占用量:size * itemsize
- flags 内存存储方式:是否连续存储(高级优化)
二、ndarray的创建
- 基础构造:适用于手动构建小规模数组或复制已有数据
- np.array()
- np.copy()
- 预定义形状填充:用于快速初始化固定形状的数组(如全0占位、全1初始化)
- np.zeros()
- np.ones()
- np.empty()
- np.full()
- 基于数值范围生成:生成数值序列,常用于模拟时间序列、坐标网格等
- np.arange()
- np.linspace()
- np.logspace()
- 特殊矩阵生成:数学运算专用(如线性代数中的单位矩阵)
- np.eye() 单位矩阵
- np.diag() 对角矩阵
- 随机数组生成:模拟实验数据、初始化神经网络权重等场景
- np.random.rand() 均匀分布
- np.random.randn() 正态分布
- np.random.randint() 随机整数
- 随机种子 np.random.seed()
- 高级构造方法:处理非结构化数据(如文件、字符串)或通过函数生成复杂数组
- np.array()
- np.loadtxt()
- np.fromfunction()
| 名称 | 维度 | 示例 | 备注 |
|---|---|---|---|
| 标量 | 0维 | 5, 3.14 | 单个数字、无行列 |
| 向量 | 1维 | [1, 2, 3] | 只有行或列(一维数组) |
| 矩阵 | 2维 | [[1, 2], [3, 4]] | 严格的行列结构(二维表) |
| 张量 | >=3维 | [[[1, 2], [3, 4]]] | 高阶数组(如RGB图像) |
矩阵是一个由 行(row) 和 列(column)排列成的矩阵数组
形状(shape) 这个矩阵有2行3列,记作2 x 3矩阵
元素(entry) 矩阵中的每个数字称为元素
$$
零矩阵 所有元素为0
\begin{bmatrix}
0 & 0\
0 & 0\
\end{bmatrix}
$$
$$
单位矩阵 对角线上为1,其余为0
\begin{bmatrix}
1 & 0\
0 & 1\
\end{bmatrix}
$$
$$
对角矩阵 只有对角线有非0值
\begin{bmatrix}
2 & 0\
0 & 3\
\end{bmatrix}
$$
$$
对称矩阵 A = AT
\begin{bmatrix}
1 & 2\
2 & 3\
\end{bmatrix}
$$
三、ndarray的数据类型
| 数据类型 | 说明 |
|---|---|
| bool | 布尔类型 |
| int8、uint8 int16、uint16 int32、uint32 int64、uint64 | 有符号、无符号的8位(1字节)整型 有符号、无符号的16位(2字节)整型 有符号、无符号的32位(4字节)整型 有符号、无符号的64位(8字节)整型 |
| float16 float32 float64 | 半精度浮点型 单精度浮点型 双精度浮点型 |
| complex64 complex128 | 用两个32位浮点数表示的复数 用两个64位浮点数表示的复数 |
四、索引与切片
| 索引/切片类型 | 描述/用法 |
|---|---|
| 基本索引 | 通过整数索引直接访问元素。索引从0开始 |
| 行/列切片 | 使用冒号:切片语法选择行或列的子集 |
| 连续切片 | 从起始索引到结束索引按步长切片 |
| 使用slice函数 | 通过slice(start, stop, step)定义切片规则 |
| 布尔索引 | 通过布尔条件筛选满足条件的元素,支持逻辑运算符&、| |
五、运算
# 1、算术运算
import numpy as np

a = np.array([1, 2, 3])
b = np.array([4, 5, 6])

print(a + b) 		# [5 7 9]
print(a - b) 		# [-3 -3 -3]
print(a * b) 		# [ 4 10 18]
print(a / b) 		# [0.25 0.4  0.5 ]
print(a ** b) 	# [  1  32 729]
print(a % b) 		# [1 2 3]
print(a // b) 	# [0 0 0]
print(a ** b) 	# [  1  32 729]
print(a % b) 	# [1 2 3]

# 广播机制 1、获取形状 2、是否可以广播
# 同一维度: 相同
a = np.array([1, 2, 3])
b = np.array([[4], [5], [6]])

'''a
1 2 3
1 2 3
1 2 3
b
4 4 4
5 5 5
6 6 6
'''
print(a + b)
# [[5 6 7]
#  [6 7 8]
#  [7 8 9]]

a = np.array([1, 2, 3])
b = np.array([4, 5])
print(b - a)
# 报错

# 矩阵运算
a = np.array([[1, 2, 3], [4, 5, 6], [7, 8, 9]])
b = np.array([[4, 5, 6], [7, 8, 9], [1, 2, 3]])

print(a @ b)
# [[ 21  27  33]
#  [ 57  72  87]
#  [ 93 117 141]]
2.3 Numpy常用函数
1、基本数学
- np.sqrt(x)
- np.exp(x)
- np.log(x)
- np.sin(x)
- np.abs(x)
- np.power(a, b)
- np.round(x, n)
2、统计
- np.sum(x)
- np.mean(x)
- np.median(x)
- np.std(x)
- np.var(x)
- np.min(x)/np.max(x)
- np.percentile(x, q)
3、比较
- np.greater(a, b)
- np.less(a, b)
- np.equal(a, b)
- np.logical_and(a, b)
- np.where(condition, x, y)
4、去重
- np.unique(x)
- np.in1d(a, b)
5、排序
- np.sort(x)
- x.sort()
- np.argsort(x)
- np.lexsort(keys)
6、其他
- np.concatenate((a, b))
- np.split(x, indices)
- np.reshape(x, shape)
- np.copy(x)
- np.isnan(x)
# 计算指数
print(np.exp(1)) # 2.718281828459045

# 计算自然对数
print(np.log(math.e)) # 1.0

# 计算正弦值、余弦值
print(np.sin(np.pi / 2)) # 1.0
print(np.cos(np.pi / 2)) # 6.123233995736766e-17
print(np.isclose(np.cos(np.pi / 2), 0)) # True

# 计算绝对值
arr = np.array([-1, 1, 2, -3])
print(np.abs(arr)) # [1 1 2 3]

# 计算a的b次幂
print(np.power(arr, 2)) # [1 1 4 9]

# 四舍五入
print(np.round([3.2, 3.7, 4.5, 5.8])) # [3. 4. 4. 6.]

# 向上取整,向下取整
arr = np.array([1.6, 25.1, 81.7])
print(np.ceil(arr)) # [ 2. 26. 82.]
print(np.floor(arr)) # [ 1. 25. 81.]

# 检测缺失值 NaN
print(np.isnan([1, 2, np.nan, 3])) # [False False  True False]
2、统计函数
求和、计算平均值、计算中位数、标准差、方差
查找最大值、最小值
计算分位数、累积和、累积积
arr = np.random.randint(1, 20, 8)
print(arr) # [ 7 14  4 13 15 14 17 17]

# 求和
print(np.sum(arr)) # 101

# 计算平均值
print(np.mean(arr)) # 12.625

# 计算中位数
print(np.median(arr)) # 14.0

# 计算标准差、方差
print(np.std(arr)) # 19.234375
print(np.var(arr)) # 4.3857011982122085

# 计算最大值、最小值 及索引位置
print(np.max(arr), np.argmax(arr)) # 17 6
print(np.min(arr), np.argmin(arr)) # 4 2

# 计算分位数, 50就是中位数,代表百分比
print(np.percentile(arr, 80)) # 16.200000000000003

# 累计和、累积积
print(np.cumsum(arr)) # [  7  21  25  38  53  67  84 101]
print(np.cumprod(arr)) # [        7        98       392      5096     76440   1070160  18192720   309276240]
3、比较函数
比较是否大于、小于、等于
逻辑与、或、非
检查数组中是否有一个True,是否所有的都为True
自定义条件
# 是否大于
print(np.greater([3, 4, 5, 6 ,7], 4)) # [False False  True  True  True]

# 是否小于
print(np.less([3, 4, 5, 6 ,7], 4)) # [ True False False False False]

# 是否等于
print(np.equal([3, 4, 5, 6 ,7], 4)) # [False  True False False False]
print(np.equal([3, 4, 5], [4, 4, 4])) # [False  True False]

# 逻辑与 或 非
print(np.logical_and([0, 0], [1, 1])) # [False False]
print(np.logical_or([0, 0], [1, 1])) # [ True  True]
print(np.logical_not([1, 0])) # [False  True]

# 检查元素是都至少有一个元素为True
print(np.any([0, 1, 0, 1, 1])) # True
# 检查是否全部元素为True
print(np.all([1, 1])) # True

# 自定义条件
# print(np.where(条件, 符合条件的, 不符合条件的))
arr = np.array([1, 2, 3, 4, 5])
print(np.where(arr > 3, arr, 0)) # [0 0 0 4 5]

# 嵌套
score = np.random.randint(50, 100, 20)
print(score)

print(np.where(
    score < 60, '不及格', np.where(
        score < 80, '良好', '优秀'
    )
))
# [89 83 76 93 80 84 63 94 84 62 89 75 99 65 51 66 99 65 89 92]
# ['优秀' '优秀' '良好' '优秀' '优秀' '优秀' '良好' '优秀' '优秀' '良好' '优秀' '良好' '优秀' '良好'
# '不及格' '良好' '优秀' '良好' '优秀' '优秀']

# np.select(条件, 返回的结果)
print(np.select([score > 80, (score >= 60) & (score <= 80), score < 60],
                ['优秀', '良好', '不及格'],
                default='未知'))
# ['不及格' '优秀' '不及格' '良好' '不及格' '良好' '良好' '优秀' '不及格' '优秀' '良好' '优秀' '良好' '优秀'
# '优秀' '良好' '良好' '良好' '良好' '优秀']
4、排序函数
# sort
np.random.seed(0)
arr = np.random.randint(1, 100, 20)
print(arr) # [45 48 65 68 68 10 84 22 37 88 71 89 89 13 59 66 40 88 47 89]
print(np.sort(arr)) # [10 13 22 37 40 45 47 48 59 65 66 68 68 71 84 88 88 89 89 89]
print(np.argsort(arr)) # [ 5 13  7  8 16  0 18  1 14  2 15  3  4 10  6 17  9 11 12 19]
print(arr) # [45 48 65 68 68 10 84 22 37 88 71 89 89 13 59 66 40 88 47 89]

# 去重
print(np.unique(arr)) # [10 13 22 37 40 45 47 48 59 65 66 68 71 84 88 89]

# 数组的拼接
arr1 = np.array([1, 2, 3])
arr2 = np.array([4, 5, 6])
print(arr1 + arr2) # [5 7 9]
print(np.concatenate((arr1, arr2))) # [1 2 3 4 5 6]

# 数组的分割
print(np.split(arr, 4))
# [array([45, 48, 65, 68, 68]), array([10, 84, 22, 37, 88]), array([71, 89, 89, 13, 59]), array([66, 40, 88, 47, 89])]

print(np.split(arr, [6, 12, 18]))
# [array([45, 48, 65, 68, 68, 10]), array([84, 22, 37, 88, 71, 89]), array([89, 13, 59, 66, 40, 88]), array([47, 89])]

# 调整数组的形状
print(np.reshape(arr, [4, 5]))
# [[45 48 65 68 68]
# [10 84 22 37 88]
# [71 89 89 13 59]
# [66 40 88 47 89]]
第三章 Pandas数据处理
3.1 Pandas简介
Pandas是Python数据分析工具链中最核心的库,充当数据读取、清洗、分析、统计、输出的高效工具
Pandas提供了易于使用的数据结构和数据分析工具,特别适用于处理结构化数据,如表格型数据
Pandas是基于NumPy构建的专门为处理表格和混杂数据设计的Python库,核心设计理念包括:
- 标签化数据结构:提供带标签的轴
- 灵活处理缺失数据:内置NaN处理机制
- 智能数据对齐:自动按标签对齐数据
- 强大IO工具:支持从CSV、Excel、SQL等20+数据源读写
- 时间序列处理:原生支持日期时间处理和频率转换
| 特性 | Series | DataFrame |
|---|---|---|
| 维度 | 一维 | 二维 |
| 索引 | 单索引 | 行索引 + 列名 |
| 数据存储 | 同质化数据类型 | 各列可不同数据类型 |
| 类比 | Excel单列 | 整张Excel工作表 |
| 创建方式 | pd.Series([1, 2, 3]) | pd.DataFrame({‘col’: [1, 2, 3]}) |
3.2 核心数据结构 Series
- Series Index
- Series Name
- Series Values
1、创建方法
import pandas as pd

s = pd.Series([1, 2, 3, 4, 5])
print(s)
# 0    1
# 1    2
# 2    3
# 3    4
# 4    5
# dtype: int64

# 自定义索引
s = pd.Series([1, 2, 3, 4, 5], index=['A', 'B', 'C', 'D', 'E'])
print(s)
# A    1
# B    2
# C    3
# D    4
# E    5
# dtype: int64

# 定义name
s = pd.Series([1, 2, 3, 4, 5], index=['A', 'B', 'C', 'D', 'E'], name = '月份')
print(s)
# A    1
# B    2
# C    3
# D    4
# E    5
# Name: 月份, dtype: int64

# 通过字典的方式创建
s = pd.Series({'a': 1, 'b': 2, 'c': 3, 'd': 4, 'e': 5})
print(s)
# a    1
# b    2
# c    3
# d    4
# e    5
# dtype: int64

s1 = pd.Series(s, index=['a', 'c'])
print(s1)
# a    1
# c    3
# dtype: int64
2、属性
| 属性 | 说明 | 属性 | 说明 |
|---|---|---|---|
| index | Series的索引对象 | loc[] | 显式索引,按标签索引或切片 |
| values | Series的值 | iloc[] | 隐式索引,按位置索引或切片 |
| dtype或dtypes | Series的元素类型 | at[] | 使用标签访问单个元素 |
| shape | Series的形状 | iat[] | 使用位置访问单个元素 |
| ndim | Series的维度 | ||
| size | Series的元素个数 | ||
| name | Series的名称 |
3、访问数据
# 访问数据
print(s[1]) # 2
print(s['c']) # 3
print(s[s < 3])
# a    1
# b    2
# dtype: int64

print(s.head()) # 前5行数据
print(s.tail()) # 末尾5行数据
4、常用方法
| 方法 | 说明 | 方法 | 说明 |
|---|---|---|---|
| head() | 查看前n行数据,默认5行 | max() | 最大值 |
| tail() | 查看后n行数据,默认5行 | var() | 方差 |
| isin() | 判断元素是否包含在参数集合中 | std() | 标准差 |
| isna() | 判断是否为缺失值(如NaN或None) | median() | 中位数 |
| sum() | 求和,自动忽略缺失值 | mode() | 众数(可返回多个) |
| mean() | 平均值 | qiantile(q) | 分位数,q取0~1之间 |
| min() | 最小值 | describe() | 常见统计信息(count、mean、std、min、25%、50%、75%、max) |
| value_counts() | 每个唯一值的出现次数 | sort_values() | 按值排序 |
| count() | 非缺失值数量 | replace() | 替换值 |
| nunique() | 唯一值个数(去重) | keys() | 返回Series的索引对象 |
| unique() | 获取去重后的值数组 | sample() | 随机抽样 |
| drop_duplicates() | 去除重复项 | sort_index() | 按索引排序 |
- 收益率
import pandas as pd
prices = pd.Series([102.3, 103.5, 105.1, 104.8, 106.2, 107.0, 106.5, 108.1, 109.3, 110.2],
                   index=pd.date_range('2025-01-01', periods=10))

print(prices.pct_change())
# 2025-01-01         NaN
# 2025-01-02    0.011730
# 2025-01-03    0.015459
# 2025-01-04   -0.002854
# 2025-01-05    0.013359
# 2025-01-06    0.007533
# 2025-01-07   -0.004673
# 2025-01-08    0.015023
# 2025-01-09    0.011101
# 2025-01-10    0.008234
# Freq: D, dtype: float64
3.3 核心数据结构 DataFrame
1、创建方法
# 通过series创建
s1 = pd.Series([1, 2, 3, 4, 5])
s2 = pd.Series([6, 7, 8, 9, 10])
df = pd.DataFrame({"第一列": s1, "第二列": s2})
#    第一列  第二列
# 0    1    6
# 1    2    7
# 2    3    8
# 3    4    9
# 4    5   10

# 通过字典来创建
df = pd.DataFrame(
    {
        "name": ['tom', 'jack', 'alice', 'bob', 'allen'],
        "age": [15, 17, 20, 26, 30],
        "score": [60.5, 80, 30.6, 70, 83.5]
    }, index = [1, 2, 3, 4, 5], columns = ["name", "age", "score"]
)
#     name  age  score
# 1    tom   15   60.5
# 2   jack   17   80.0
# 3  alice   20   30.6
# 4    bob   26   70.0
# 5  allen   30   83.5
2、属性
| 属性 | 说明 | 属性 | 说明 |
|---|---|---|---|
| index | DataFrame的行索引 | loc[] | 显式索引,按行列标签索引或切片 |
| values | DataFrame的值 | iloc[] | 隐式索引,按行列位置索引或切片 |
| dtypes | DataFrame的元素类型 | at[] | 使用行列标签访问单个元素 |
| shape | DataFrame的形状 | iat[] | 使用行列位置访问单个元素 |
| ndim | DataFrame的维度 | T | 行列转置 |
| size | DataFrame的元素个数 | ||
| columns | DataFrame的列标签 |
3、访问数据
# 获取单列数据
print(df['name'])
# 1      tom
# 2     jack
# 3    alice
# 4      bob
# 5    allen
# Name: name, dtype: object

# 获取多列数据
print(df[['name', 'score']])
#     name  score
# 1    tom   60.5
# 2   jack   80.0
# 3  alice   30.6
# 4    bob   70.0
# 5  allen   83.5

# 查看部分数据
print(df.tail(3))
print(df[df.score > 70])
#     name  age  score
# 3  alice   20   30.6
# 4    bob   26   70.0
# 5  allen   30   83.5

#     name  age  score
# 2   jack   17   80.0
# 5  allen   30   83.5

# 随机抽样 df.sample() 默认取一条
print(df.sample(2))
#     name  age  score
# 5  allen   30   83.5
# 2   jack   17   80.0
4、常用方法
| 方法 | 说明 | 方法 | 说明 |
|---|---|---|---|
| head() | 查看前n行数据,默认5行 | max() | 最大值 |
| tail() | 查看后n行数据,默认5行 | var() | 方差 |
| isin() | 判断元素是否包含在参数集合中 | std() | 标准差 |
| isna() | 判断是否为缺失值(如NaN或None) | median() | 中位数 |
| sum() | 求和,自动忽略缺失值 | mode() | 众数(可返回多个) |
| mean() | 平均值 | quantile(q) | 分位数, q取0~1之间 |
| min() | 最小值 | describe() | 常见统计信息(count、mean、std、min、25%、50%、75%、max) |
| value_counts() | 每个唯一值的出现次数 | sort_values() | 按值排序 |
| count() | 非缺失值数量 | replace() | 替换值 |
| duplicated() | 是否重复 | nlargest() | 返回某列最大的n条数据 |
| drop_duplicates() | 去除重复项 | nsmallest() | 返回某列最小的n条数据 |
| sample() | 随机抽样 | ||
| replace() | 替换值 | ||
| sort_index() | 按索引排序 |
3.4 数据分析
3.4.1 数据导入导出
# 导入
file_path = '../data/a.csv'

# 手动设定为 gb18030
df = pd.read_csv(file_path, encoding='gb18030')
print(df)
print(type(df))
print(df.tail())
print(df.居民消费价格指数.mean())

# 导出
df = df.tail()
df.to_csv('../data/new.csv')

日期  居民消费价格指数  食品烟酒类居民消费价格指数  衣着类居民消费价格指数  居住类居民消费价格指数  生活用品及服务类居民消费价格指数  交通和通信类居民消费价格指数  教育文化和娱乐类居民消费价格指数  ...  进出口差额当期值(千美元)  进出口差额累计值(千美元)   房地产股票成交量  房地产股票成交金额  房地产股票成交总市值   房地产股票流通市值        房价  Unnamed: 26
0   2022/8/22       NaN            NaN          NaN          NaN               NaN             NaN               NaN  ...            NaN            NaN    7710101   22171554  2373809244  2373809244  57597元/㎡     57597元/㎡
1   2022/7/22     101.9          102.5        100.9        100.6             100.8           106.6             101.2  ...    101267263.0    482299580.0   15625022   47609385  2514909793  2514909793  56059元/㎡     56059元/㎡
2   2022/6/22     101.8          102.0        100.9        100.8             100.6           106.7             101.5  ...     97940000.0    385440000.0   16592600   50186012  2514909793  2514909793  53552元/㎡     53552元/㎡
3   2022/5/22     101.7          101.6        100.8        101.0             100.3           106.1             101.5  ...     78750000.0    290460000.0   42309498  126100275  2481709664  2481709664  50136元/㎡     50136元/㎡
4   2022/4/22     101.6          100.8        100.8        101.2             100.0           106.0             101.7  ...     51120000.0    212930000.0  111967542  435194959  3303412863  3303412863  47135元/㎡     47135元/㎡
..        ...       ...            ...          ...          ...               ...             ...               ...  ...            ...            ...        ...        ...         ...         ...       ...          ...
75  2022/5/16     102.0          104.7        101.5        101.6             100.6            97.4             101.2  ...     49979506.0    217497631.0   11385855   59587043  4382417065  4382417065  59659元/㎡     59659元/㎡
76  2022/4/16     102.3          105.9        101.5        101.4             100.5            97.6             101.2  ...     45557603.0    171041773.0   21244325  104936580  4158316192  4158316192  59076元/㎡     59076元/㎡
77  2022/3/16     102.3          106.0        101.5        101.3             100.4            97.4             101.2  ...     29856925.0    125725937.0   20008614   94164575  3950815384  3950815384  58941元/㎡     58941元/㎡
78  2022/2/16     102.3          105.8        101.6        101.3             100.3            98.4             100.9  ...     32592484.0     95894192.0    6686454   28775494  3527513736  3527513736  58657元/㎡     58657元/㎡
79  2022/1/16     101.8          103.6        101.9        101.4             100.6            98.4             101.7  ...     63286844.0     63286844.0   17630423  103453240  4606517938  4606517938  58993元/㎡     58993元/㎡

[80 rows x 27 columns]
<class 'pandas.core.frame.DataFrame'>
           日期  居民消费价格指数  食品烟酒类居民消费价格指数  衣着类居民消费价格指数  居住类居民消费价格指数  生活用品及服务类居民消费价格指数  交通和通信类居民消费价格指数  教育文化和娱乐类居民消费价格指数  ...  进出口差额当期值(千美元)  进出口差额累计值(千美元)  房地产股票成交量  房地产股票成交金额  房地产股票成交总市值   房地产股票流通市值        房价  Unnamed: 26
75  2022/5/16     102.0          104.7        101.5        101.6             100.6            97.4             101.2  ...     49979506.0    217497631.0  11385855   59587043  4382417065  4382417065  59659元/㎡     59659元/㎡
76  2022/4/16     102.3          105.9        101.5        101.4             100.5            97.6             101.2  ...     45557603.0    171041773.0  21244325  104936580  4158316192  4158316192  59076元/㎡     59076元/㎡
77  2022/3/16     102.3          106.0        101.5        101.3             100.4            97.4             101.2  ...     29856925.0    125725937.0  20008614   94164575  3950815384  3950815384  58941元/㎡     58941元/㎡
78  2022/2/16     102.3          105.8        101.6        101.3             100.3            98.4             100.9  ...     32592484.0     95894192.0   6686454   28775494  3527513736  3527513736  58657元/㎡     58657元/㎡
79  2022/1/16     101.8          103.6        101.9        101.4             100.6            98.4             101.7  ...     63286844.0     63286844.0  17630423  103453240  4606517938  4606517938  58993元/㎡     58993元/㎡

[5 rows x 27 columns]
101.72278481012657
3.4.2 缺失值的处理
# 缺失值处理
s = pd.Series([1, 2, np.nan, None, pd.NA])
print(s)
# 0       1
# 1       2
# 2     NaN
# 3    None
# 4    <NA>
# dtype: object

# 查看是否是缺失值
print(s.isna())
print(s.isnull())
# 0    False
# 1    False
# 2     True
# 3     True
# 4     True
# dtype: bool

df = pd.DataFrame([[1, pd.NA, 2], [2, 3, 5], [None, 4, 6]])
print(df)
#      0     1  2
# 0  1.0  <NA>  2
# 1  2.0     3  5
# 2  NaN     4  6

print(df.isna())
print(df.isnull())
#        0      1      2
# 0  False   True  False
# 1  False  False  False
# 2   True  False  False

print(df.isna().sum()) # 列
# 0    1
# 1    1
# 2    0
# dtype: int64

# 剔除缺失值
print(s.dropna())
# 0    1
# 1    2
# dtype: object

print(df.dropna()) # 剔除一整条记录
print(df.dropna(how = 'all')) # 如果所有值都是缺失值, 删除这一行
print(df.dropna(thresh = 2)) # 如果至少有n个值不是缺失值, 就保留
print(df.dropna(axis = 1)) # 剔除一整列的记录
print(df.dropna(subset = ['第一列'])) # 如果某列有缺失值,则删除这一行

# 填充缺失值
# 使用字典来填充
print(df.fillna({'列名': '值'}).tail())
# 使用统计值来填充
print(df.fillna(df[['列名']].mean()).tail())
# 用前面的相邻值填充
print(df.ffill().tail())
# 用后面的相邻值填充
print(df.bfill().tail())
3.4.4 重复数据处理
data = {
    "name": ['alice', 'alice', 'bob', 'alice', 'jack', 'bob'],
    "age": [26, 25, 30, 25, 35, 30],
    "city": ['NY', 'NY', 'LA', 'NY', 'SF', 'LA']
}

df = pd.DataFrame(data)
print(df)
#     name  age city
# 0  alice   26   NY
# 1  alice   25   NY
# 2    bob   30   LA
# 3  alice   25   NY
# 4   jack   35   SF
# 5    bob   30   LA

# 一整条记录都是一样的, 标记为重复, 返回True
print(df.duplicated())
# 0    False
# 1    False
# 2    False
# 3     True
# 4    False
# 5     True
dtype: bool

# 去除重复
print(df.drop_duplicates())
#     name  age city
# 0  alice   26   NY
# 1  alice   25   NY
# 2    bob   30   LA
# 4   jack   35   SF

# 根据某个字段去重
print(df.drop_duplicates(subset=['name']))
#     name  age city
# 0  alice   26   NY
# 2    bob   30   LA
# 4   jack   35   SF
3.4.5 数据类型转换
df['age'] = df['age'].astype('int16')
df['gender'] = df['gender'].astype('category')

df['is_male'] = df['gender'].map({'Female': True, 'Male': False})
3.4.6 数据变形
data = {
    'ID': [1, 2],
    'name': ['alice', 'bob'],
    'Math': [90, 85],
    'English': [88, 92],
    'Science': [95, 89]
}

df = pd.DataFrame(data)
df.T # 行列转置
print(df)

#    ID   name  Math  English  Science
# 0   1  alice    90       88       95
# 1   2    bob    85       92       89

# 宽表转换成长表
df = pd.melt(df, id_vars = ['ID', 'name'], var_name = '科目', value_name = '分数')
df = df.sort_values('name')
print(df)
#    ID   name       科目  分数
# 0   1  alice     Math  90
# 2   1  alice  English  88
# 4   1  alice  Science  95
# 1   2    bob     Math  85
# 3   2    bob  English  92
# 5   2    bob  Science  89

# 长表转换成宽表
df = pd.pivot(df, index = ['ID', 'name'], columns = '科目', values = '分数')
print(df)
# 科目        English  Math  Science
# ID name
# 1  alice       88    90       95
# 2  bob         92    85       89

# 分列
df[['first', 'last']] = df['name'].str.split(" ", expand = True)
3.4.7 数据分箱
# 数据分箱 pd.cut(x, bins, labels)
# bins = n, 分成n段区间, 起始值、结束值是所有数据的最大值、最小值
pd.cut(df1['salary'], bins = 2)

# bins = list, 分成n段区间
pd.cut(df1['salary'], bins = [0, 10000, 20000, 30000])
pd.cut(df1['salary'], bins = [0, 10000, 20000, 30000]).value_counts()
pd.cut(df1['salary'], bins = [0, 10000, 20000, 30000], labels = ['低', '中', '高'])

# 等频划分
pd.qcut(df['salary'], 3).value_counts()
3.4.8 时间数据处理
df['datetime'] = pd.to_datetime(df['date'])
df['datetime'].dt.day_name()

df = pd.read_csv('data/weather.csv', parse_dates = ['date'])
df.info()
df['datetime'].dt.day_name()

# 日期数据作为索引
df.set_index('date', inplace=True)
print(df.loc["2025-01" : "2025-05"])
3.4.9 分组聚合
# 分组聚合
# df.groupby('分组的字段')['聚合的字段'].聚合函数()
df.dropna(sub = ['department_id'])
df['department_id'] = df['department_id'].astype('int64')
df.groupby('department_id').groups # 查看分组
df.groupby('department_id').get_group(10) # 查看具体的某个分组数据
第四章 matplotlib 数据可视化
4.1 可视化基础
常见图表
- 柱状图
- 折线图
- 散点图
- 条形图
- 饼图
- 箱型图
数据可视化图表的构成
- 标题
- 坐标轴
- 图形要素
- 图例
- 数据标签
| 工具 | 说明 | 优点 | 缺点 |
|---|---|---|---|
| matplotlib | Python最基础可视化库 | 灵活强大、定制性强 | 代码多、风格基础 |
| seaborn | 基于matplotlib的高级接口 | 风格美观、统计图方便 | 对简单图略繁琐 |
| pandas plot | 快速图表,调用.plot() | 快捷、适合EDA | 图表样式较少 |
4.2 Matplotlib
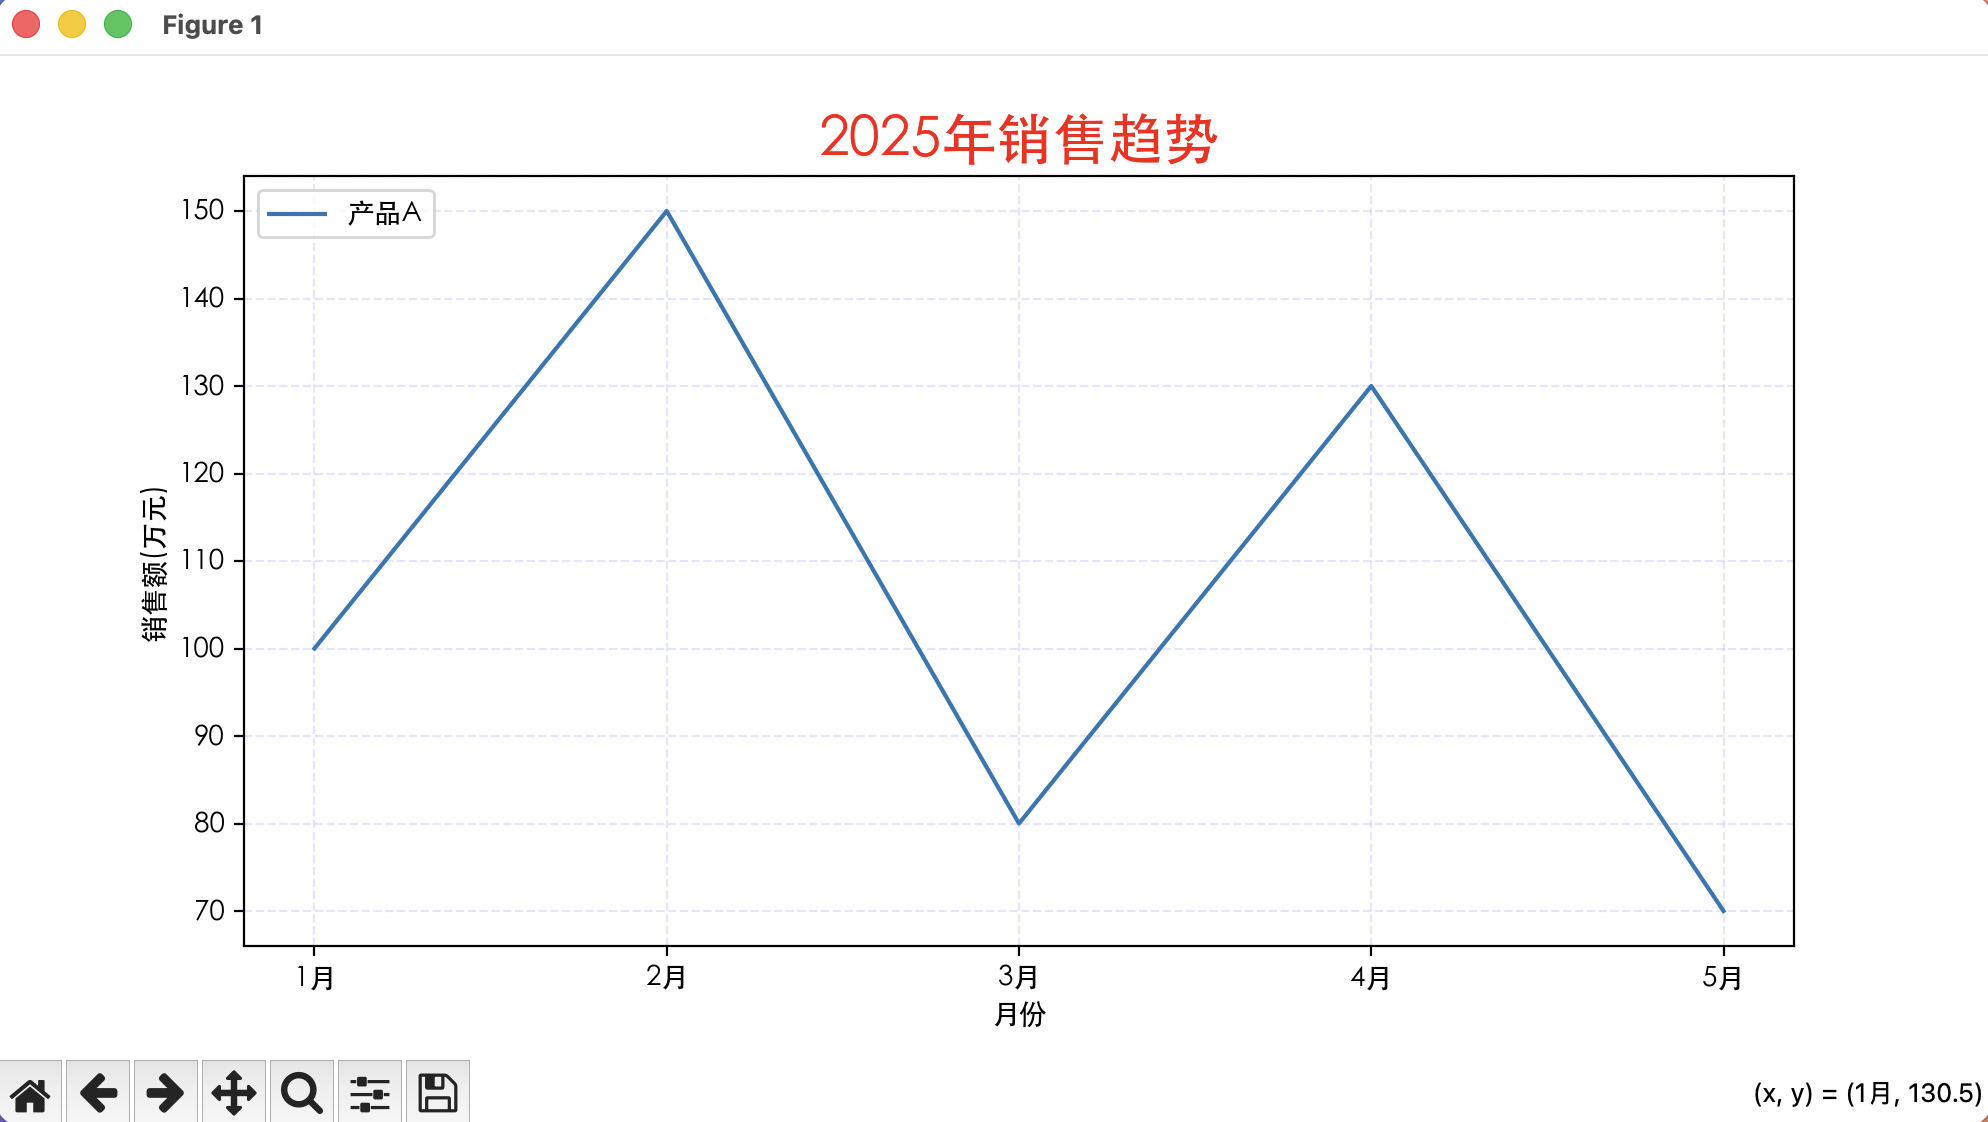
4.2.1 折线图 plot
import matplotlib.pyplot as plt # type: ignore
from matplotlib import rcParams
rcParams['font.family'] = 'STHeiti'

# 创建图表 设置大小
plt.figure(figsize = (10, 5))

# 要绘制的数据
month = ['1月', '2月', '3月', '4月', '5月']
sales = [100, 150, 80, 130, 70]

plt.plot(month, sales, label = '产品A')

# 添加标题
plt.title('2025年销售趋势', color = 'red', fontsize = 20)

# 添加坐标轴的标签
plt.xlabel('月份', fontsize = 10)
plt.ylabel('销售额(万元)', fontsize = 10)

# 添加图例
plt.legend(loc = 'upper left')

# 添加网格线
plt.grid(True, alpha = 0.1, color = 'blue', linestyle = '--')
# plt.grid(axis = 'x')
# plt.grid(axis = 'y')

# 显示图标
plt.show()

##################################################
# 设置y轴范围
plt.ylim(0, 160)

# 在每个数据点上显示数值
for x,y in zip(month, sales):
  print(x, y)
  plt.text(x, y + 1, str(y), ha = 'center', va = 'bottom', fontsize = 10)

# 添加样式
plt.plot(month, sales,
         label = '产品A',
         color = 'orange',
         linewidth = 2,
         linestyle = '--',
         marker = 'o')
4.2.2 条形图 bar
import matplotlib.pyplot as plt
from matplotlib import rcParams
rcParams['font.family'] = 'STHeiti'

# 创建图表 设置大小
plt.figure(figsize = (10, 5))

# 要绘制的数据
subjects = ['语文', '数学', '英语', '科学']
scores = [92, 99, 88, 98]

# 绘制柱状图 bar / 条形图 barh
plt.bar(subjects, scores,
        label = 'xxx',
        color = 'orange',
        width = 0.6)

# 添加标题
plt.title('2025年成绩分布', color = 'red', fontsize = 20)

# 添加坐标轴的标签
plt.xlabel('科目', fontsize = 10)
plt.ylabel('分数', fontsize = 10)

# 添加图例
plt.legend(loc = 'upper right')

# 添加网格线
plt.grid(axis = 'y', alpha = 0.1, color = 'blue', linestyle = '--')

# 设置刻度字体大小
plt.xticks(rotation = 0, fontsize = 12)
plt.yticks(rotation = 0, fontsize = 12)

# 设置y轴的范围
plt.ylim(0, 100)

# 在每个数据点上显示数值
for x, y in zip(subjects, scores):
        plt.text(x, y + 1, str(y), ha = 'center', va = 'bottom', fontsize = 10)

# 自动优化排版
plt.tight_layout()

# 显示图标
plt.show()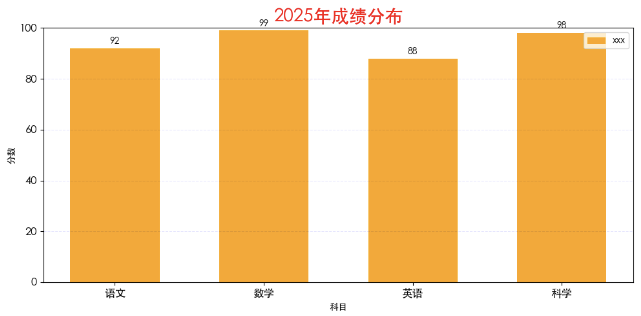
4.2.3 饼图 pie
import matplotlib.pyplot as plt
from matplotlib import rcParams
rcParams['font.family'] = 'STHeiti'

# 创建图表 设置大小
plt.figure(figsize = (10, 5))

# 要绘制的数据
things = ['学习', '娱乐', '运动', '睡觉', '其他']
times = [6, 4, 1, 8, 5]
colors = ['red', 'green', 'blue', 'yellow', 'purple']
explode = [0.1, 0, 0, 0, 0]

# 绘制饼图
plt.pie(times,
        labels = things,
        autopct='%1.1f%%',
        startangle = 90, # 设置起始角度
        colors = colors, # 设置颜色
        wedgeprops = {'width: 0.5'}, # 环形图
        explode = explode, # 设置突出块
        shadow = True # 设置阴影
       )

# 添加标题
plt.title('一天的时间分布', color = 'red', fontsize = 20)

# 自动优化排版
plt.tight_layout()

# 显示图标
plt.show()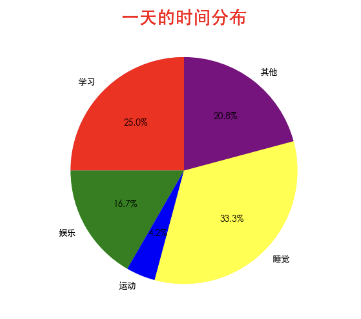
4.2.4 散点图 scatter
import matplotlib.pyplot as plt
from matplotlib import rcParams
rcParams['font.family'] = 'STHeiti'
import random

# 创建图表 设置大小
plt.figure(figsize = (10, 8))

# 要绘制的数据
x = []
y = []
for i in range(1000):
    tmp = random.uniform(0, 10)
    x.append(tmp)
    y.append(2 * tmp + random.gauss(0, 2))

# 绘制散点图
plt.scatter(x, y,
            color = 'blue',
            alpha = 0.5,
            s = 20,
            label = 'data')


# 添加标题
plt.title('X变量与Y变量的关系', color = 'red', fontsize = 20)

# 添加坐标轴的标签
plt.xlabel('X自变量', fontsize = 10)
plt.ylabel('Y自变量', fontsize = 10)

# 添加图例
plt.legend(loc = 'upper left')

# 添加网格线
plt.grid(True, alpha = 0.1, color = 'blue', linestyle = '--')

# 设置刻度字体大小
plt.xticks(rotation = 0, fontsize = 12)
plt.yticks(rotation = 0, fontsize = 12)

# 设置y轴范围
plt.ylim(0, 30)

# 自动优化排版
plt.tight_layout()

# 显示图标
plt.show()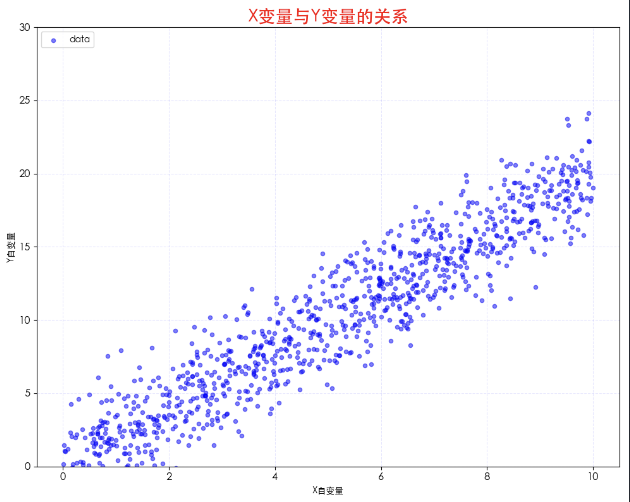
4.2.5 箱线图 boxplot
import matplotlib.pyplot as plt
from matplotlib import rcParams

rcParams['font.family'] = 'STHeiti'

data = {
    '语文': [82, 85, 88, 70, 90, 76, 84, 83, 95],
    '数学': [75, 80, 79, 93, 88, 82, 87, 89, 92],
    '英语': [70, 72, 68, 65, 78, 80, 85, 90, 95]
}

plt.figure(figsize=(8, 6))
plt.boxplot(data.values(), labels = data.keys())

plt.title("各科成绩分布(箱线图)")
plt.ylabel("分数")
plt.grid(True, axis = 'y', linestyle = '--', alpha = 0.5)
plt.show()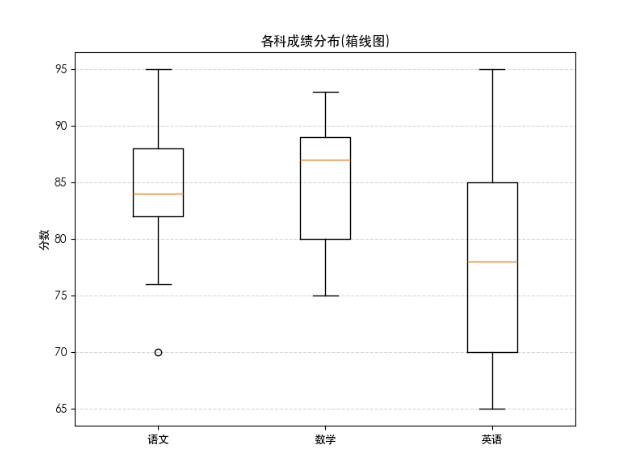
- 折线图:趋势随时间变化
- 条形图/柱状图:类别之间对比
- 饼图:整体组成比例
- 散点图:两变量相关性
- 箱线图:数据分布、异常
4.3 Seaborn
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

plt.rcParams['font.sans-serif'] = ["STHeiti"]
file_path = '../data/a.csv'

# 推荐手动设定为 gb18030
df = pd.read_csv(file_path, encoding='gb18030')
df.dropna(inplace = True)
df.info()

sns.histplot(data = df, x = "房地产股票成交量", kde = True)
plt.show()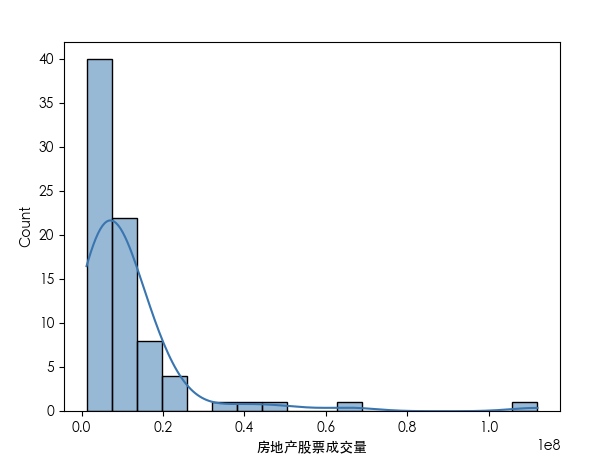
1. 导入与基础设置
import seaborn as sns
import matplotlib.pyplot as plt

sns.set_theme(style="whitegrid")  # 设置主题风格
# 常用风格:white, dark, whitegrid, darkgrid, ticks

2. 常用绘图函数
(1)散点图
	sns.scatterplot(data=df, x="col1", y="col2", hue="category", style="type", size="value")
    •	hue:按分类上色
    •	style:按分类改变点样式
    •	size:点的大小
(2)折线图
	sns.lineplot(data=df, x="time", y="value", hue="category", marker="o")
    •	marker:添加点形状
    •	适合画趋势变化
(3)柱状图(类别统计)
	sns.barplot(data=df, x="category", y="value", estimator="mean", ci="sd")
    •	estimator:统计函数(默认均值,可改为 sum、len 等)
    •	ci:置信区间("sd" 表示标准差,None 取消)
(4)计数图(频率统计)
	sns.countplot(data=df, x="category", hue="type")
    •	自动统计每个类别出现次数
(5)直方图 / 密度图
	sns.histplot(data=df, x="value", bins=20, kde=True)
	sns.kdeplot(data=df, x="value", fill=True)
		•	bins:直方图分组数
		•	kde=True:同时绘制核密度曲线
(6)箱线图 / 小提琴图
	sns.boxplot(data=df, x="category", y="value", hue="type")
	sns.violinplot(data=df, x="category", y="value", hue="type", split=True)
		•	split=True:小提琴图中按 hue 分半绘制
(7)热力图
	corr = df.corr()
	sns.heatmap(corr, annot=True, cmap="coolwarm", fmt=".2f")
		•	annot=True:显示数值
		•	fmt:数值格式化
3. 多图布局
		fig, axes = plt.subplots(1, 2, figsize=(12, 5))
		sns.histplot(data=df, x="value", ax=axes[0])
		sns.boxplot(data=df, x="category", y="value", ax=axes[1])
			•	figsize:画布大小
			•	ax:指定绘图位置
4. 配色
		sns.color_palette("pastel")   # 柔和
		sns.color_palette("deep")     # 默认深色
		sns.color_palette("coolwarm") # 冷暖渐变
	•	可配合 palette 参数使用:
		sns.barplot(data=df, x="category", y="value", palette="coolwarm")
5. 保存图片
		plt.savefig("plot.png", dpi=300, bbox_inches="tight")
			•	dpi:清晰度
			•	bbox_inches="tight":去掉多余空白