Java 八股文
Java八股文
第一章 Redis
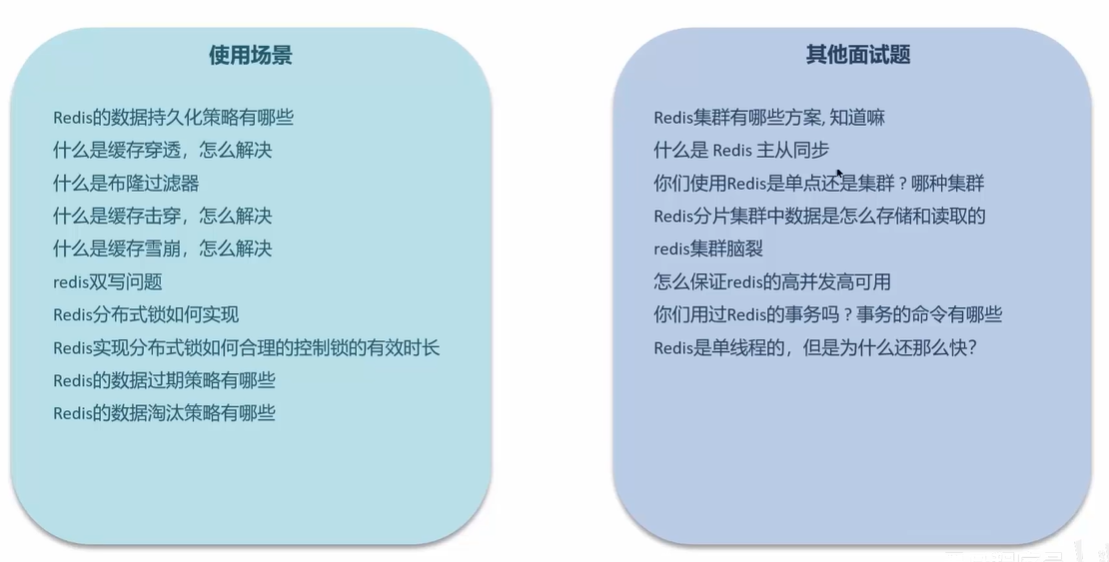
1.1redis使用场景——穿透
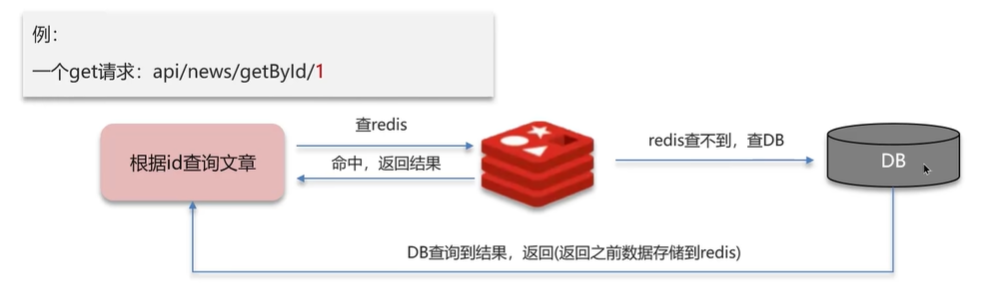
缓存穿透:查询一个不存在的数据,mysql查询不到的数据也不会写入缓存,就会导致每次请求都查询数据库
**解决方案一:**缓存空数据,查询返回的数据为空,仍把这个空结果进行缓存
优点:简单
缺点:消耗内存,可能会发生不一致的问题
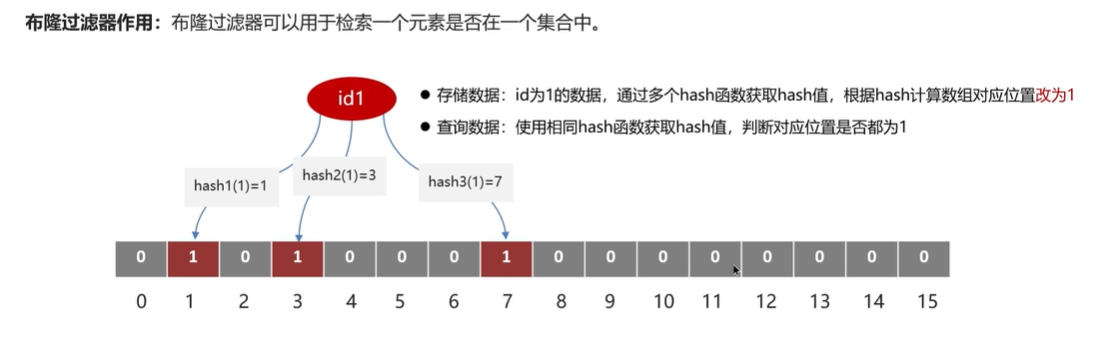
**解决方案二:**布隆过滤器
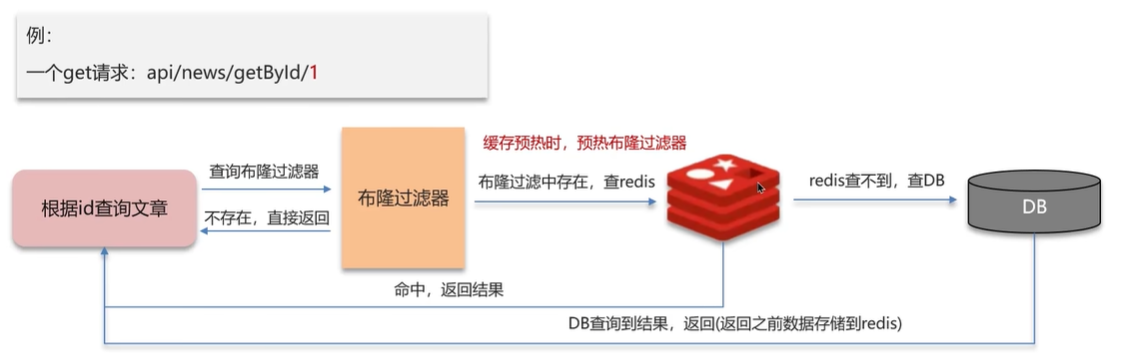
布隆过滤器
bitmap(位图):相当于是一个以(bit)位为单位的数组,数组中每个单元只能存储二进制数0或1
误判现象
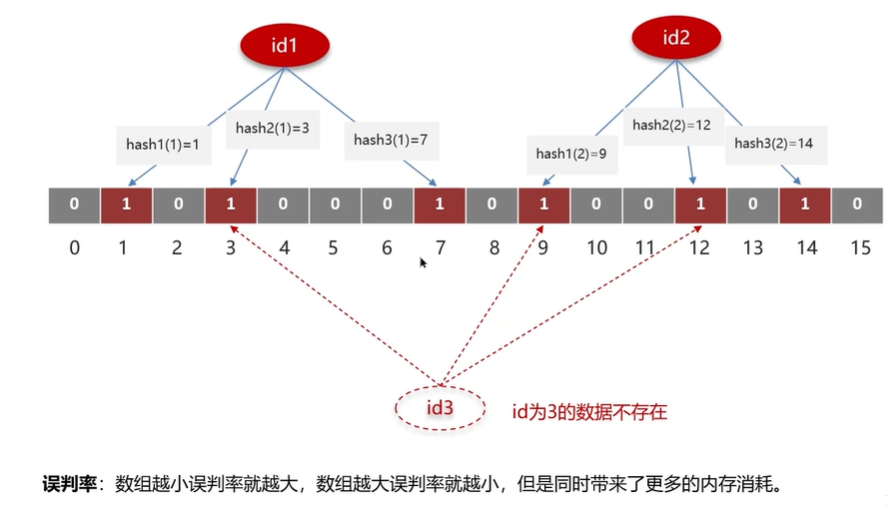
布隆过滤器的实现方案:Redisson和Guava
优点:内存占用较少,没有多余key
缺点:实现复杂,存在误判
1.2redis使用场景——击穿
**缓存击穿:**给某一个key设置了过期时间,当key过期的时候,恰好这个时间点对这个key有大量的并发请求过来,这些并发请求可能会瞬间把DB压垮
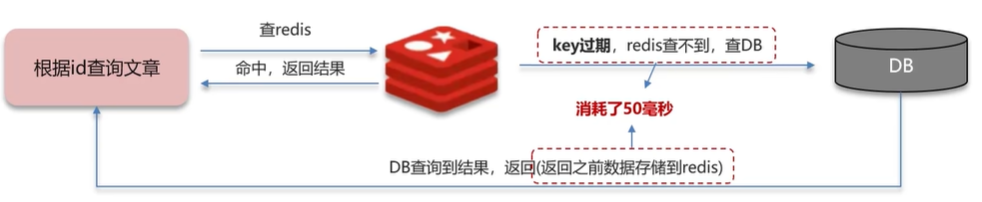
解决方案一:互斥锁
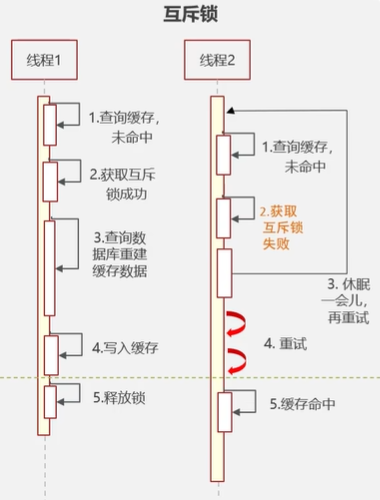
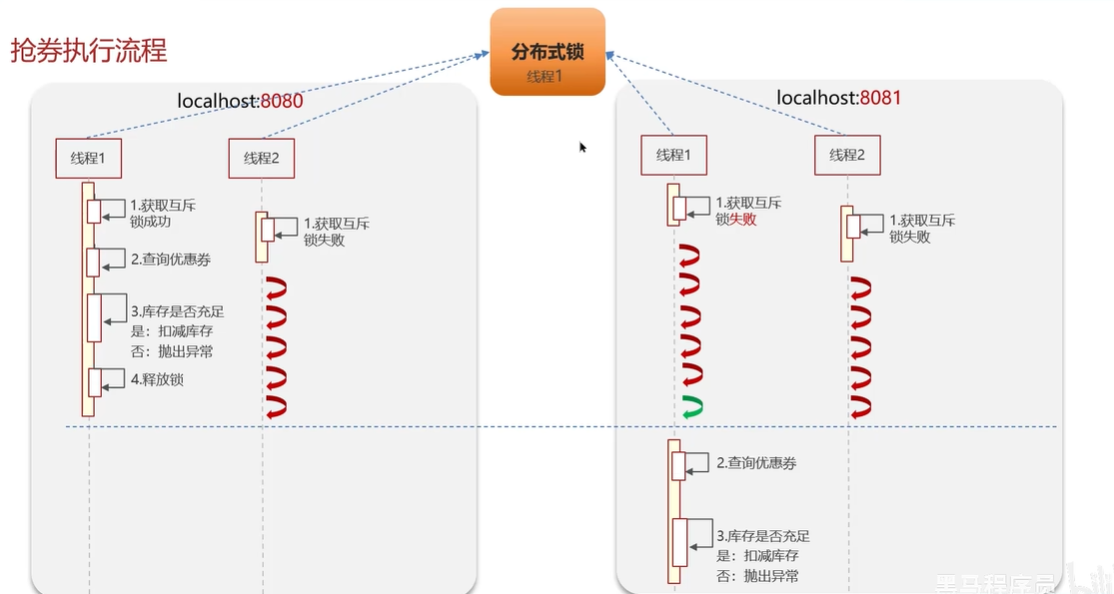
分布式锁
强一致、性能差
解决方案二:逻辑过期
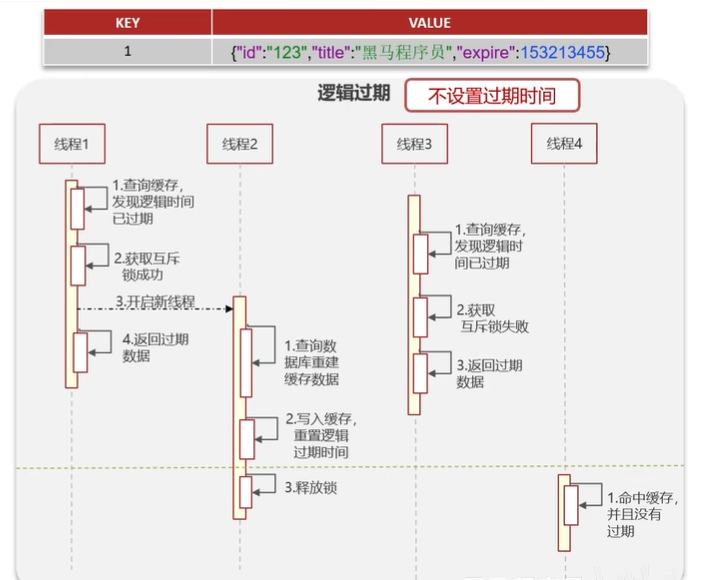
高可用、性能优、不能保证数据的绝对一致
1.3redis使用场景——雪崩
缓存雪崩是指在同一时段大量的缓存key同时失效或者Redis服务宕机,导致大量请求到达数据库,带来巨大压力
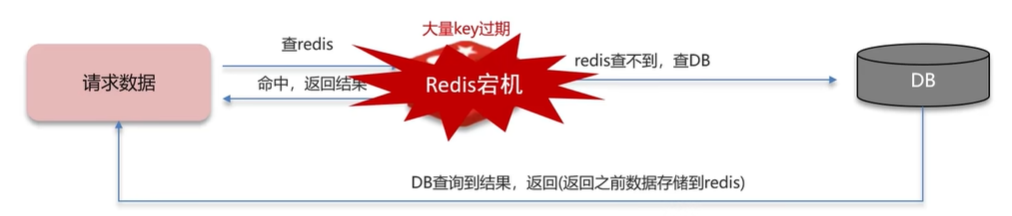
解决方案:
- 给不同的Key的TTL添加随机值
- 利用Redis集群提高服务的可用性 哨兵模式、集群模式
- 给缓存业务添加降级限流策略 ngxin或spring cloud gateway 降级可作为系统的保底策略,适用于穿透、击穿、雪崩
- 给业务添加多级缓存 Guava或Caffeine
1.4redis使用场景——双写一致性
**双写一致性:**当修改了数据库的数据也要同时更新缓存的数据,缓存和数据库的数据要保持一致
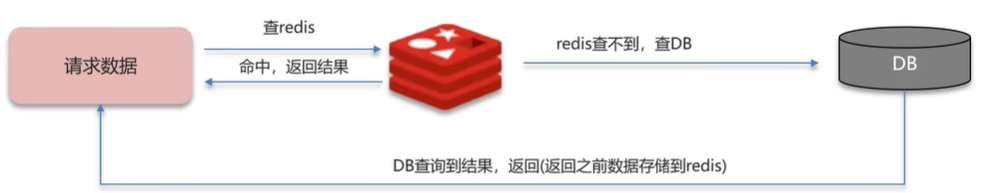
- 读操作:缓存命中,直接返回;缓存未命中,查询数据库,写入缓存,设定超时时间
- 写操作:延迟双删
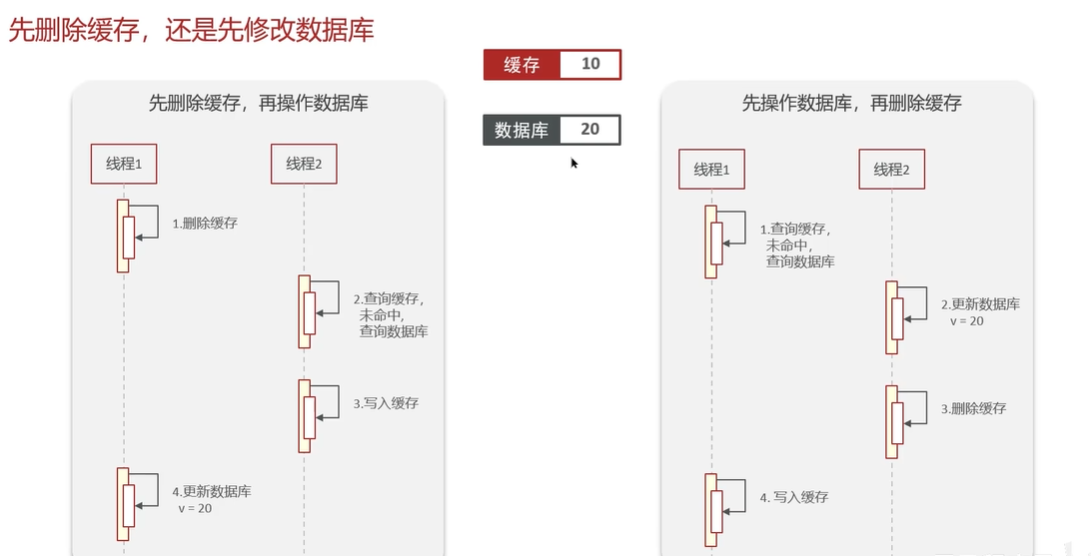
先删除缓存或者先修改数据库都会出现脏数据,而延时双删可以有效避免脏数据的产生

- 也有脏数据的风险
解决办法:
一、分布式锁
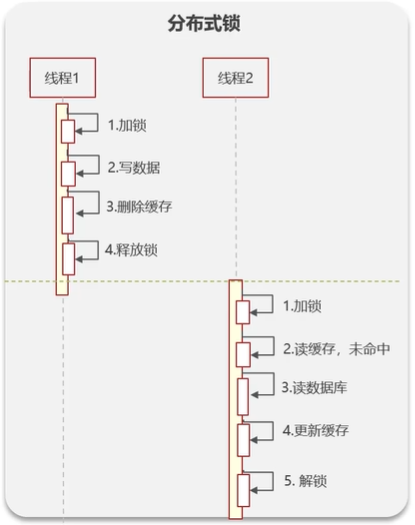
性能比较低
二、前提:存入缓存的数据大部分是读多写少
- 共享锁:读锁readLock,加锁之后,其他线程可以共享读操作
- 排他锁:也叫独占锁writeLock,加锁之后,阻塞其他线程读写操作
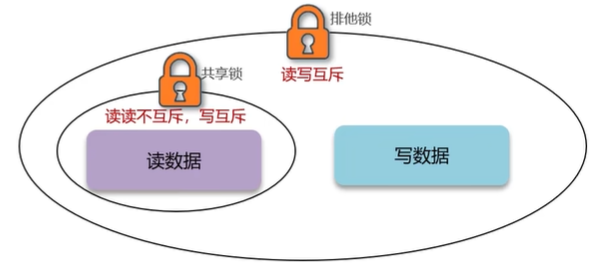
强一致、但性能低
三、异步通知保证数据的最终一致性
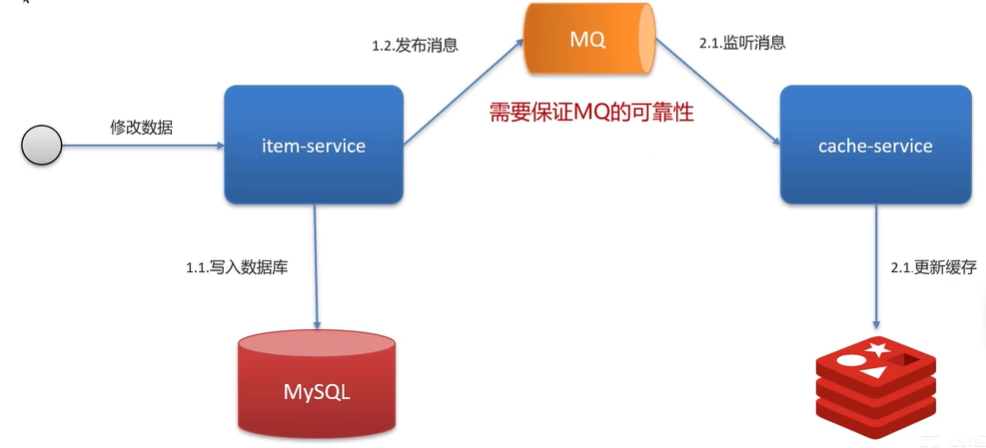
基于Canal的异步通知:
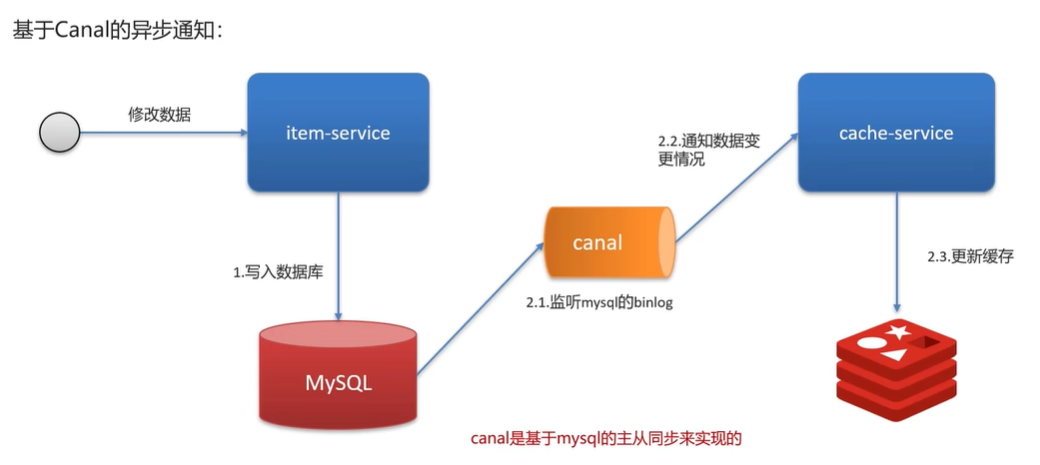
二进制日志(BINLOG)记录了所有的DDL(数据定义语言)语句和DML(数据操纵语言)语句,但不包括数据查询(SELECT/SHOW)语句
1.5redis使用场景——持久化
在Redis中提供了两种数据持久化的方式:RDB和AOF
一、RDB
RDB全称Redis Database Backup file(Redis数据备份文件),也被叫做Redis数据快照,简单来说就是把内存中的数据都记录到磁盘中,当Redis实例故障重启后,从磁盘读取快照文件,恢复数据
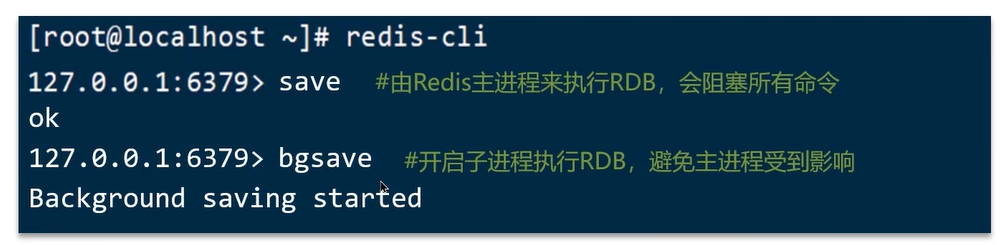
Redis内部有触发RDB的机制,可以在redis.conf文件中找到
save 900 1    #900秒内,如果至少有1个key被修改,则执行bgsave
save 300 10
save 60 10000
RDB的执行原理
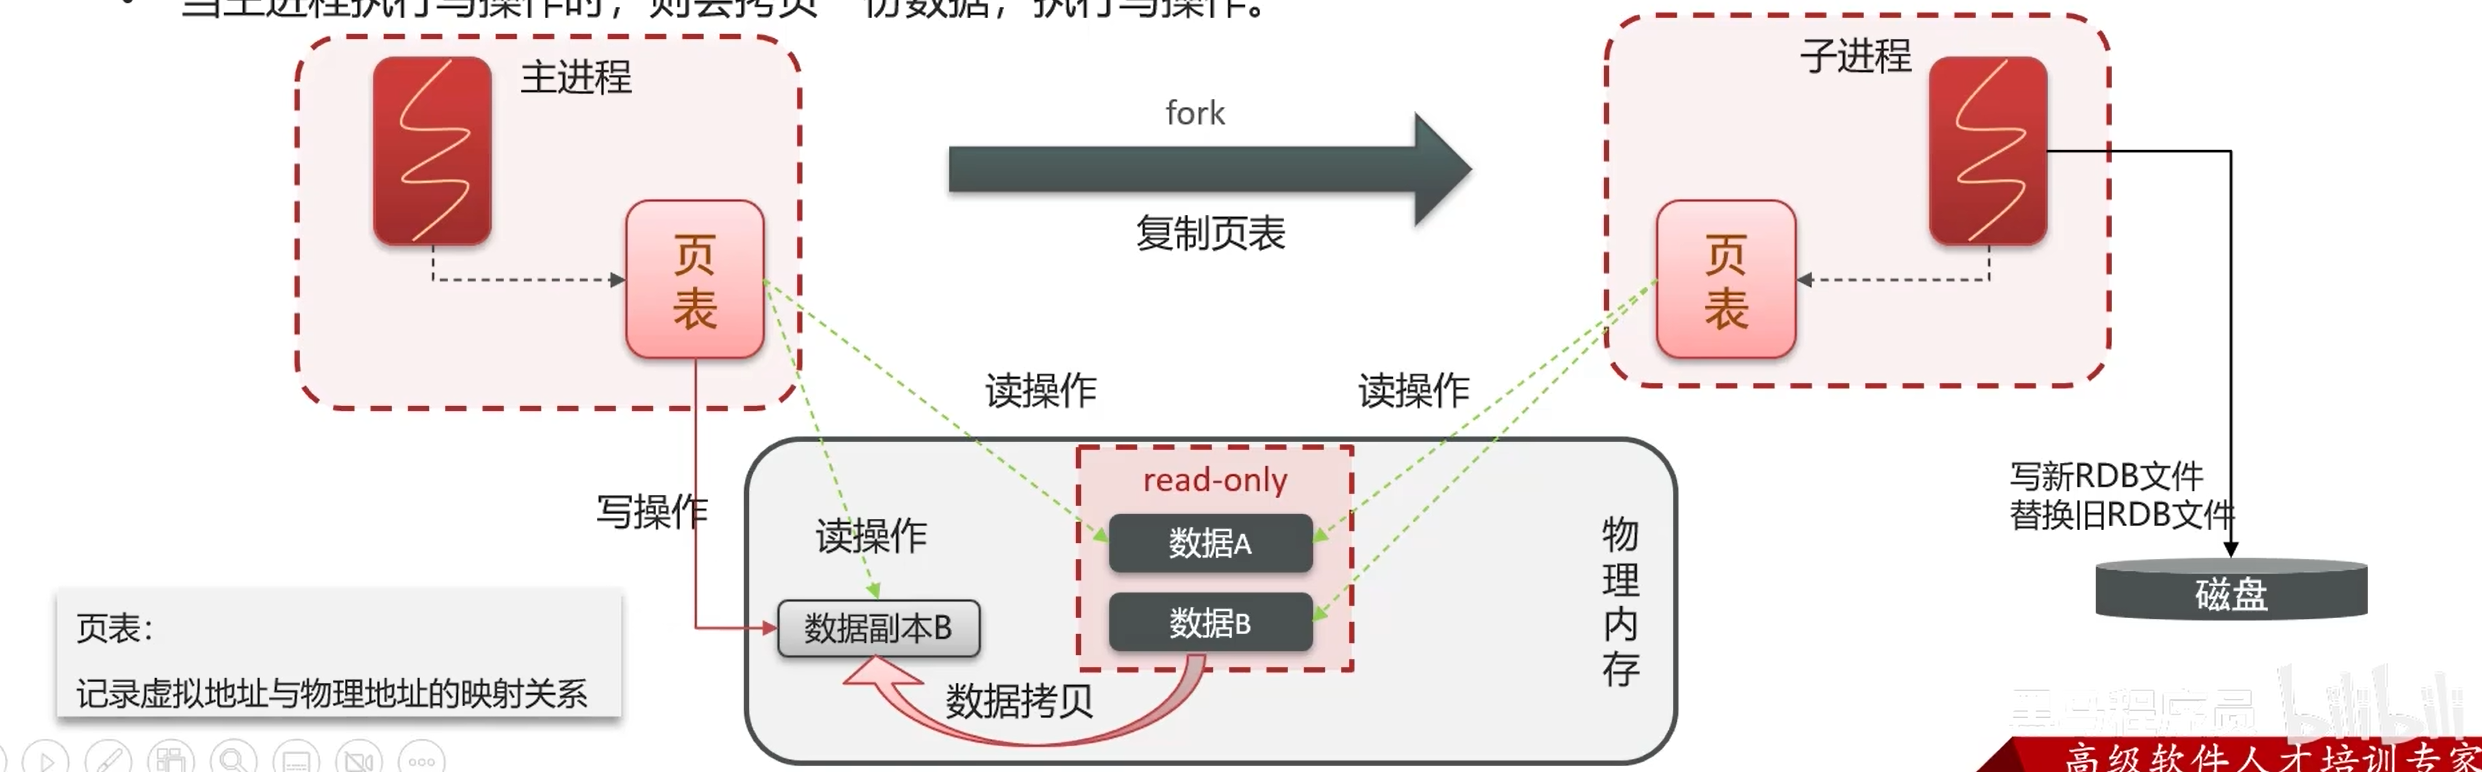
bgsave开始时会fork主进程得到子进程,子进程共享主进程的内存数据。完成fork后读取内存数据并写入RDB文件
fork采用的是copy-on-write技术:
- 当主进程执行读操作时,访问共享内存
- 当主进程执行写操作时,则会拷贝一份数据,执行写操作
AOF
AOF全称为Append Only File(追加文件)。Redis处理的每一个写命令都会记录在AOF文件,可以看做是命令日志文件
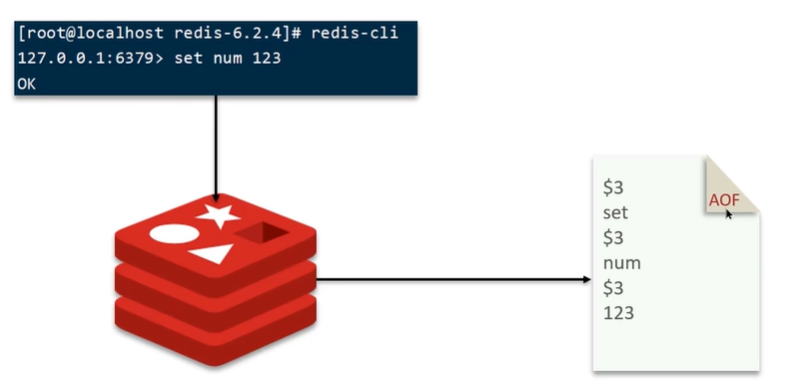
AOF默认是关闭的,需要修改redis.conf配置文件来开启AOF
#是否开启AOF功能,默认是no
appendonly yes
#AOF文件的名称
appendfilename "appendonly.aof"
AOF的命令记录频率也可以通过redis.conf来配置
#表示每执行一次写命令,立即记录到AOF文件
appendfsync always
#写命令执行完先放入AOF缓存区,然后表示每隔1秒将缓冲区数据写到AOF文件,是默认方案
appendfsync everysec
#写命令执行完先放入AOF缓存区,由操作系统决定何时将缓冲区内容写回磁盘
appendfsync no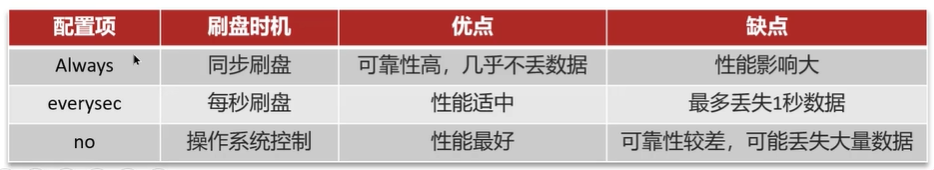
因为是记录命令,AOF文件会比RDB文件大很多。而且AOF会记录对同一个Key的多次写操作,但只有最后一次写操作才有意义。通过执行bgrewriteaof命令,可以让AOF文件执行重写功能,用最少的命令达到相同效果
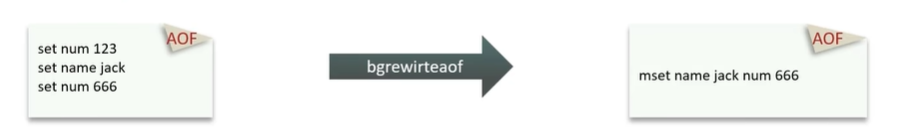
Redis也会在触发阈值时自动去重写AOF文件。阈值也可以在redis.conf中配置
#AOF文件比上次文件 增长超过多少百分比则触发重写
auto-aof-rewrite-percentage 100
#AOF文件体积最小多大以上才触发重写
auto-aof-rewrite-min-size 64mb
对比
RDB和AOF各有自己的优缺点,如果对数据安全性要求较高,在实际开发中往往会结合两者来使用

1.6redis使用场景——数据过期策略
Redis对数据设置数据的有效时间,数据过期后,就需要将数据从内存中删除掉。可以按照不同的规则进行删除,这种删除规则就被称之为数据的删除策略(数据过期策略)
一、惰性删除
设置该key过期时间后,我们不去管它,当需要该key时,我们再检查其是否过期,如果过期,我们就删掉它,反之返回该key
优点:对CPU友好,只会在使用该key时才会进行过期检查,对于很多用不到的key不用浪费时间进行过期检查
缺点:对内存不友好,如果一个key已经过期,但是一直没有使用,那么该key就会一直存在内存中,内存永远不会释放
二、定期删除
每隔一段时间,我们就对一些key进行检查,删除里面过期的key(从一定数量的数据库中取出一定数量的随机key进行检查,并删除其中过期的key)
有两种模式:
- SLOW模式是定时任务,执行频率默认为10hz,每次不超过25ms,以通过修改配置文件redis.conf的hz选项来调整这个次数
- FAST模式执行频率不固定,但两次间隔不低于2ms,每次耗时不超过1ms
优点:可以通过限制删除操作执行的时长和频率来减少删除操作对CPU的影响,另外定期删除,也能有效释放过期键占用的内存
缺点:难以确定删除操作执行的时长和频率
Redis的过期删除策略:惰性删除+定期删除两种策略进行配合使用
1.7redis使用场景——数据淘汰策略
当Redis中的内存不够用时,此时再向Redis中添加新的key,那么Redis就会按照某一种规则将内存中的数据删除掉,这种数据的删除规则被称之为内存的淘汰策略
Redis支持8种不同策略来选择要删除的key:
- noeviction:不淘汰任何key,但是内存满时不允许写入新数据,默认就是这种策略
- volatile-ttl:对设置了TTL的key,比较key的剩余TTL值,TTL越小越先被淘汰
- allkeys-random:对全体key,随机进行淘汰
- volatile-random:对设置了TTL的key,随机进行淘汰
- allkeys-lru:对全体key,基于LRU算法进行淘汰
- volatile-lru:对设置了TTL的key,基于LRU算法进行淘汰
- allkeys-lfu:对全体key,基于LFU算法进行淘汰
- volatile-lfu:对设置了TTL的key,基于LFU算法进行淘汰

建议:
- 优先使用allkeys-lru策略。充分利用LRU算法的优势,把最近最常访问的数据留在缓存中。如果业务有明显的冷热数据区分,建议使用
- 如果业务中数据访问频率差别不大,没有明显冷热数据区分,建议使用allkeys-random,随机选择淘汰
- 如果业务中有置顶的需求,可以使用volatile-lru策略,同时置顶数据不设置过期时间,这些数据就一直不被删除,会淘汰其他设置过期时间的数据
- 如果业务中有短时高频访问的数据,可以使用allkeys-lfu或volatile-lfu策略
1.8redis分布式锁
一、使用场景
抢卷场景
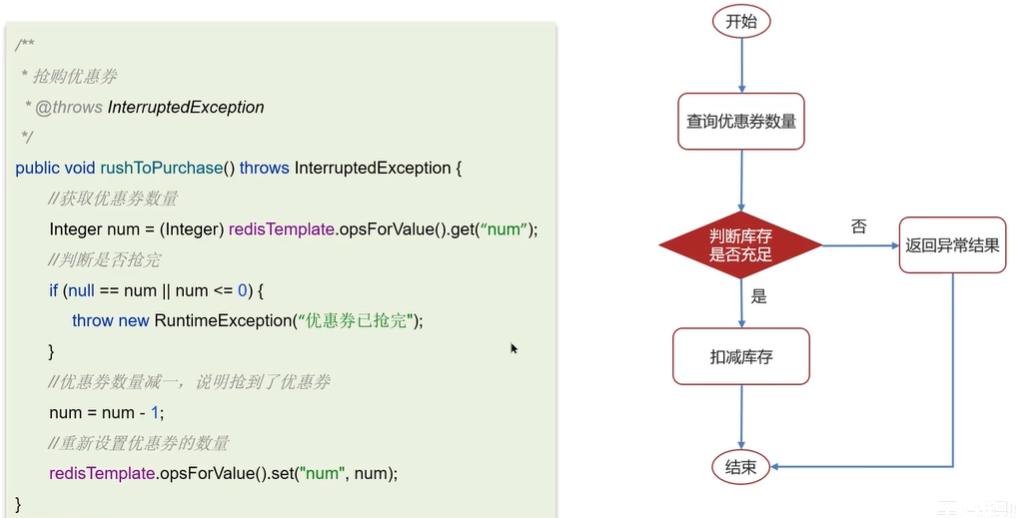
正常执行过程
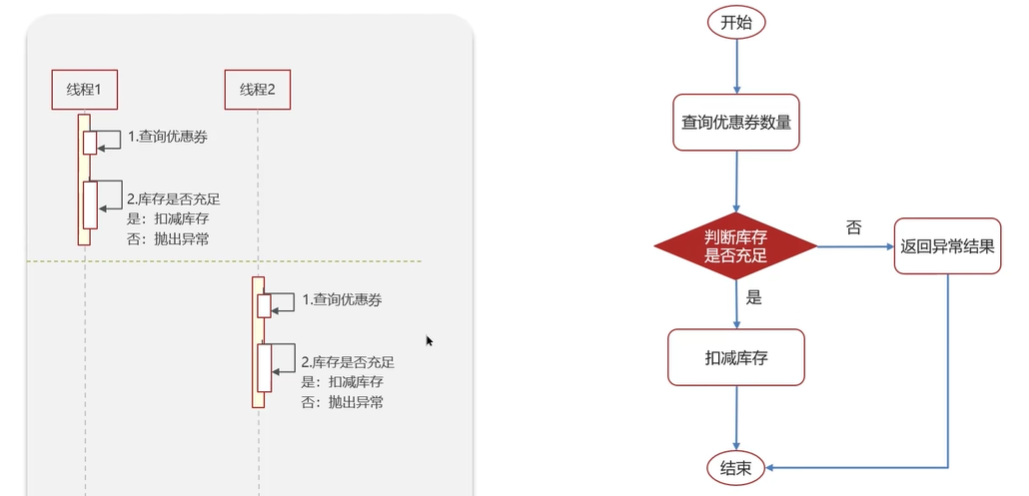
异常模式
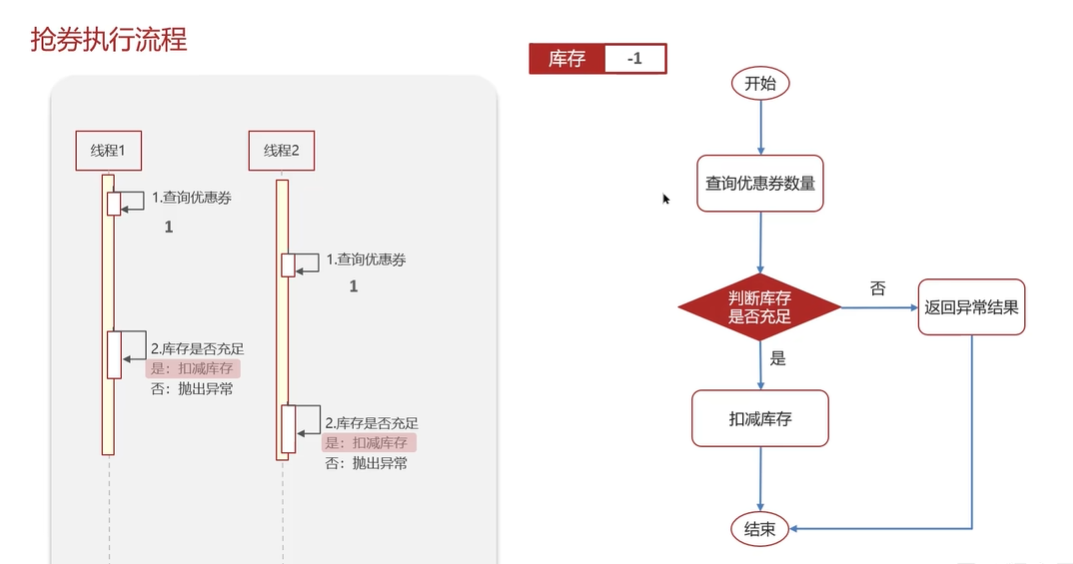
解决(加锁,本地互斥锁,单台服务器):
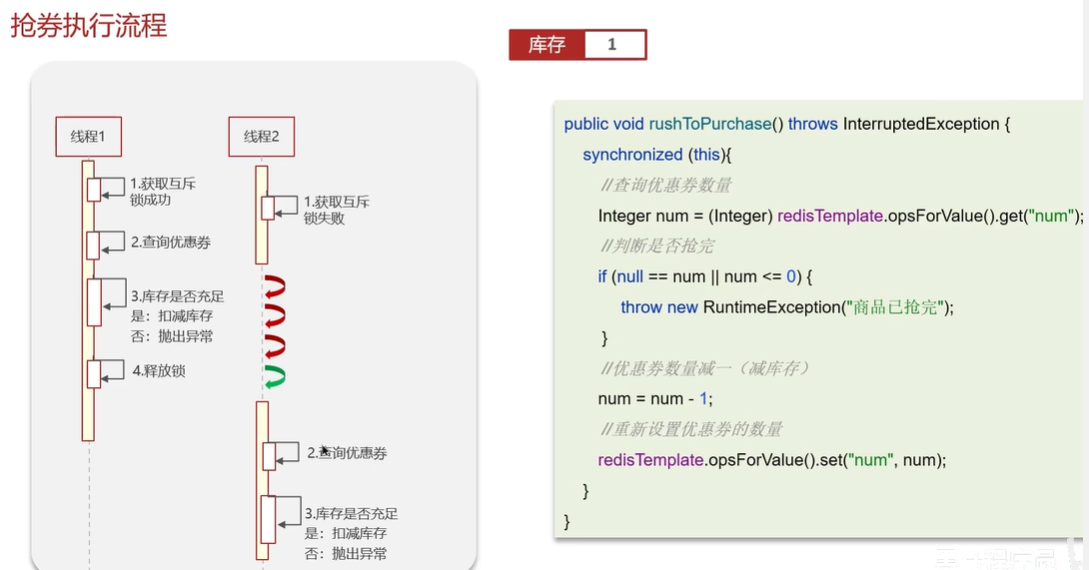
分布式就会出问题
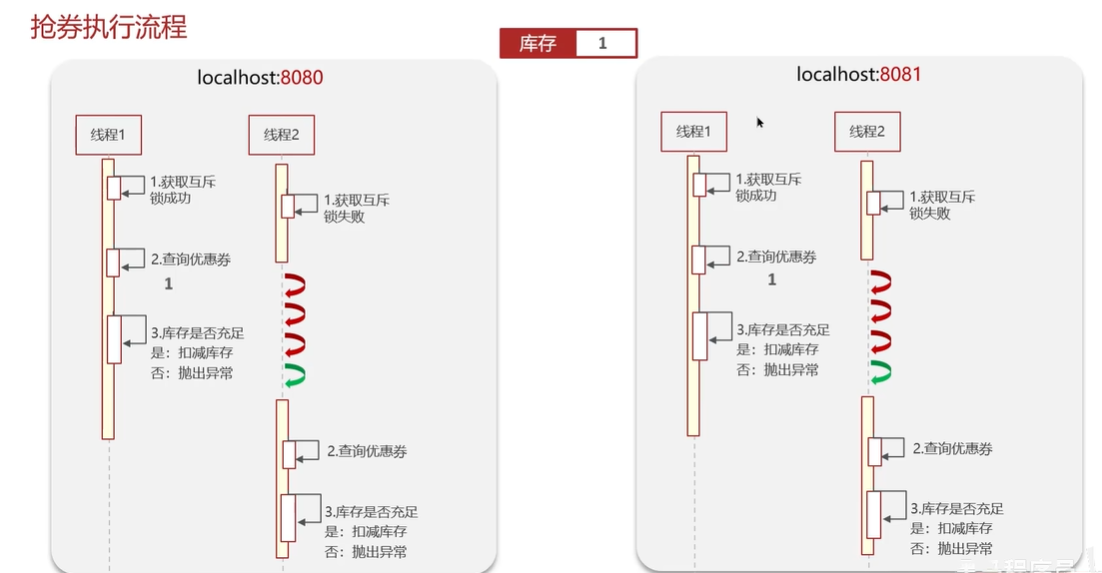
解决:加分布式锁
二、实现原理(setnx、redisson)
Redis实现分布式锁主要利用Redis的setnx命令,setnx是SET if not exists(如果不存在,则SET)的简写
获取锁:
#添加锁,NX是互斥,EX是设置超时时间
SET lock value NX EX 10
释放锁:
#释放锁,删除即可
DEL key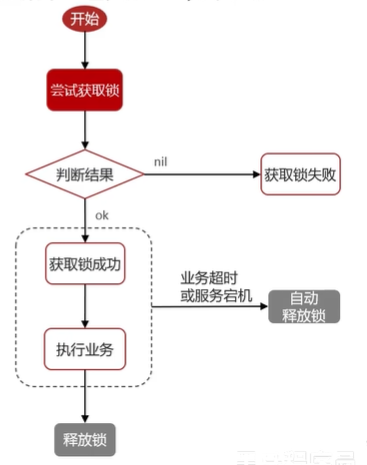
Redis实现分布式锁如何合理的控制锁的有效时长?
- 根据业务执行时间预估
- 给锁续期——怎么实现???redisson
redisson
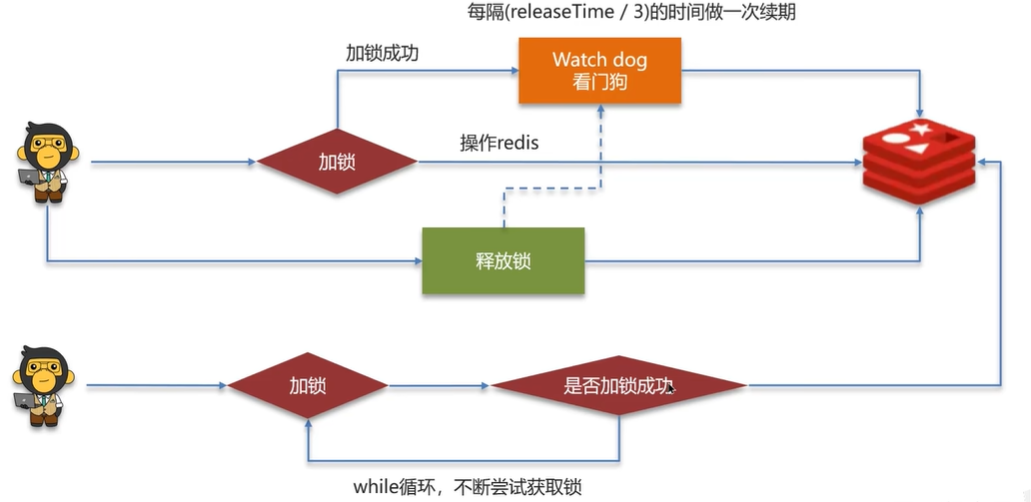
redisson实现的分布式锁,底层是setnx和lua脚本(保证原子性)
Redis缓存中的重试机制,当while循环一定次数时,还没有拿到锁,则会停止
在redisson的分布式锁中,提供了一个WatchDog,一个线程获取锁成功后,WatchDog会给持有锁的线程续期(默认是每隔10s续期一次)
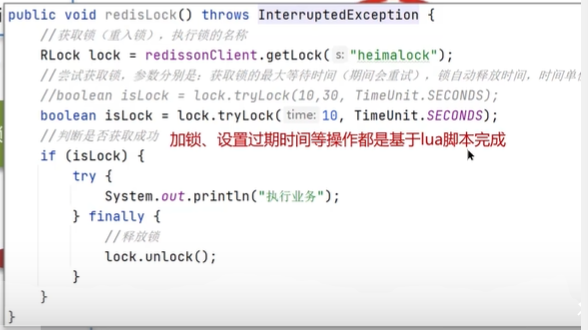
redisson——可重入
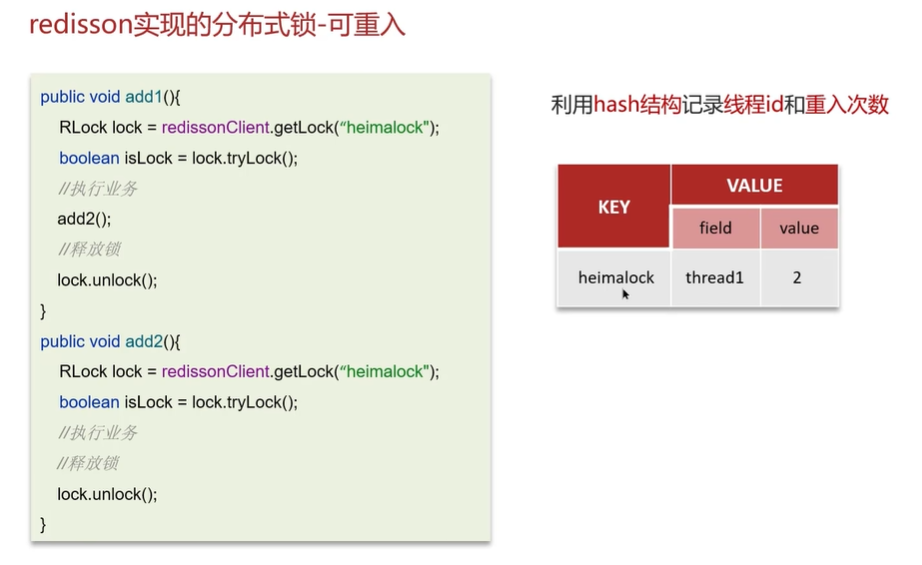
可重入,多个锁重入需要判断是否是当前线程,在redis中进行存储的时候使用的hash结构,来存储线程信息和重入的次数
redisson——主从一致性
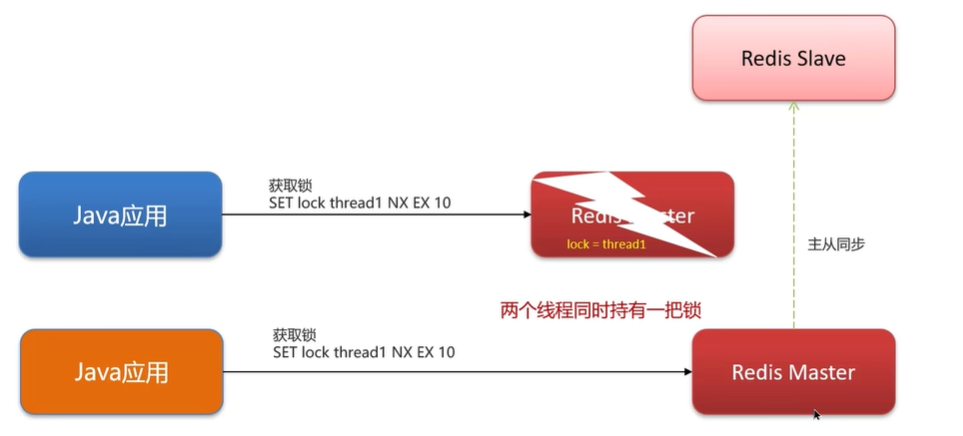
当一个线程访问主节点时,主节点获取锁后突然宕机,此时会从从节点中选择一个作为主节点,以后的线程可以访问这个节点,这个新的主节点也会获取锁,此时,两个线程同时持有一把锁,会产生脏数据
解决方法:
RedLock(红锁):不能只在一个redis实例上创建锁,应该是在多个redis实例上创建锁**(n / 2 + 1)**,避免在一个redis实例上加锁
例:有三个redis节点,3 / 2 + 1 = 2.5, 加锁的redis实例应该>=2(超过一半)
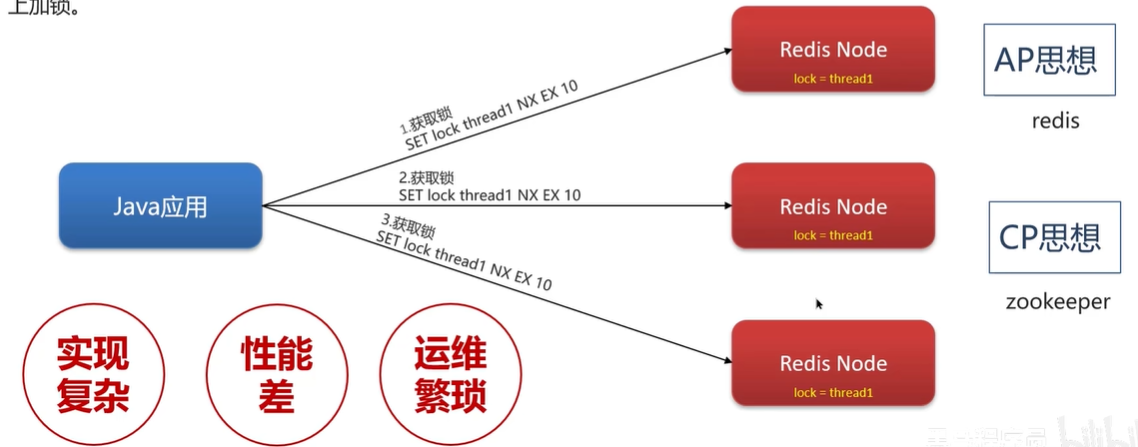
Redisson锁能解决主从数据一致的问题吗?
不能,但是可以用redisson提供的红锁来解决,但是这样的话,性能就太低了,如果业务中非要保持数据的强一致性,建议采用zookeeper实现的分布式锁
1.9redis集群方案
一、主从复制
单节点的Redis的并发能力是有上限的,要进一步提高Redis的并发能力,就需要搭建主从集群,实现读写分离
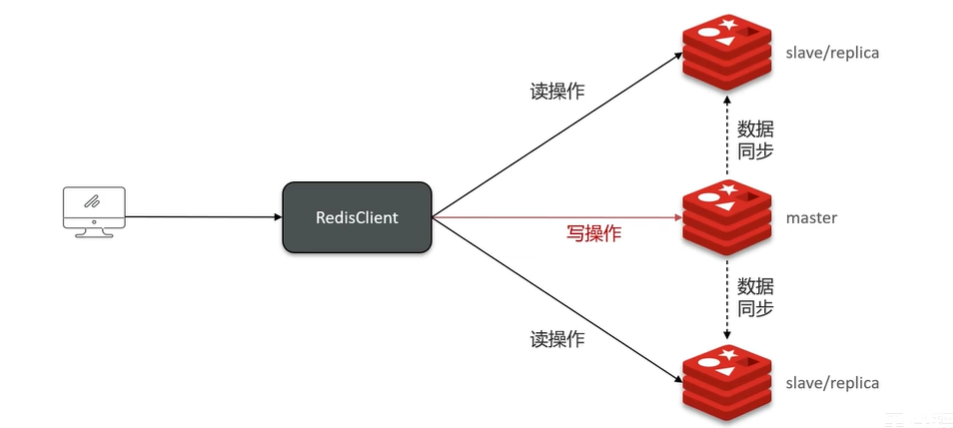
主从全量同步
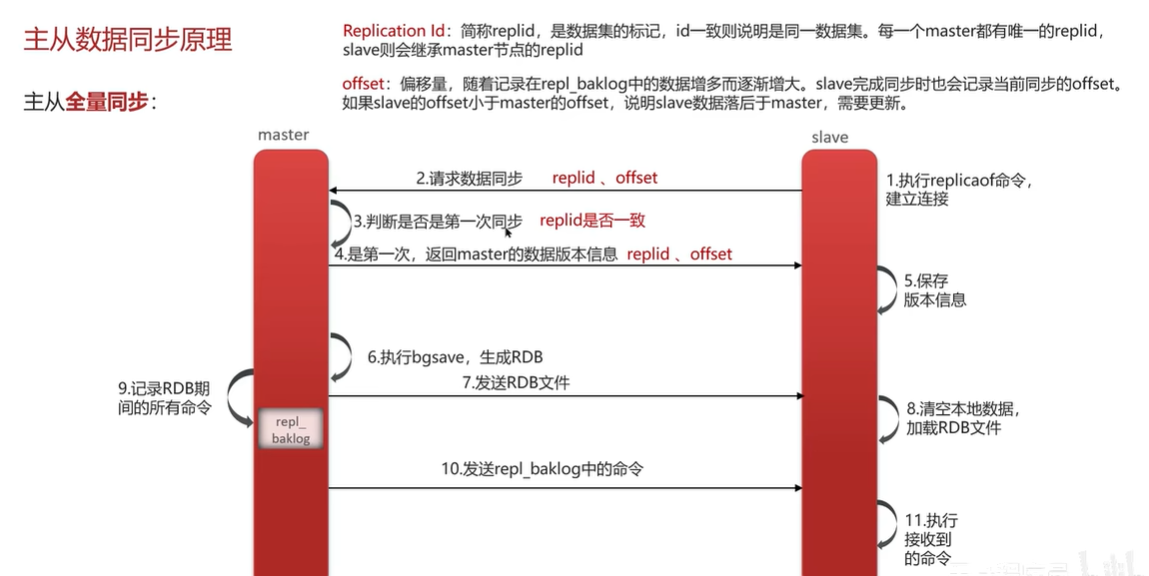
1、从节点请求主节点同步数据(replication id、offset)
2、主节点判断是否是第一次请求,是第一次就与从节点同步版本信息(replication id和offset)
3、主节点执行bgsave,生成rdb文件后,发送给从节点去执行
4、在rdb生成执行期间,主节点会以命令的方式记录到缓冲区(一个日志文件)
5、把生成之后的命令日志文件发送给从节点进行同步
主从增量同步 (slave重启或后期数据变化)
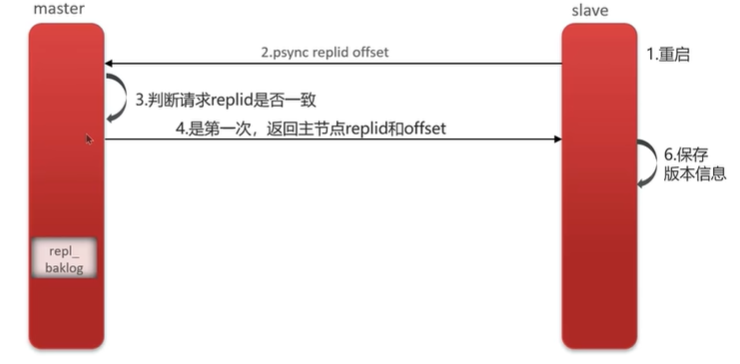
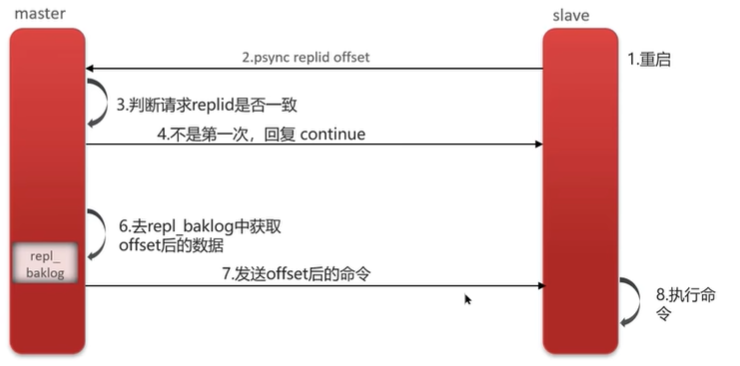
1、从节点请求主节点同步数据,主节点判断是不是第一次请求,不是第一次请求就获取从节点的offset值
2、主节点从命令日志中获取offset值之后的数据,发送给从节点进行数据同步
二、哨兵模式
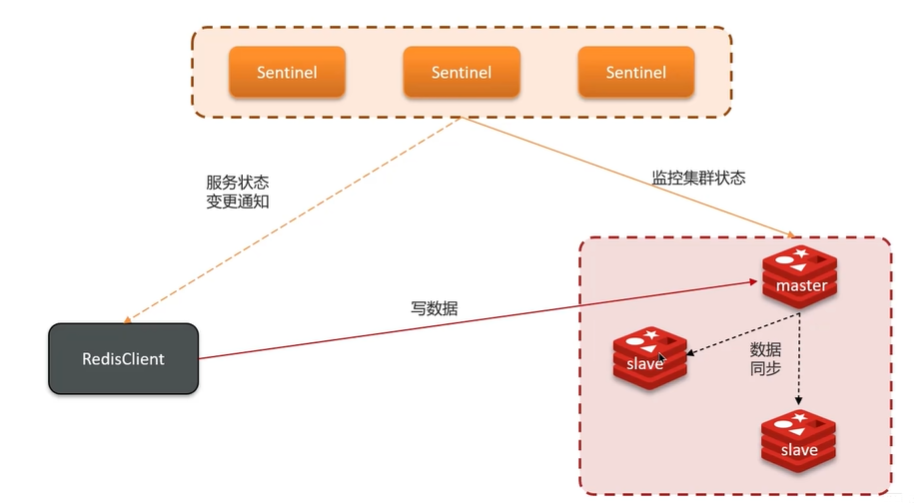
Redis提供了哨兵(Sentinel)机制来实现主从集群的自动故障恢复。哨兵的结构作用如下:
- 监控:Sentinel会不断检查您的master和slave是否按照预期工作
- 自动故障恢复:如果master故障,Sentinel会将一个slave提升为master。当故障实例恢复后,也以新的master为主
- 通知:Sentinel充当Redis客户端的服务发现来源,当集群发生故障转移时,会将最新信息推送给Redis的客户端
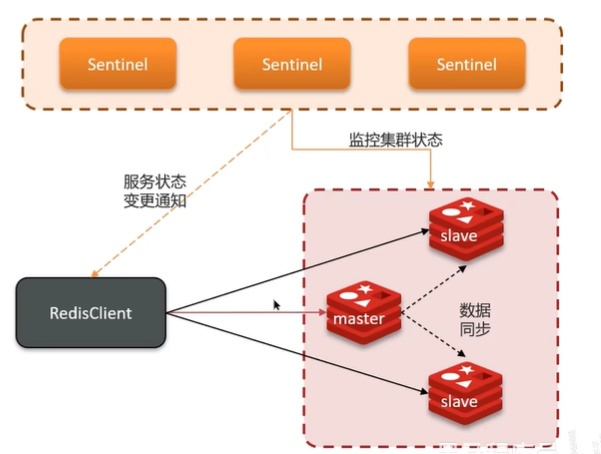
服务状态监控
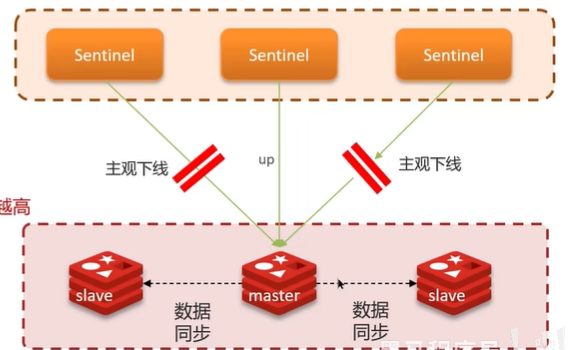
Sentinel基于心跳机制监测服务状态,每隔1秒向集群的每个实例发送ping命令:
- 主观下线:如果某sentinel节点发现某实例在规定时间未响应,则认为该实例主观下线
- 客观下线:若超过指定数量(quorum)的sentinel都认为该实例主观下线,则该实例客观下线,quorum值最好超过Sentinel实例数量的一半
哨兵选主规则
- 首先判断主与从节点断开的时间长短,如超过指定值就排该从节点,越短越好,丢失的数据越少
- 然后判断从节点的slave-priority(优先级)值,越小优先级越高
- 如果slave-priority一样,则判断slave节点的offset值,越大优先级越高
- 最后是判断slave节点的运行id大小,越小优先级越高
redis集群(哨兵模式)脑裂
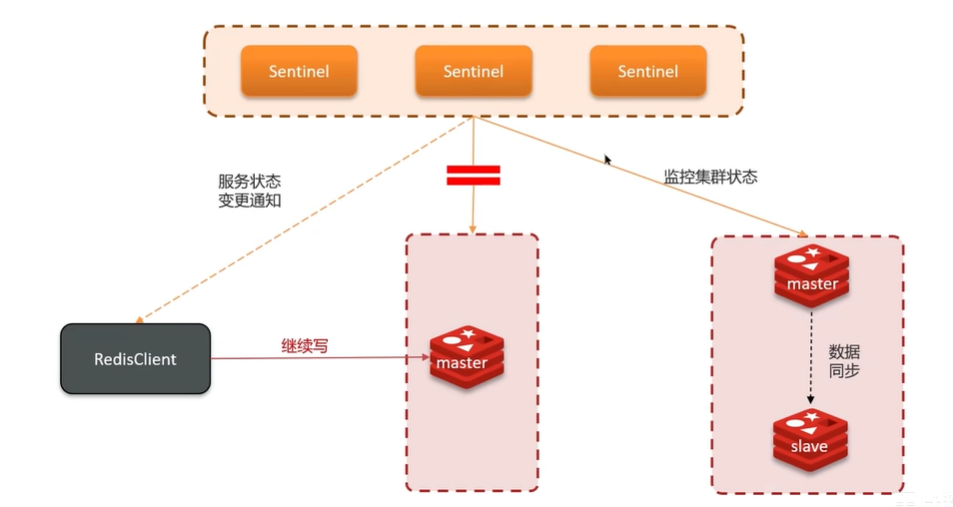
脑裂:出现多个master
当网络恢复后,原master会被降级为slave,这时再从新master同步数据,就会导致数据丢失
解决方案:
redis中有两个配置参数
min-replicas-to-write 1 表示最少的salve节点为1个
min-replicas-max-lag 5 表示数据复制和同步的延迟不能超过5秒
我们可以修改redis的配置,可以设置最少的从节点数量以及缩短主从数据同步的延迟时间,达不到要求就拒绝请求,就可以避免大量的数据丢失
三、分片集群
主从和哨兵可以解决高并发读、高可用的问题,但是依然有两个问题没有解决:
- 海量数据存储问题
- 高并发写的问题
使用分片集群可以解决以上问题,分片集群特征:
- 集群中有多个master,每个master保存不同数据
- 每个master都可以有多个slave节点
- master之间通过ping监测彼此健康状态
- 客户端请求可以访问集群任意节点,最终都会被转发到正确节点
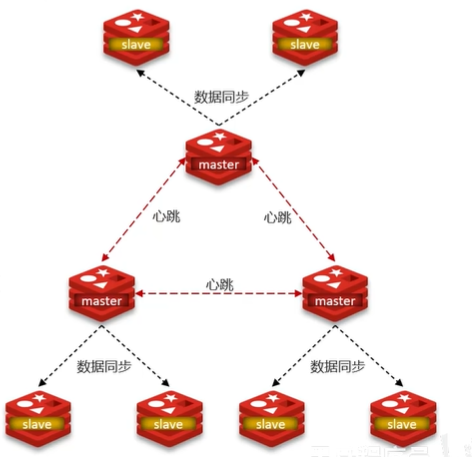
Redis分片集群数据的存储和读取
Redis分片集群引入了哈希槽的概念,Redis集群有16384个哈希槽,每个key通过CRC16校验后对16384取模来决定放置哪个槽,集群的每个节点负责一部分hash槽
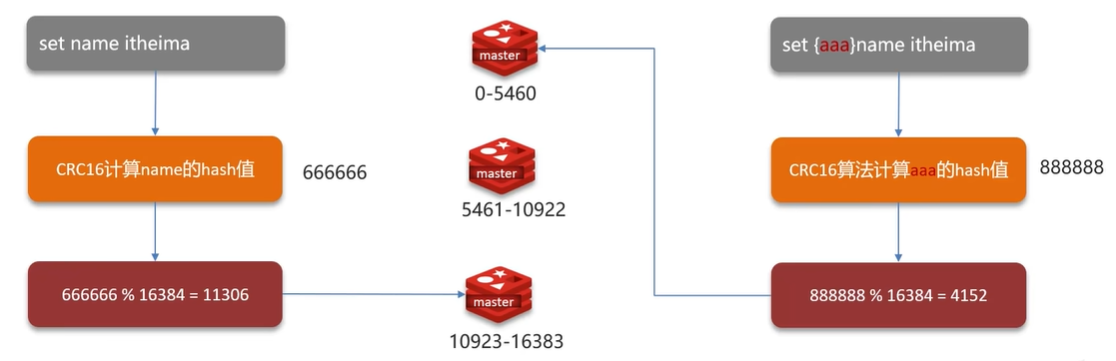
- Redis分片集群引入了哈希槽的概念,Redis集群有16384个哈希槽
- 将16384个插槽分配到不同的实例
- 读写数据:根据Key的有效部分计算哈希值,对16384取余(有效部分,如果key前面有大括号,大括号的内容就是有效部分,如果没有,则以key本身做为有效部分)余数做为插槽,寻找插槽所在的实例
1.10redis单线程——为什么还那么快?
- Redis是纯内存操作,执行速度非常快
- 采用单线程,避免不必要的上下文切换可竞争条件,多线程还要考虑线程安全问题
- 使用I/O多路复用模型,非阻塞IO
多路复用模型
Redis是纯内存操作,执行速度非常快,它的性能瓶颈是网络延迟而不是执行速度,I/O多路复用模型主要就是实现了高效的网络请求
- 用户空间和内核空间
- 常见的IO模型
- 阻塞IO(Blocking IO)
- 非阻塞IO(Noblocking IO)
- IO多路复用(IO Multiplexing)
- Redis网络模型
用户空间和内核空间
Linux系统中的一个进程使用的内存情况划分两部分:内核空间、用户空间
用户空间只能执行受限的命令(Ring3),而且不能直接调用系统资源,必须通过内核提供的接口来访问
内核空间可以执行特权命令(Ring0),调用一切系统资源

Linux系统为了提高IO效率,会在用户空间和内核空间都加入缓冲区:
- 写数据时,要把用户缓冲数据拷贝到内核缓冲区,然后写入设备
- 读数据时,要从设备读数据到内核缓冲区,然后拷贝到用户缓冲区
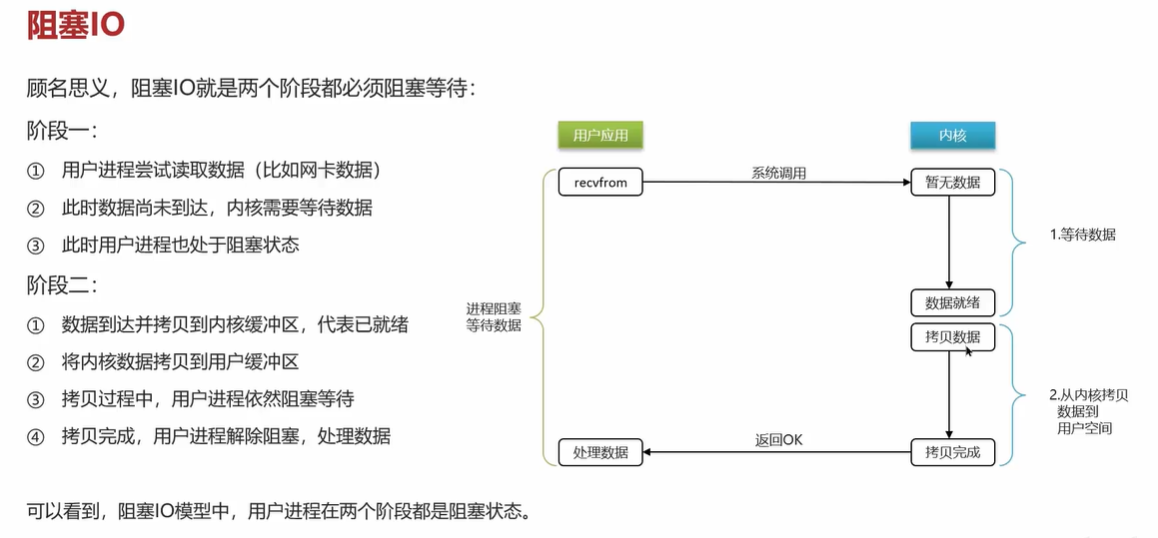
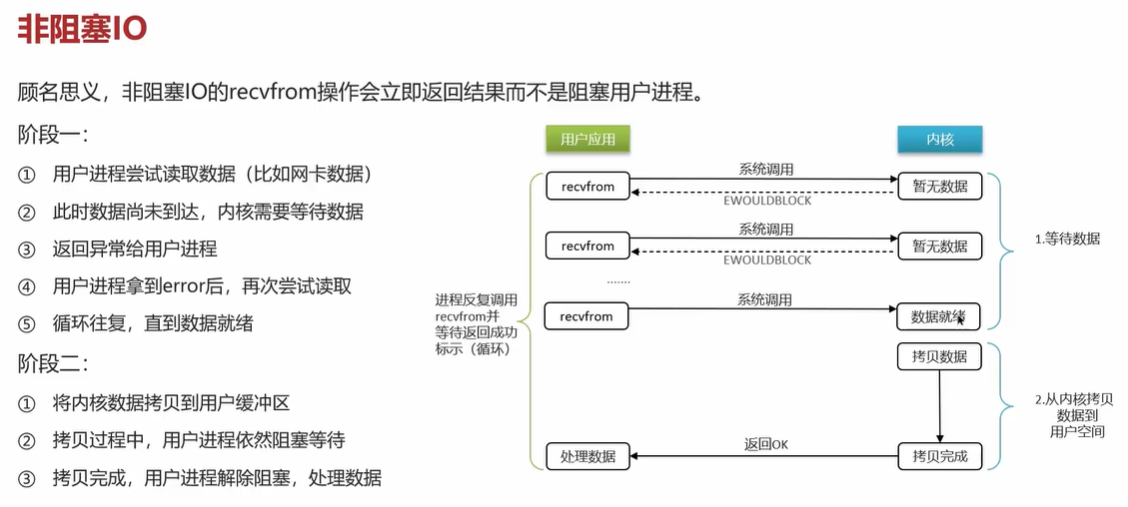
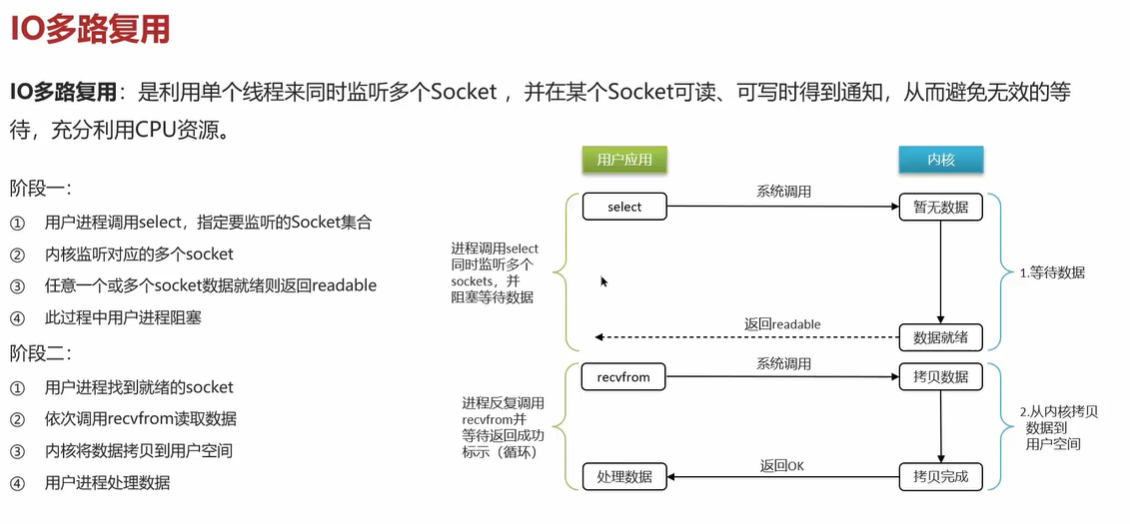
IO多路复用
是利用单个线程来同时监听多个Socket,并在某个Socket可读、可写时得到通知,从而避免无效的等待,充分利用CPU资源。目前I/O多路复用采用的都是epoll模式实现,它会在通知用户进程Socket就绪的同时,把已就绪的Socket写入用户空间,不需要挨个遍历Socket来判断是否就绪,提升了性能。
不过监听Socket的方式、通知的方式又有多种实现,常见的有:
- select
- poll
- epoll
差异:
- select和poll只会通知用户进程有Socket就绪,但不确定具体是哪个Socket,需要用户进程逐个遍历Socket来确认
- epoll则会在通知用户进程Socket就绪的同时,把已就绪的Socket写入用户空间
Redis网络模型
Redis通过IO多路复用来提高网络性能,并且支持各种不同的多路复用实现,并且将这些实现进行封装,提供了统一的高性能事件库
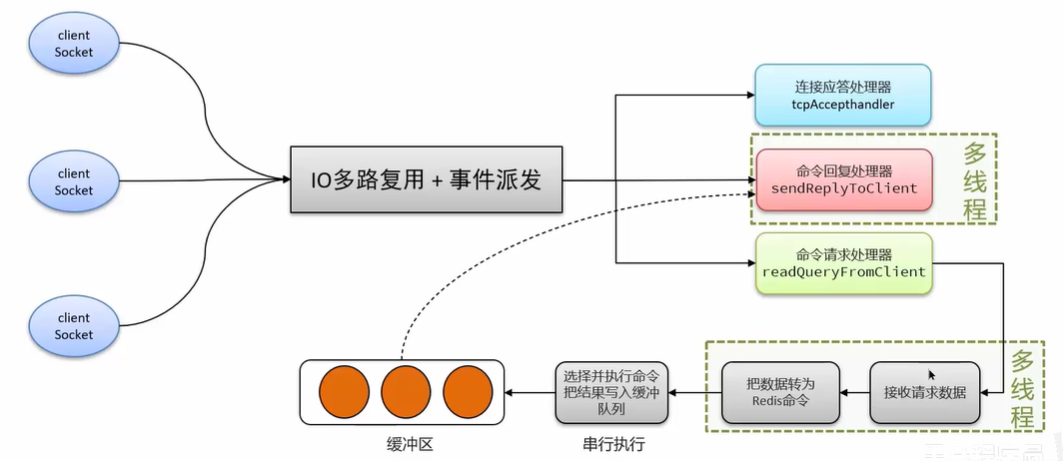
就是使用I/O多路复用结合事件的处理器来应对多个Socket的请求
- 连接应答处理器
- 命令回复处理器,在Redis6.0之后,为了更好的提升性能,使用了多线程来处理回复事件
- 命令请求处理器,在Redis6.0之后,将命令的转换使用了多线程,增加命令转换速度,在命令执行的时候,依然是单线程
第二章 MySQL
2.1优化——定位慢查询
- 聚合查询
- 多表查询
- 表数据量过大查询
- 深度分页查询
表象:页面加载过慢、接口测试响应时间过长(超过1s)
方案一:开源工具
- 调试工具:Arthas
- 运维工具:Prometheus、Skywalking
方案二:MySQL自带慢日志
慢查询日志记录了所有执行时间超过指定参数(long_query_time,单位:秒,默认10秒)的所有SQL语句的日志,如果要开启慢查询日志,需要在MySQL的配置文件(/etc/my.cnf)中配置如下信息:
#开启MySQL慢日志开关
slow_query_log=1
#设置慢日志的时间为2s,SQL语句执行时间超过2s,就会视为慢查询,记录慢查询日志
long_query_time=2
配置完毕后,通过以下指令重新启动MySQL服务器进行测试,查看慢日志中记录的信息
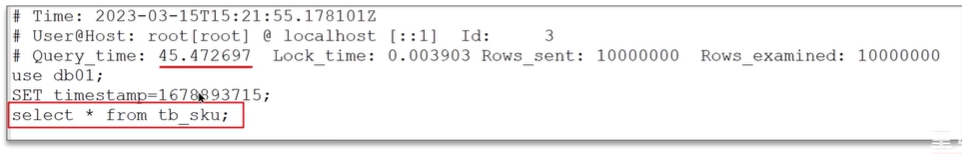
2.2优化——优化慢查询
SQL执行计划(找到慢的原因)
- 聚合查询 新增临时表解决
- 多表查询 优化SQL语句结构
- 表数据量过大查询 添加索引
可以采用EXPLAIN或者DESC命令获取MySQL如何执行SELECT语句的信息
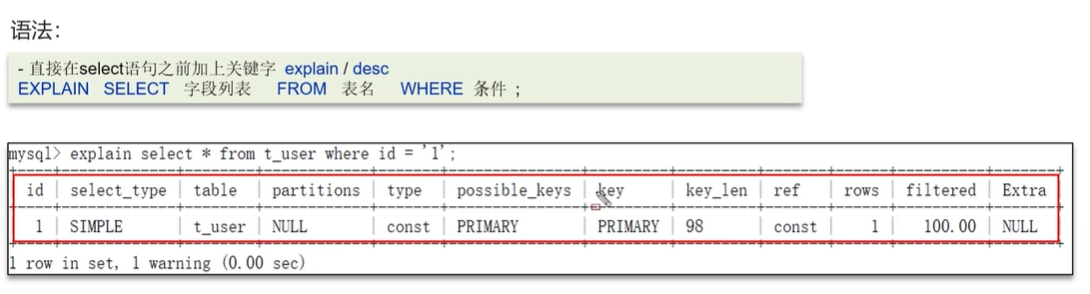
1、possible_keys 当前sql可能会使用到的索引
2、key 当前sql实际命中的索引
3、key_len 索引占用的大小
通过2和3查看是否可能会命中索引
4、Extra 额外的优化建议
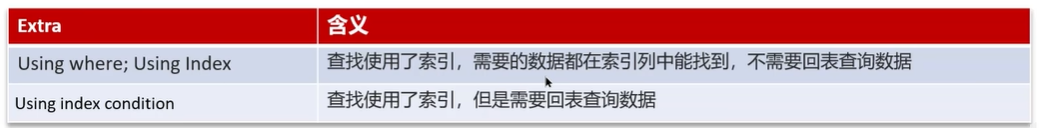
5、type这条sql的连接的类型,性能由好到差为NULL,system,const,eq_ref,ref,range,index,all
- NULL:查询时没有使用到表
- system:查询的表是mysql系统内置的表
- const:根据主键查询
- eq_ref:主键索引查询或唯一索引查询
- ref:使用索引查询
- range:范围查询
- index:全索引扫描
- all:全盘扫描
当前type为index或all时,这条sql就需要进行优化了
2.3优化——索引
索引(index)是帮助MySQL高效获取数据的数据结构(有序)。在数据之外,数据库系统还维护着满足特定查找算法的数据结构(B+树),这些数据结构以某种方式引用(指向)数据,这样就可以在这些数据结构上实现高级查找算法,这种数据结构就是索引。
一、B+树

时间复杂度:
- 相对平衡的话:O(logn)
- 退化成链表:O(n)
- O(logn)
B-Tree,B树是一种多叉路平衡查找树,相对于二叉树,B树每个节点可以有多个分支,即多叉。
以一颗最大度数(max-degree)为5(5阶)的b-tree为例,那么这个B树每个节点最多存储4个key
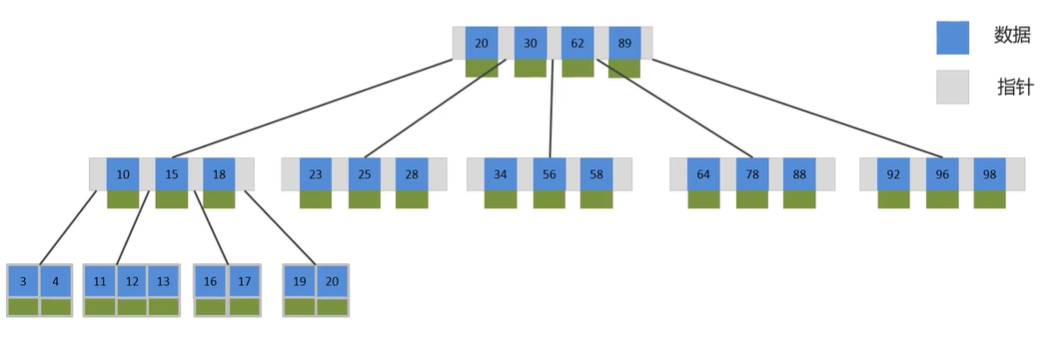
B+Tree是在BTree基础上的一种优化,使其更适合实现外存储索引结构,InnoDB存储引擎就是用B+Tree实现其索引结构
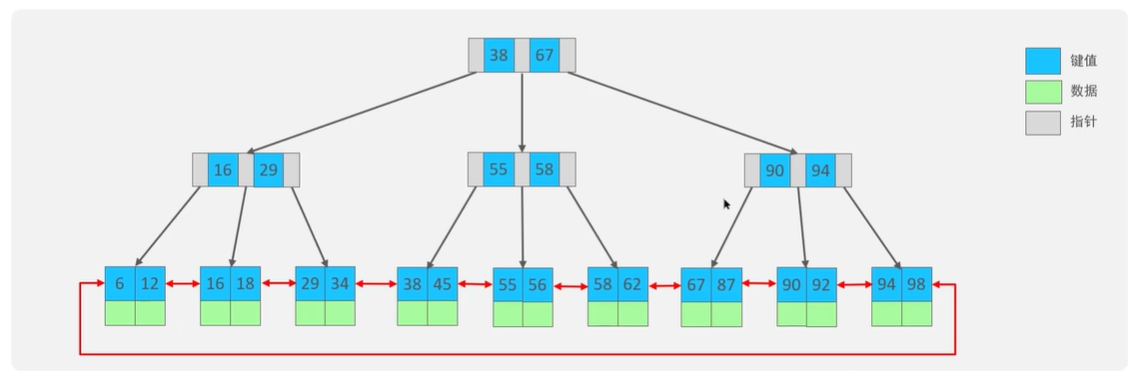
B树与B+树对比:
- 磁盘读写代价B+树更低
- 查询效率B+树更加稳定
- B+树便于扫库和区间查询 :叶子节点之间是由双向指针连接的
问题一:什么是索引
- 索引(index)是帮助MySQL高效获取数据的数据结构(有序)
- 提高数据检索的效率,降低数据库的IO成本(不需要全表扫描)
- 通过索引列对数据进行排序,降低数据排序的成本,降低了CPU的消耗
问题二:索引的底层数据结构
MySQL的InnoDB引擎采用的是B+树的数据结构来存储索引
- 阶数更多,路径更短
- 磁盘读写代价B+树更低,非叶子节点只存储指针,叶子节点存储数据
- B+树便于扫库和区间查询,叶子节点是一个双向链表
二、聚簇索引和非聚簇索引
| 分类 | 含义 | 特点 |
|---|---|---|
| 聚集索引(Clustered Index) | 将数据存储与索引放到了一块,索引结构的叶子节点保存了行数据 | 必须有,而且只由一个 |
| 二级索引(非聚集索引Secondary Index) | 将数据与索引分开存储,索引结构的叶子节点关联的是对应的主键 | 可以存在多个 |
聚集索引选取规则:
- 如果存在主键,主键索引就是聚集索引
- 如果不存在主键,将使用第一个唯一(UNIQUE)索引作为聚集索引
- 如果表没有主键,或没有合适的唯一索引,则InnoDB会自动生成一个rowid作为隐藏的聚集索引
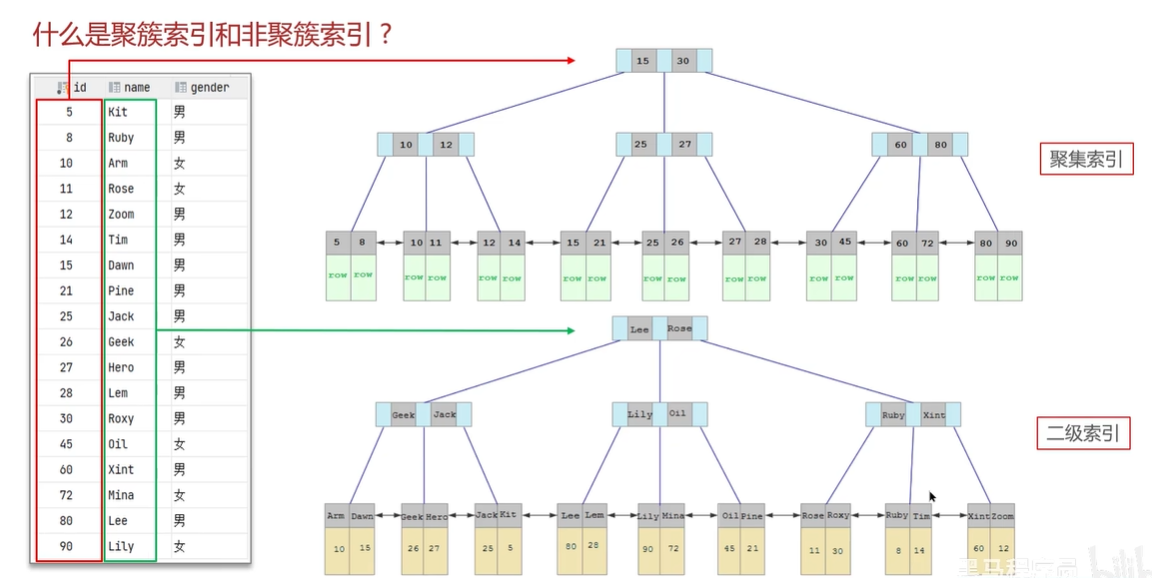
- 聚簇索引(聚集索引):数据与索引放到一块,B+树的叶子节点保存了整行数据,有且只有一个
- 非聚簇索引(二级索引):数据又索引分开存储,B+树的叶子节点保存对应的主键,可以有多个
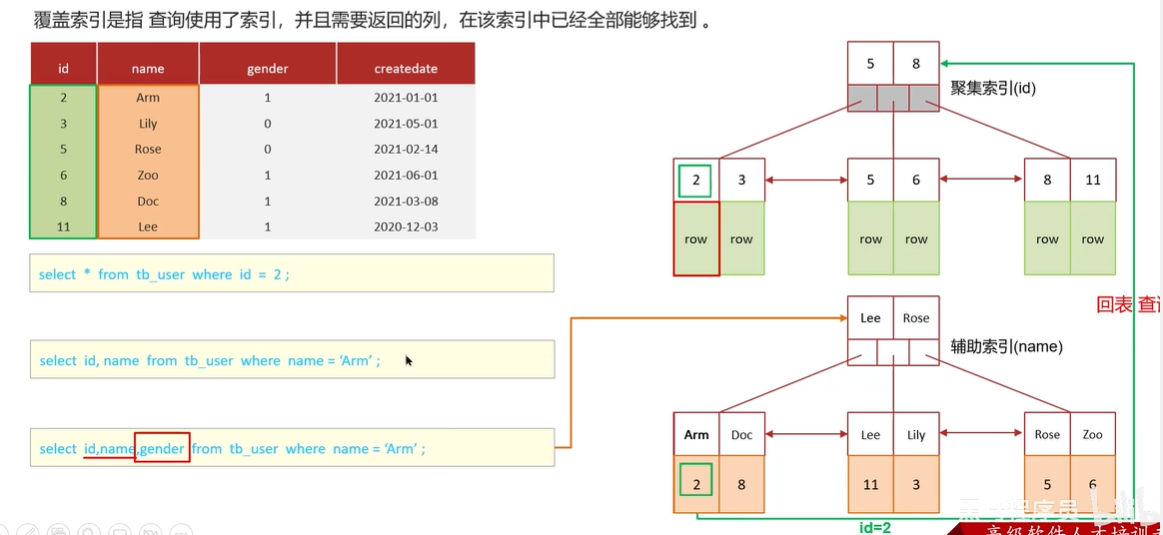
回表查询
通过二级索引找到对应的主键值,到聚集索引中查找整行数据,这个过程就是回表
三、覆盖索引、超大分页优化
覆盖索引是指查询使用了索引,并且需要返回的列,在该索引中已经全部能够找到。(不需要回表查询)
MySQL超大分页
在数据量比较大时,如果进行limit分页查询,在查询时,越往后,分页查询效率越低
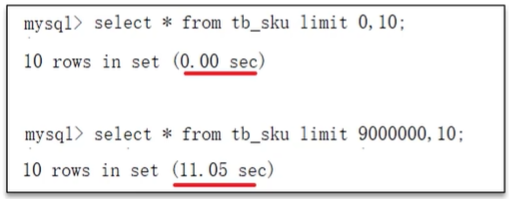
因为,在分页查询时,如果执行limit 9000000,10,此时需要MySQL排序前9000010记录,仅仅返回9000000-9000010的记录,其他记录丢弃,查询排序的代价非常大。
优化思路:一般分页查询时,通过创建覆盖索引能够比较好地提升性能,可以通过覆盖索引加子查询形式进行优化
select *
from tb_sku t,
	(select id from tb_sku order by id limit 9000000,10)a
where t.id = a.id;
MySQL超大分页
在数据量比较大时,limit分页查询,需要对数据进行排序,效率低
解决方案:覆盖索引 + 子查询
索引创建的原则
1、针对于数据量较大,且查询比较频繁的表建立索引。单表超过10万数据(增加用户体验) 重要
2、针对于常作为查询条件(where)、排序(order by)、分组(group by)操作的字段建立索引 重要
3、尽量选择区分度高的列作为索引,尽量建立唯一索引,区分度越高,使用索引的效率越高
4、如果是字符串类型的字段,字段的长度较长,可以针对于字段的特点,建立前缀索引
5、尽量使用联合索引,减少单列索引,查询时,联合索引很多时候可以覆盖索引,节省存储空间,避免回表,提高查询效率 重要
6、要控制索引的数量,索引并不是多多益善,索引越多,维护索引结构的代价就越大,会影响增删改的效率 重要
7、如果索引列不能存储NULL值,请在创建表时使用NOT NULL约束它,当优化器知道每列是否包含NULL值时,它可以更好地确定哪个索引最有效地用于查询
索引会失效的情况
1、违反最左前缀法则
如果索引了多列,要遵守最左前缀法则。指的是查询从索引的最左前列开始,并且不跳过索引中的列,匹配最左前缀法则,走索引
2、范围查询右边的列,不能使用索引
3、不要在索引列上进行运算操作,索引将失效
4、字符串不加单引号,造成索引失效,MySQL的查询优化器,会自动的进行类型转换,造成索引失效
5、以%开头的Like模糊查询,索引失效。如果仅仅是尾部模糊查询,索引不会失效,如果是头部模糊匹配,索引失效
谈谈对sql优化的经验
- 表的设计优化
- 索引优化(参考优化创建原则和索引失效)
- SQL语句优化
- 主从复制、读写分析
- 分库分表
表的设计优化(参考阿里开发手册《嵩山版》)
- 比如设置合适的数值(tinyint int bigint),要根据实际情况选择
- 比如设置合适的字符串类型(char和varchar) char定长效率高,varchar可变长度,效率稍低
SQL语句优化
- SELECT语句务必指明字段(避免直接使用select *)
- SQL语句要避免造成索引失效的写法
- 尽量用union all代替union union会多一次过滤,效率低
- 避免在where子句中对字段进行表达式操作
- Join优化,能用inner join就不用left join 或 right join,如必须使用 一定要以小表为驱动,内连接会对两个表进行优化,优先把小表放到外边,把大表放到里边。left join或right join,不会重新调整顺序
主从复制、读写分离
如果数据库的使用场景读的操作比较多的时候,为了避免写的操作所造成的性能影响,可以采用读写分离的架构。读写分离解决的是,数据库的写入,影响了查询的效率

2.4优化——其他面试题
一、事务相关
事务的特性 ACID
事务是一组操作的集合,它是一个不可分割的工作单位,事务会把所有的操作作为一个整体一起向系统提交或撤销操作请求,即这些操作要么同时成功,要么同时失败
- 原子性(Atomicity):事务是不可分割的最小操作单元,要么全部成功,要么全部失败
- 一致性(Consistency):事务完成时,必须使所有的数据都保持一致状态
- 隔离性(Isolation):数据库系统提供的隔离机制,保证事务在不受外部并发操作影响的独立环境下运行
- 持久性(Durability):事务一旦提交或回滚,它对数据库中的数据的改变就是永久的
并发事务、隔离级别
并发事务问题:脏读、不可重复读、幻读
解决办法:
隔离级别:读未提交、读已提交、可重复读、串行化
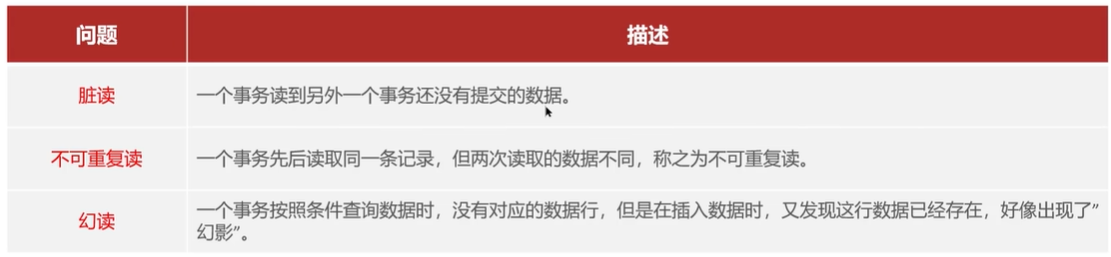
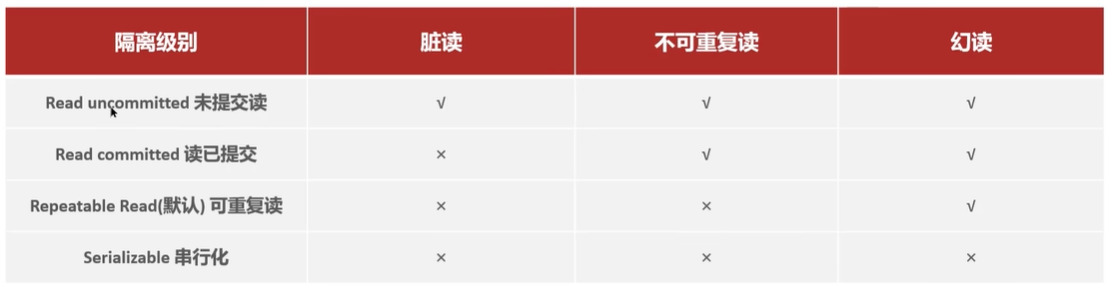
x:可以解决
√:不可以解决
注意:事务隔离级别越高,数据越安全,但是性能越低
undo log和redo log的区别
- **缓冲池(buffer poll):**主内存中的一个区域,里面可以缓存磁盘上经常操作的真实数据,在执行增删改查操作时,先操作缓冲池中的数据(若缓冲池没有数据,则从磁盘加载并缓存),以一定频率刷新到磁盘,从而减少磁盘IO,加快处理速度
- **数据页(page):**是InnoDB存储引擎磁盘管理的最小单元,每个页的大小默认为16KB,页中存储的是行数据
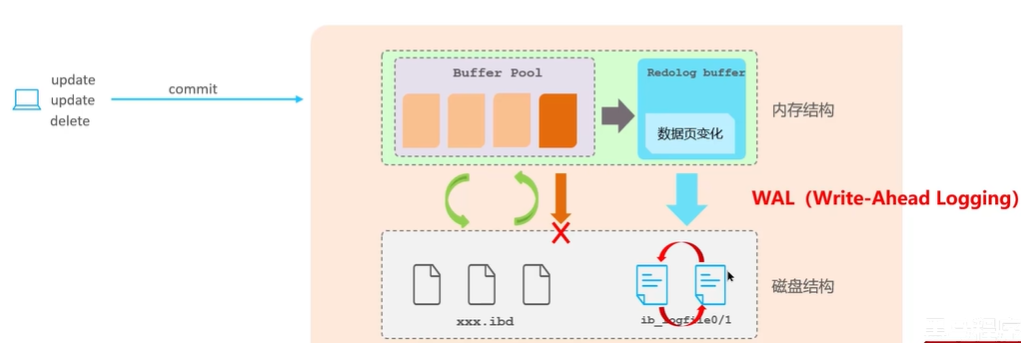
redo log
重做日志,记录的是事务提交时数据页的物理修改,是用来实现事务的持久性
该日志文件由两部分组成:重做日志缓冲(redo log buffer)以及重做日志文件(redo log file),前者是在内存中,后者在磁盘中。当事务提交之后会把所有修改信息都存到该日志文件中,用于在刷新脏页到磁盘,发生错误时,进行数据恢复使用。
undo log
回滚日志,用于记录数据被修改前的信息,作用包含两个:提供回滚和MVCC(多版本并发控制)。uodo log和redo log记录物理日志不一样,它是逻辑日志
- 可以认为当delete一条记录时,undo log中会记录一条对应的insert记录,反之亦然
- 当update一条记录时,它记录一条对应相反的update记录,当执行rollback时,就可以从undo log中的逻辑记录读取到相应的内容并进行回滚
undo log可以实现事务的一致性和原子性
区别:
- redo log:记录的是数据页的物理变化,服务宕机可以用来同步数据
- undo log:记录的是逻辑日志,当事务回滚时,通过逆操作恢复原来的数据
- redo log保证了事务的持久性,undo log保证了事务的原子性和一致性
事务中的隔离性是如何保证的?
锁:排他锁(如一个事务获取了一个数据行的排他锁,其他事务就不能再获取该行的其他锁)
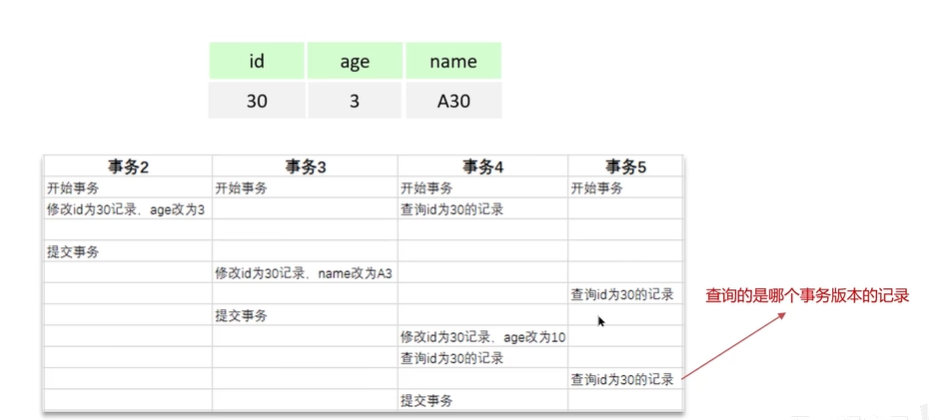
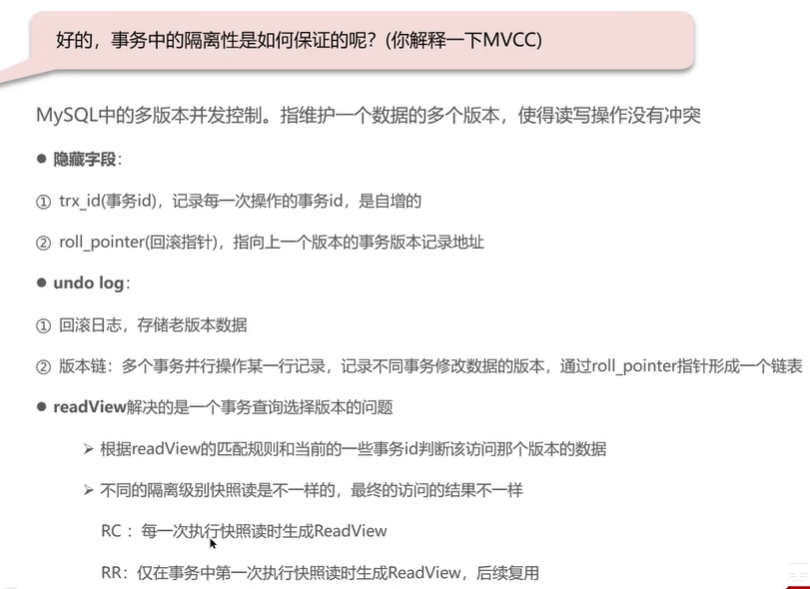
MVCC
多版本并发控制
全称Multi-Version Concurrency Control,多版本并发控制。指维护一个数据的多个多个版本,使得读写操作没有冲突
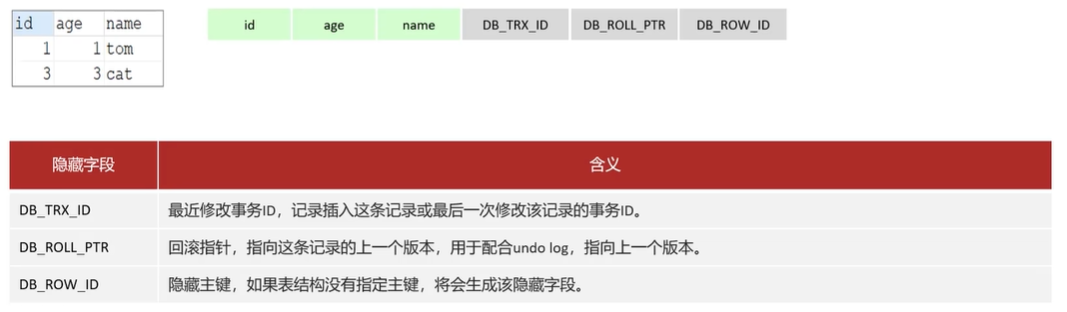
MVCC的具体实现,主要依赖于数据库记录中的隐藏字段,undo log日志,readView
隐藏字段
undo log
回滚日志,在insert、update、delete的时候产生的便于数据回滚的日志
当insert的时候,产生的undo log日志只在回滚时需要,在事务提交后,可被立即删除
而update、delete的时候,产生的undo log日志不仅在回滚时需要,mvcc版本访问也需要,不会立即被删除
undo log版本链
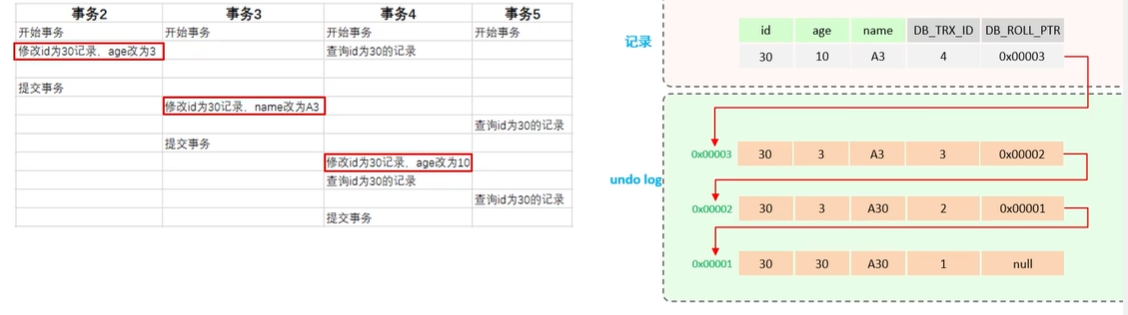
不同事务或相同事务对同一条记录进行修改,会导致该记录的undo log生成一条记录版本链表,链表的头部是最新的旧纪录,链表尾部是最早的旧纪录
readview
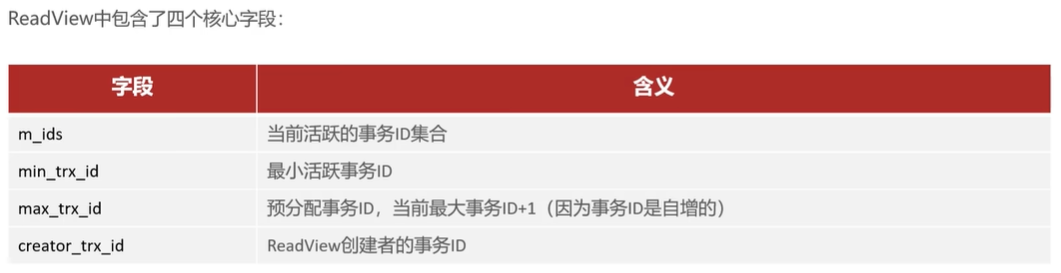
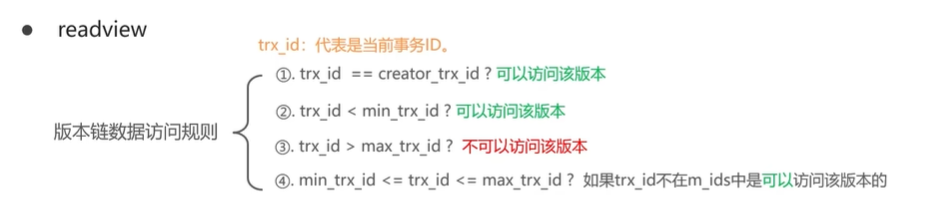
ReadView(读视图)是快照读SQL执行时MVCC提取数据的依据,记录并维护系统当前活跃的事务(未提交的)id
- 当前读
读取的是记录的最新版本,读取时还要保证其他并发事务不能修改当前记录,会对读取的记录进行加锁,对于我们日常的操作,如:select…lock in share mode(共享锁), select … for update、update、insert、delete(排他锁)都是一种当前读
- 快照读
简单的select(不加锁)就是快照读,快照读,读取的是记录数据的可见版本,有可能是历史数据,不加锁,是非阻塞读
- Read Committed:每次select,都生成一个快照读
- Repeatable Read:开启事务后第一个select语句才是快照读的地方
不同的隔离级别,生成ReadView的时机不同:
- READ COMMOTTED:在事务中每一次执行快照读生成ReadView
- REPEATABLE READ:仅在事务中第一次执行快照读时生成ReadView,后续复用该ReadView
二、主从同步原理
MySQL主从复制的核心就是二进制日志
二进制日志(BINLOG)记录了所有的DDL(数据定义语言)语句和DML(数据操纵语言)语句,但不包括数据查询(SELECT、SHOW)语句
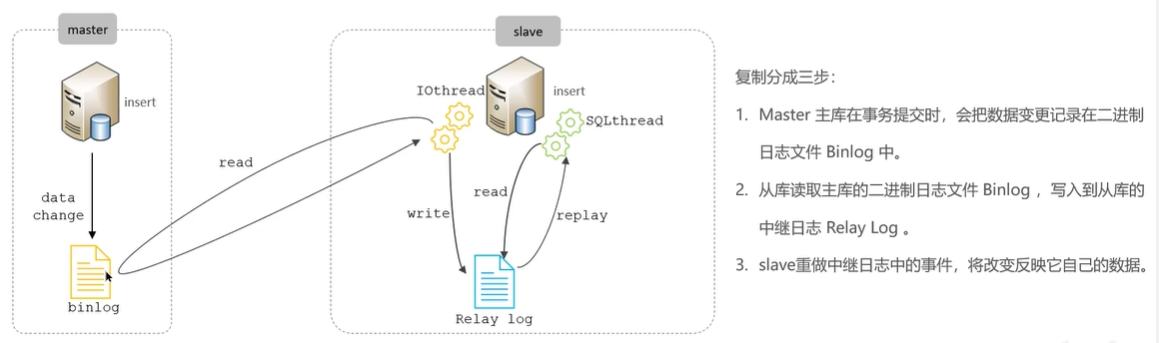
MySQL主从复制的核心就是二进制日志binlog(DDL和DML)
- 主库在事务提交时,会把数据变更记录在二进制日志文件Binlog中
- 从库读取主库的二进制日志文件binlog,写入到从库的中级日志Relay Log
- 从库重做中继日志中的事件,将改变反映它自己的数据
三、分库分表
分库分表时机:
- 项目业务逐渐增多,或业务发展比较迅速 单表数据量达1000W或20G以后
- 优化已解决不了性能问题(主从读写分离、查询索引…)
- IO瓶颈(磁盘IO,网络IO),CPU瓶颈(聚合查询、连接数太多)
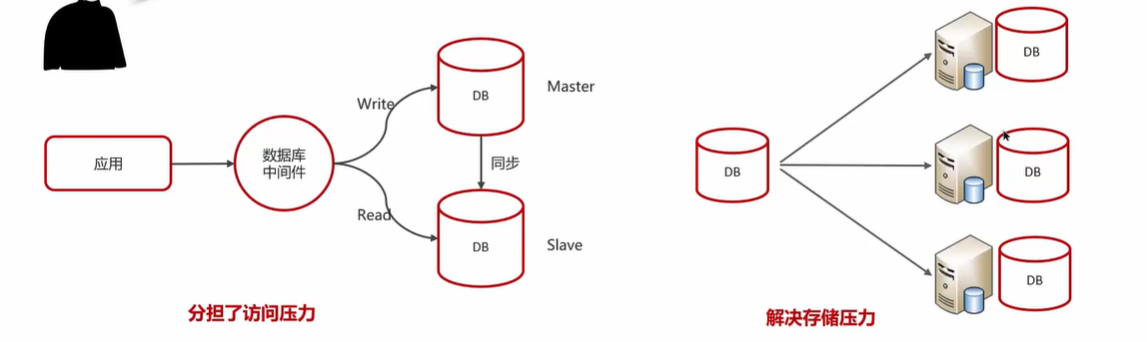
垂直分库
以表为依据,根据业务将不同表拆分到不同库中
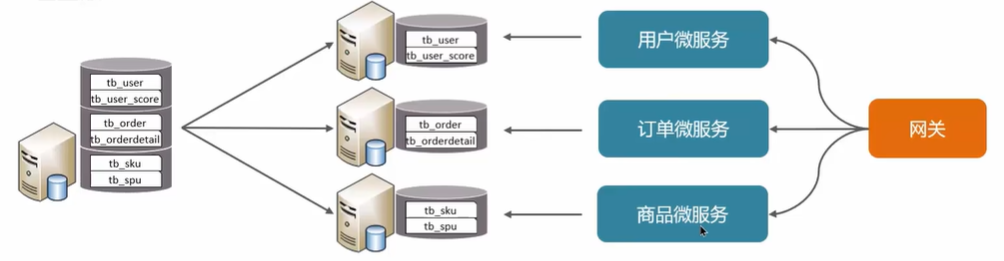
- 按业务对数据分级管理、维护、监控、扩展
- 在高并发下,提高磁盘IO和数据量连接数
垂直分表
以字段为依据,根据字段属性将不同字段拆分到不同表中
拆分规则:
- 把不常用的字段单独放在一张表
- 把text,blob等大字段拆分出来放在附表中
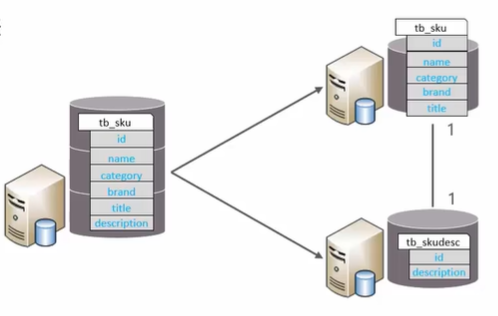
- 冷热数据分离
- 减少IO过渡争抢,两表互不影响
水平分库
将一个库的数据拆分到多个库中
路由规则:
- 根据id节点取模
- 按id也就是范围路由,节点1(1-100万),节点2(100万-200万)
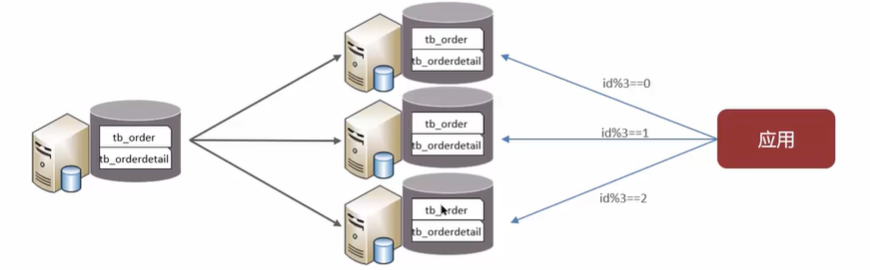
- 解决了单库大数量,高并发的性能瓶颈问题
- 提高了系统的稳定性和可用性
水平分表
将一个表的数据拆分到多个表中(可以在同一个库内)
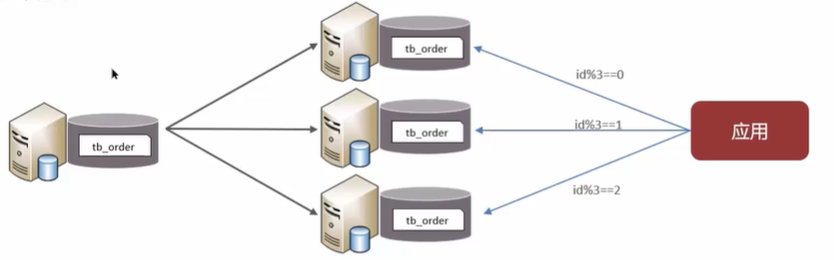
- 优化单一表数据量过大而产生的性能问题
- 避免IO争抢并减少缩表的几率
策略
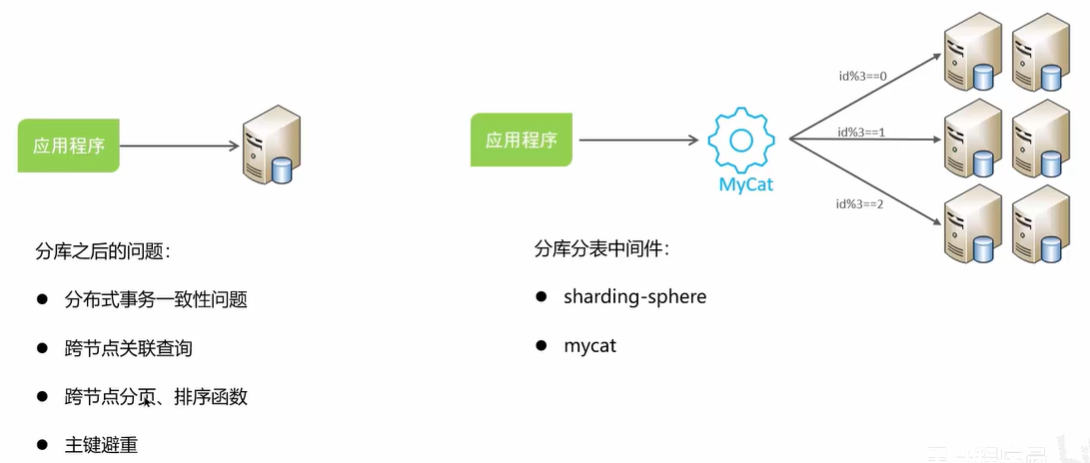
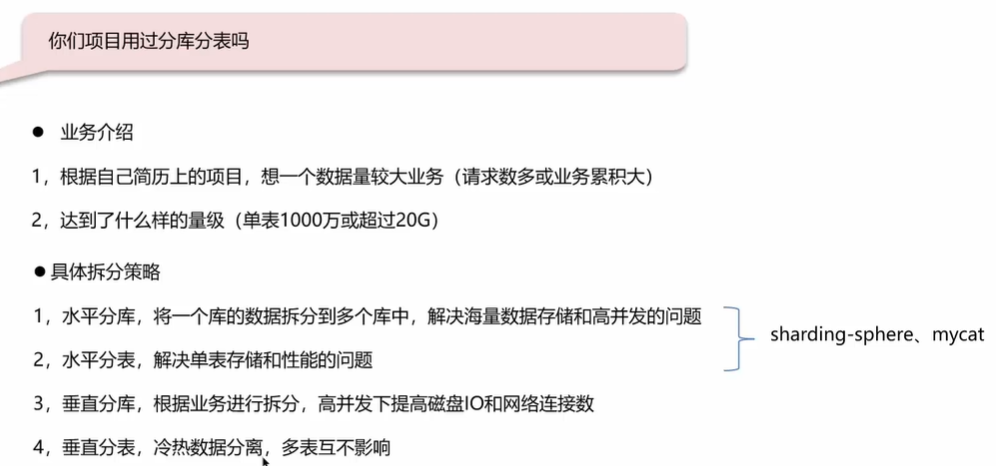
第三章 框架
3.1Spring
一、Spring框架中的单例bean是线程安全的吗?
@Service
@Scope("singleton")
public class UserServiceIpml implements UserService{

}- singleton:bean在每个Spring IOC容器中只有一个实例
- prototype:一个bean的定义可以有多个实例
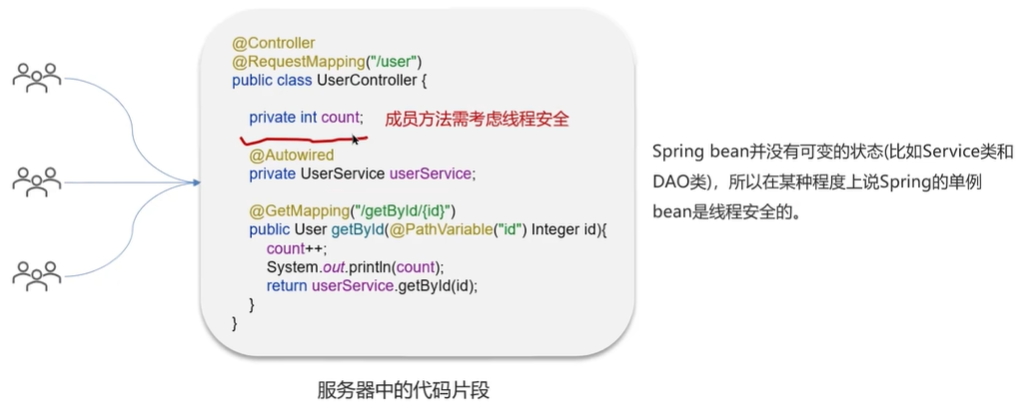
解答:
不是线程安全的
Spring框架中有一个@Scope注解,默认的值就是singleton,单例的
因为一般在Spring的bean中都是驻入无状态的对象,没有线程安全问题,如果在bean中定义了可修改的成员变量,是要考虑线程安全问题的,可以使用多例或者加锁来解决
二、AOP
AOP称为面向切面编程,用于将那些与业务无关,但却对多个对象产生影响的公共行为和逻辑,抽取并封装为一个可重用的模块,这个模块被命名为”切面”(Aspect),减少系统中的重复代码,降低了模块间的耦合度,同时提高了系统的可维护性。
常见的AOP使用场景:
- 记录操作日志
- 缓存处理
- Spring中内置的事务处理
记录操作日志思路
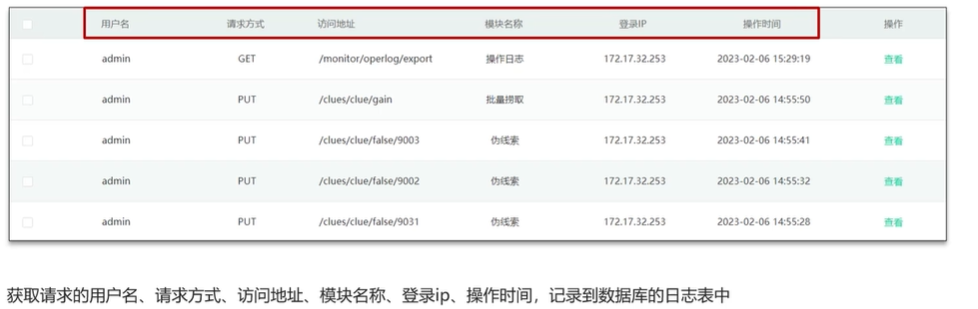
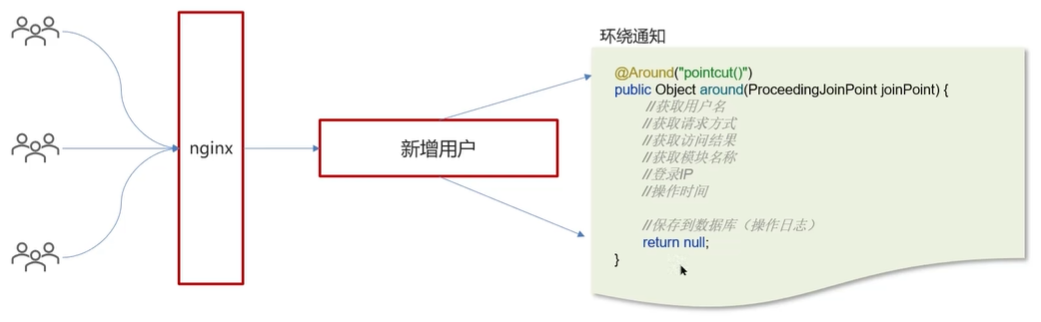
Spring中的事务是如何实现的?
Spring支持编程式事务管理和声明式事务管理两种方式
- 编程式事务管理:需使用TransactionTemplate来进行实现,对业务代码有侵入性,项目中很少使用
- 声明式事务管理:声明式事务管理建立在AOP之上,其本质是通过AOP功能,对方法前后进行拦截,将事务处理的功能编织到拦截的方法中,也就是在目标方法开始前加入一个事务,在执行完目标方法之后根据执行情况提交或回滚事务
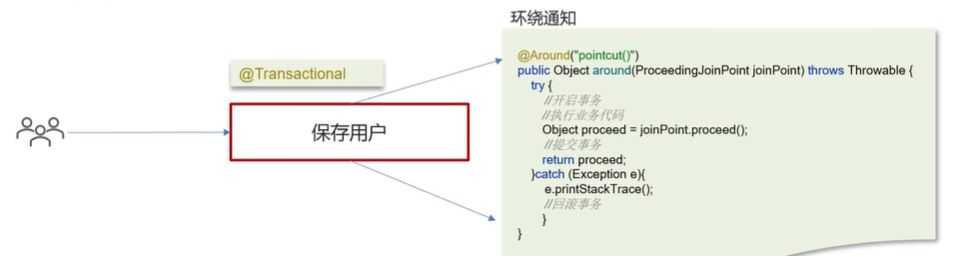
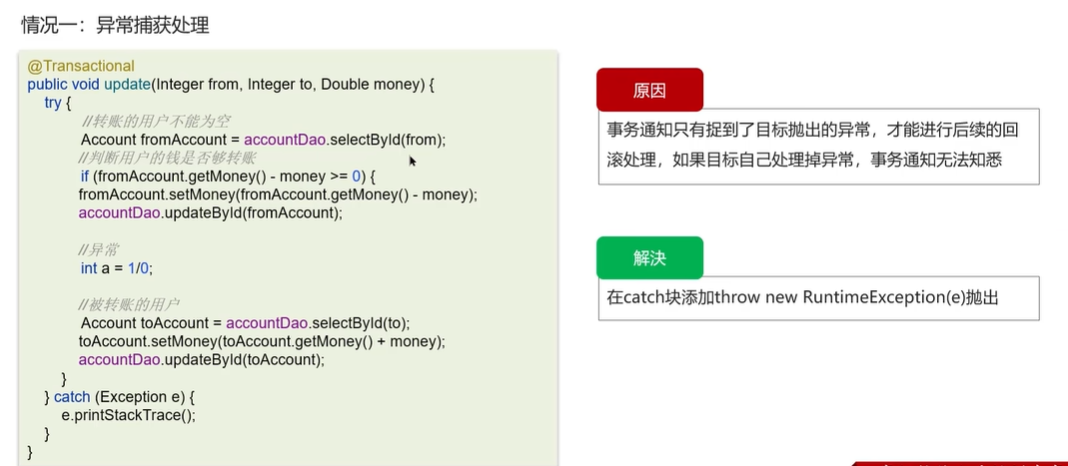
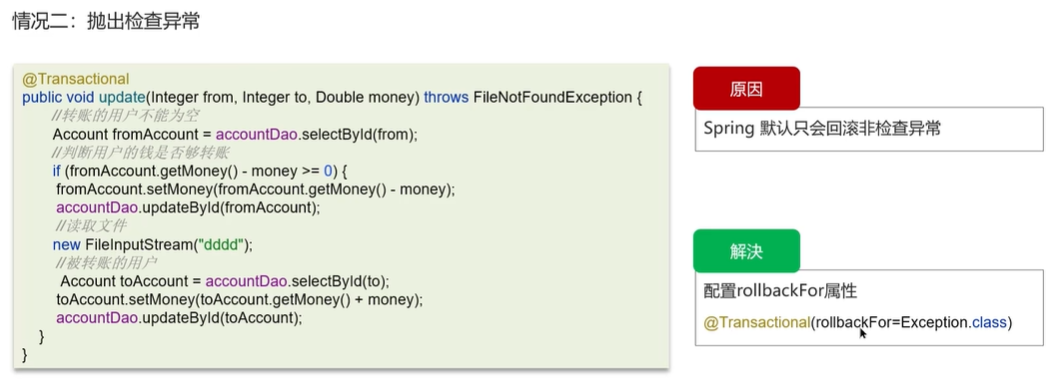
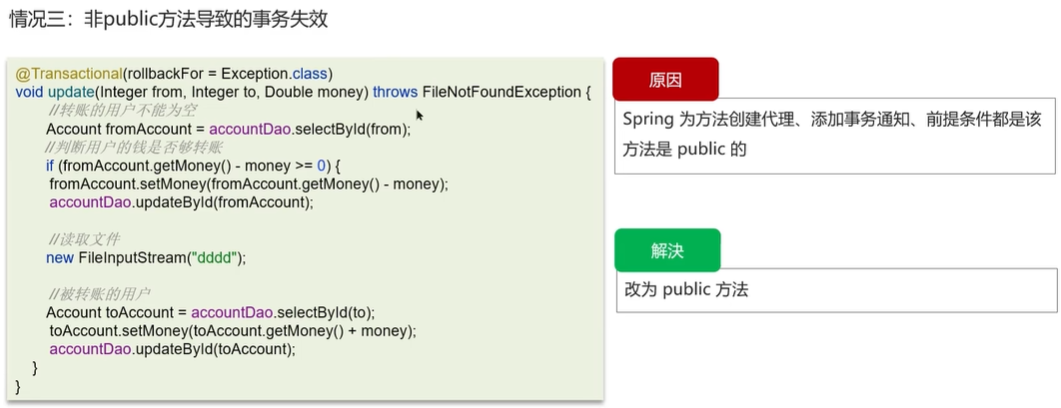
事务失效的场景
- 异常捕获处理
- 抛出检查异常
- 非public方法
三、bean的声明周期
BeanDefinition: bean的定义信息
Spring容器在进行实例化时,会将xml配置的<bean>的信息封装成一个BeanDefinition对象,Spring根据BeanDefinition来创建Bean对象,里面有很多的属性用来描述Bean
- beanClassName:bean的类名
- initMethodName:初始化方法名称
- properryValues:bean的属性值
- scope:作用域
- lazyInit:延迟初始化
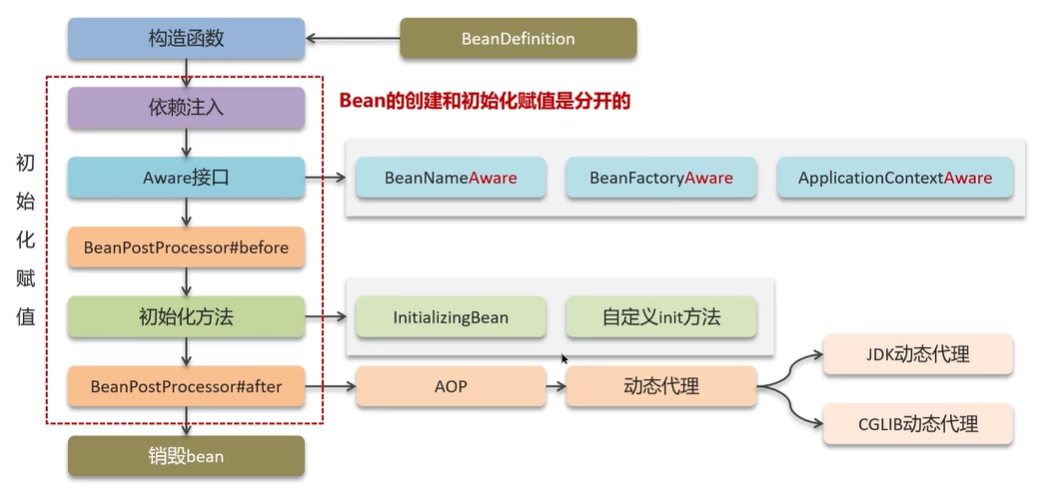
1、通过BeanDefinition获取bean的定义信息
2、调用构造函数实例化bean
3、bean的依赖注入
4、处理Aware接口(BeanNameAware、BeanFactoryAware、ApplicationContextAware)
5、Bean的后置处理器BeanPostProcessor-前置
6、初始化方法(InitializingBean、init-method)
7、Bean的后置处理器BeanPostProcessor-后置
8、销毁bean
四、Spring的循环引用
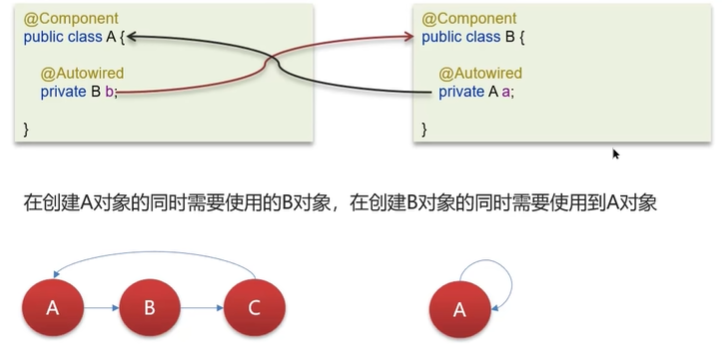
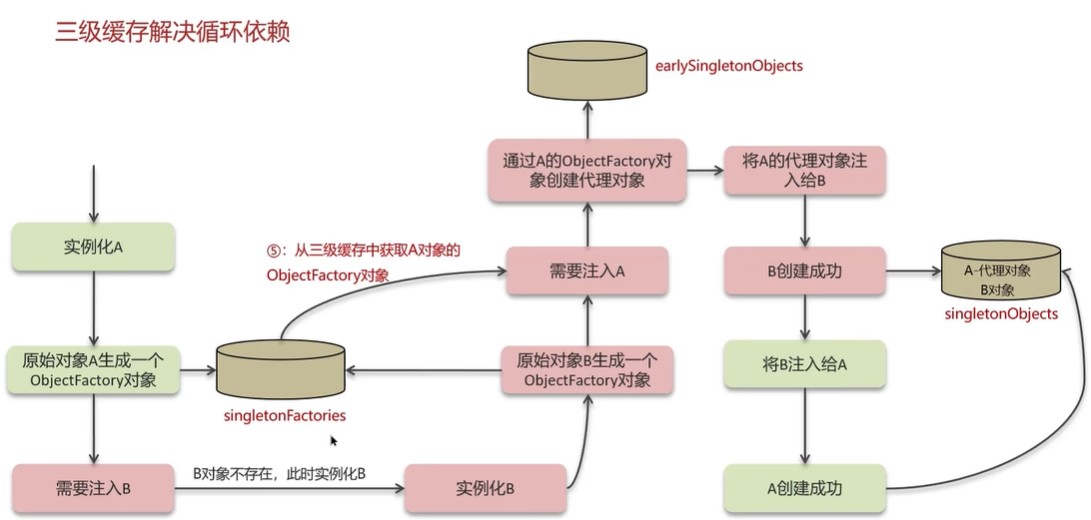
循环依赖
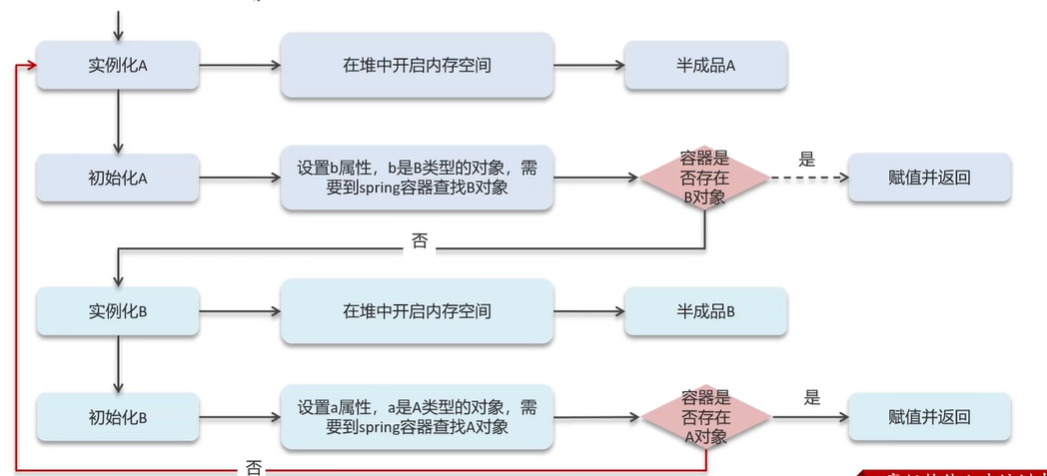
Spring解决循环依赖是通过三级缓存,对应的三级缓存如下:
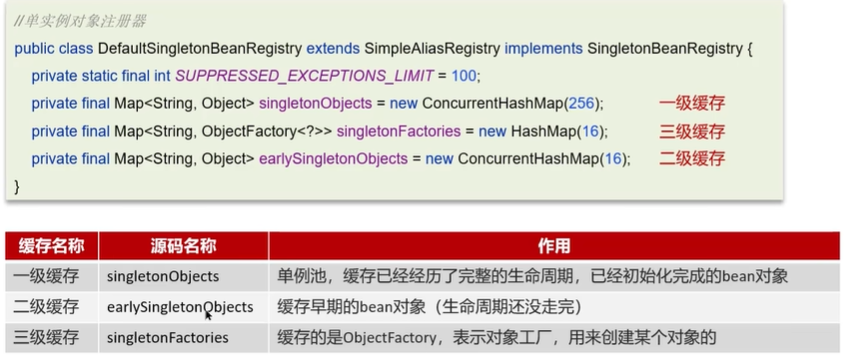
一级缓存作用:限制bean在beanFactory中只存一份,即实现singleton scope,解决不了循环依赖
如果想打破循环依赖,就需要一个中间人的参与,这个中间人就是二级缓存
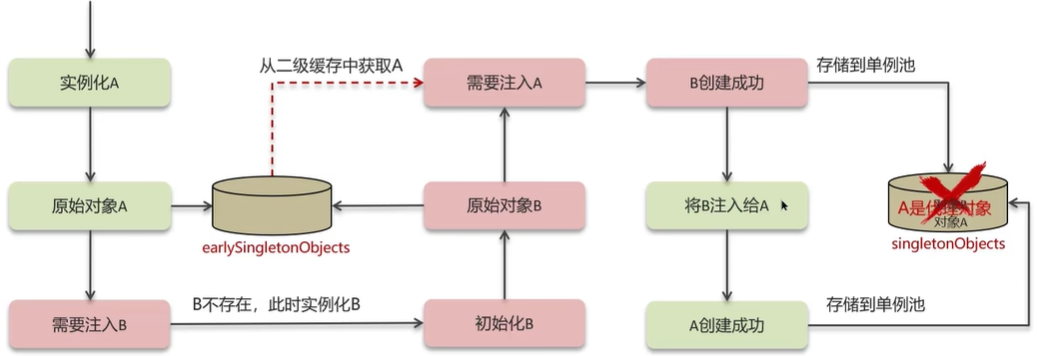
二级缓存可以解决一般对象的循环依赖问题,但是不能解决代理对象的循环依赖问题
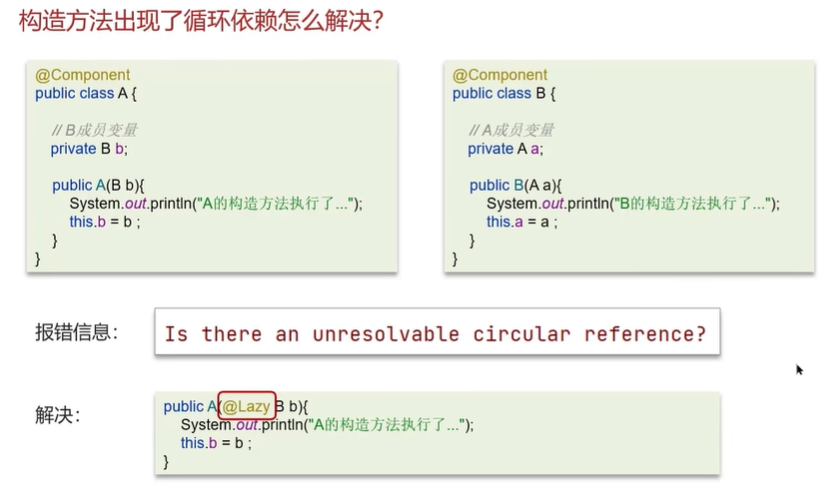
构造方法出现循环依赖问题怎么解决?
问题答案:
- 循环依赖:循环依赖其实就是循环引用,也就是两个或两个以上的bean互相持有对方,最终形成闭环,比如A依赖B,B依赖于A
- 循环依赖在spring中是允许存在的,spring框架依据三级缓存已经解决了大部分的循环依赖
1、一级缓存:单例池,缓存已经经历了完整的生命周期,已经初始化完成的bean对象
2、二级缓存:缓存早期的bean对象(生命周期还没走完)
3、三级缓存:缓存的是ObjectFactory,表示对象工厂,用来创建某个对象的
构造方法出现循环依赖问题怎么解决?
- A依赖于B,B依赖于A,注入的方式是构造函数
- 由于bean的生命周期中构造函数是第一个执行的,spring框架并不能解决构造函数的依赖注入
- 使用@Lazy进行懒加载,什么时候需要对象再进行bean对象的创建
3.2SpringMVC
一、SpringMVC的执行流程
视图阶段(老旧JSP等)
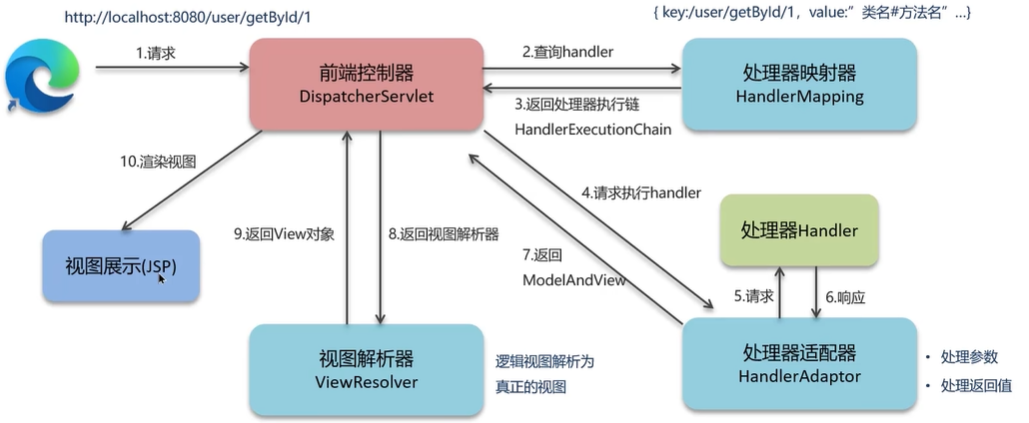
- 用户发送出请求到前端控制器DispatcherServlet
- DispatcherServlet收到请求后调用HandlerMapping(处理器映射器)
- HandlerMapping找到具体的处理器,生成处理器对象及处理器拦截器(如果有),再一起返回给DispatcherServlet
- DispatcherServlet调用HandlerAdaptor(处理器适配器)
- HandlerAdaptor经过适配调用具体的处理器(Handler/Controller)
- Controller执行完成返回ModelAndView对象
- HandlerAdaptor将Controller执行的结果ModelAndView返回给DispatcherServlet
- DispatcherServlet将ModelAndView传给ViewReslover(视图解析器)
- ViewReslover解析后返回具体的View(视图)
- DispatcherServlet根据View进行渲染视图(即将模型数据填入至视图中)
- DispatcherServlet响应用户
前后端分离阶段(接口开发,异步)
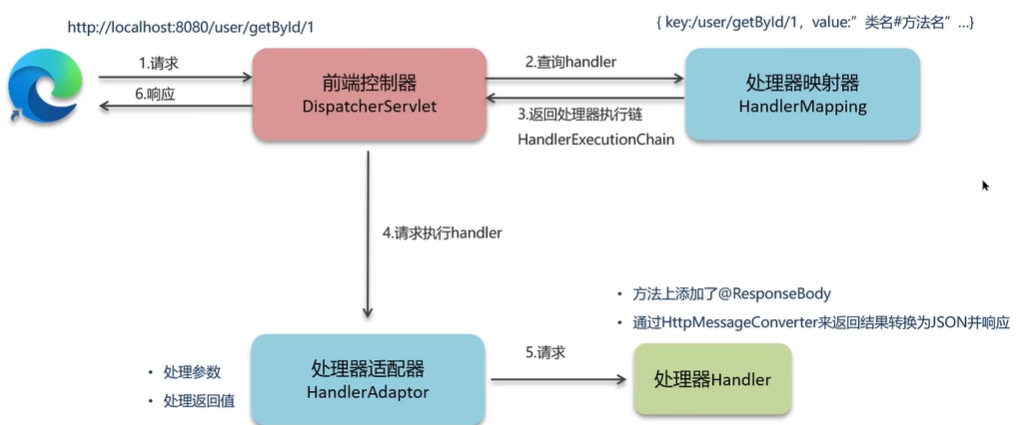
- 用户发送出请求到前端控制器dispatcherServlet
- DispatcherServlet收到请求调用HandlerMapping(处理器映射器)
- HandlerMapping找到具体的处理器,生成处理器对象及处理器拦截器(如果有),再一起返回给DispatcherServlet
- DispatcherServlet调用HandlerAdaptor(处理器适配器)
- HandlerAdaptor经过适配器调用具体的处理器(Handler/Controller)
- 方法上添加了@ResponseBody
- 通过HttpMessageConverter来返回结果转换为JSON并响应
3.3SpringBoot
一、自动配置原理
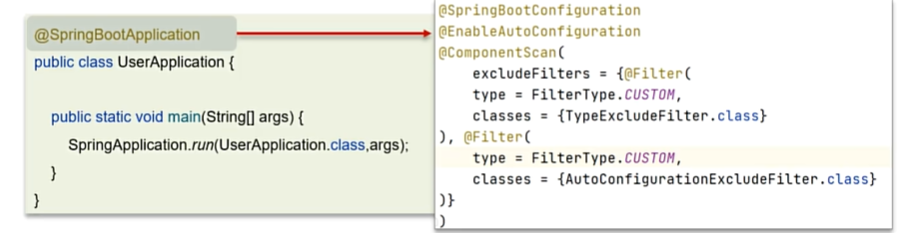
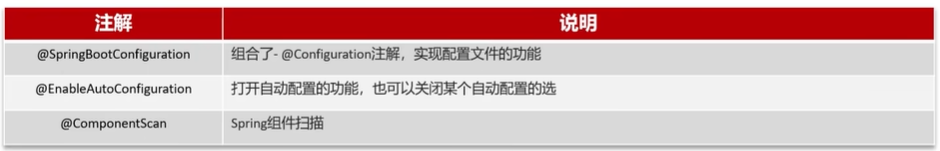
- **@SpringBootConfiguration:**该注解与@Configuration注解作用相同,用来声明当前也是一个配置类
- **@ComponentScan:**组件扫描,默认扫描当前引导类所在包及其子包
- **@EnableAutoConfiguration:**SpringBoot实现自动化配置的核心注解

1、在SpringBoot项目中的引导类上有一个注解@SpringBootApplication,这个注解是对三个注解进行了封装,分别是:
- @SpringBootConfiguration
- @EnableAutoConfiguration
- @ComponentScan
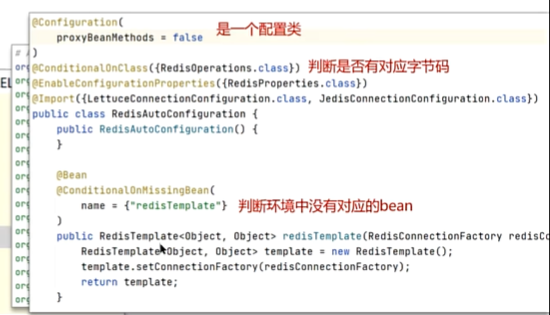
2、其中**@EnableAutoConfiguration是实现自动化配置的核心注解,该注解通过@Import注解导入对应的配置选择器,内部就是读取了该项目和该项目引用的jar包的classpath路径下的META-INF/spring.factories文件中的所配置的类的全类名。在这些配置类中所定义的Bean会根据条件注解所指定的条件来决定**是否需要将其导入到Spring容器中
3、条件判断会有像**@ConditionalOnClass**这样的注解,判断是否有对应的class文件,如果有则加载该类,把这个配置类的所有的Bean放入spring容器中使用
二、Spring框架常见注解
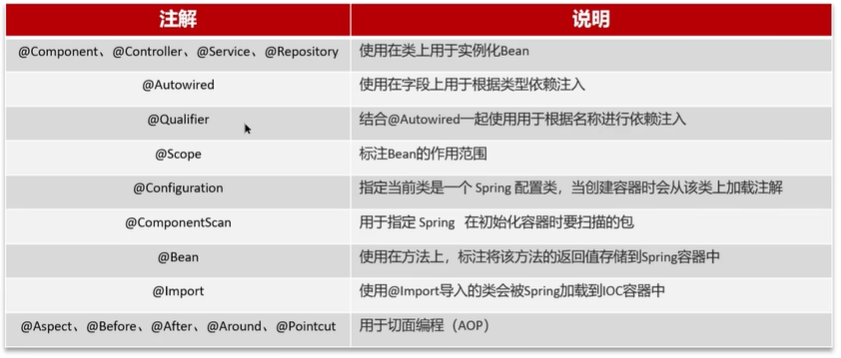
Spring中:
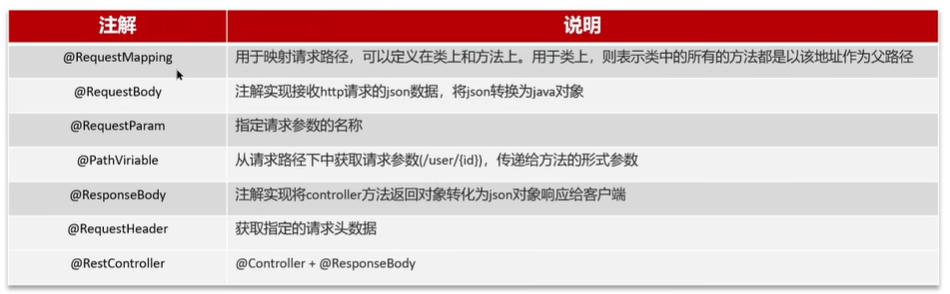
SpringMVC中:
SpringBoot中:
3.4Mybatis
一、Mybatis执行流程
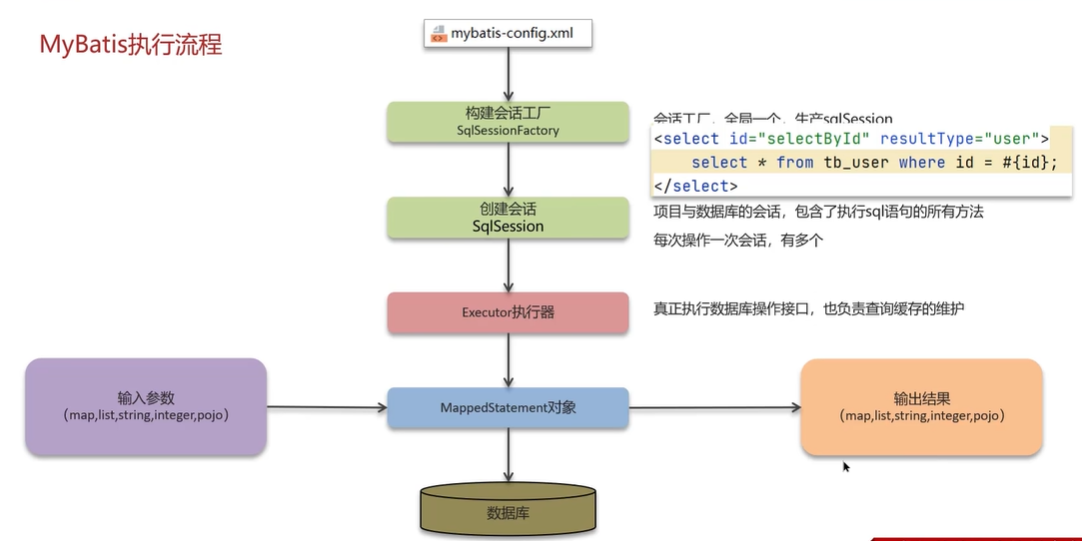
1、读取MyBatis配置文件:mybatis-config.xml加载运行环境和映射文件
2、构造会话工厂SqlSessionFactory
3、会话工厂创建SqlSession对象(包含了执行SQL语句的所有方法)
4、操作数据库的接口,Executor执行器,同时负责查询缓存的维护
5、Executor接口的执行方法中有一个MappedStatement类型的参数,封装了映射信息
6、输入参数映射
7、输出结果映射
二、Mybatis是否支持延迟加载?
支持,默认不开启
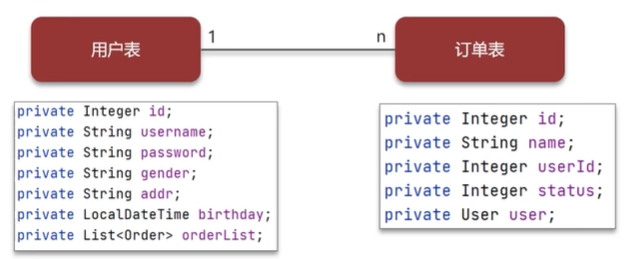
**立即加载:**查询用户时候,把用户所属订单数据也查询出来
**延迟加载:**查询用户时候,暂时不查询订单数据,当需要时,再去查询订单
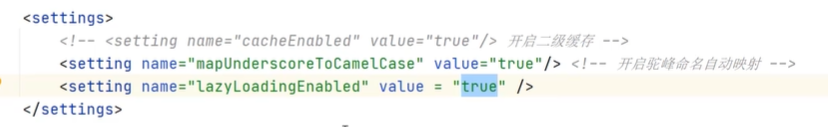
某个映射文件设置懒加载:fetchType = “lazy”
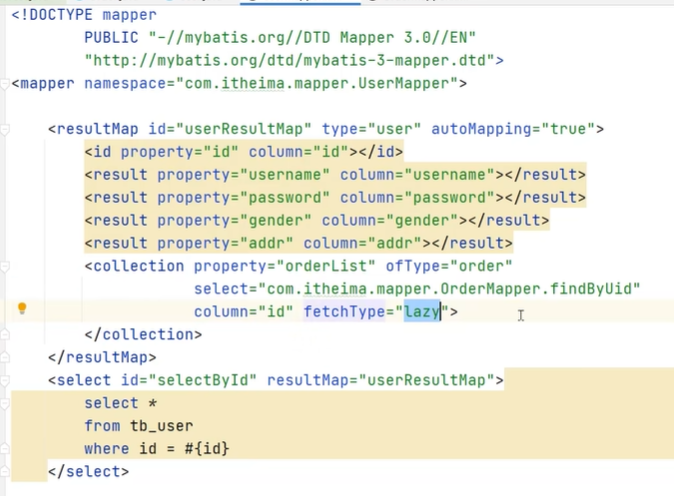
全局设置延迟加载(在mybatis配置文件中设置):lazyLoadingEnabled true
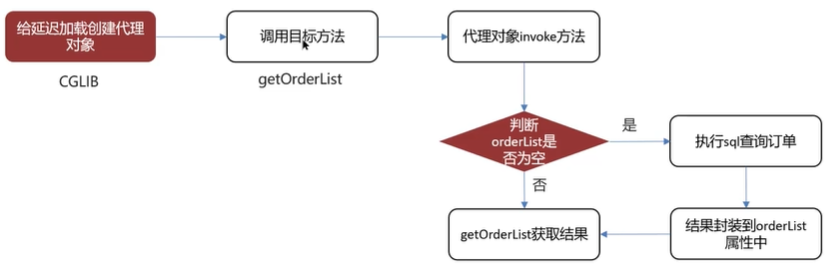
延迟加载底层原理
1、使用CGLIB创建目标对象的代理对象
2、当调用目标方法时,进入拦截器invoke方法,发现目标方法是null值,执行sql查询
3、获取数据后,调用set方法设置属性值,再继续查询目标方法,就有值了
三、Mybatis的一级、二级缓存
本地缓存,基于PerpetualCache,本质是一个HashMap
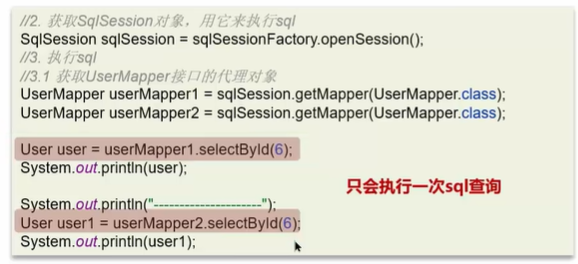
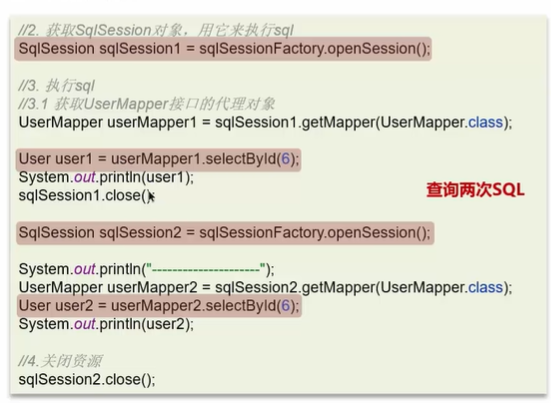
**一级缓存:**作用域是session(sqlSession)级别
基于PerpetualCache的HashMap本地缓存,其存储作用域为Session,当Session进行flush或close之后,该Session中的所有Cache就将清空,默认打开一级缓存
**二级缓存:**作用域是namespace和mapper的作用域,不依赖于session
基于namespace和mapper的作用域起作用的,不是依赖于SQL session,默认也是采用PerpetualCache,HashMap存储,需要单独开启,一个是核心配置,一个是mapper映射文件。
二级缓存默认是关闭的
开启:
1、全局配置文件
<settings>
	<setting name="cacheEnabled" value="true"/>
</settings>
2、映射文件
使用<cache/>标签让当前mapper生效二级缓存
注意事项:
二级缓存扫描时候会清理缓存中的数据 答案在第一条
- 对于缓存数据更新机制,当某一个作用域(一级缓存 Session/二级缓存 Namespaces)进行了新增,修改,删除操作后,默认该作用域下的所有的select中的缓存将被clear
- 二级缓存需要缓存的数据实现Serializable接口
- 只有会话提交或者关闭以后,一级缓存中的数据才会转移到二级缓存中
第四章 微服务&消息中间件
SpringCloud相关问题
一、SpringCloud5大组件
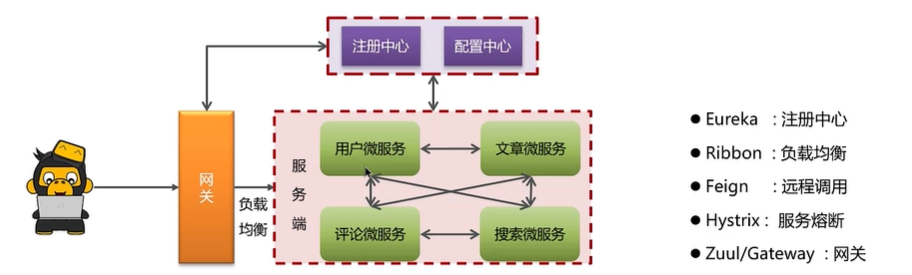
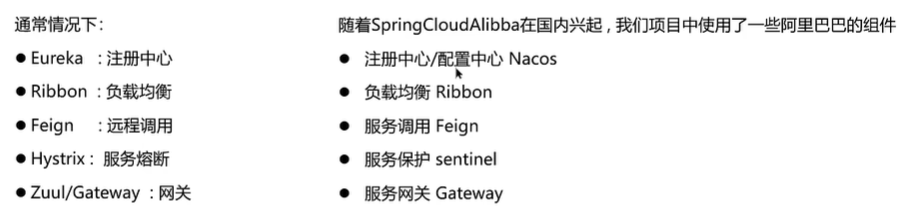
4.1服务注册
一、服务注册和服务发现是什么意思?SpringCloud如何实现服务注册发现的?
**服务注册:**服务提供者需要把自己的信息注册到Eureka,由Eureka来保存这些信息,比如服务名称,ip,端口等等
**服务发现:**消费者向Eureka拉取服务列表信息,如果服务提供者有集群,则消费者会利用负载均衡算法,选择一个发起调用
**服务监控:**服务提供者会每隔30s向Eureka发送心跳,报告健康状态,如果Eureka服务90s没接收到心跳,从Eureka中剔除
二、Nacos和Eureka的区别
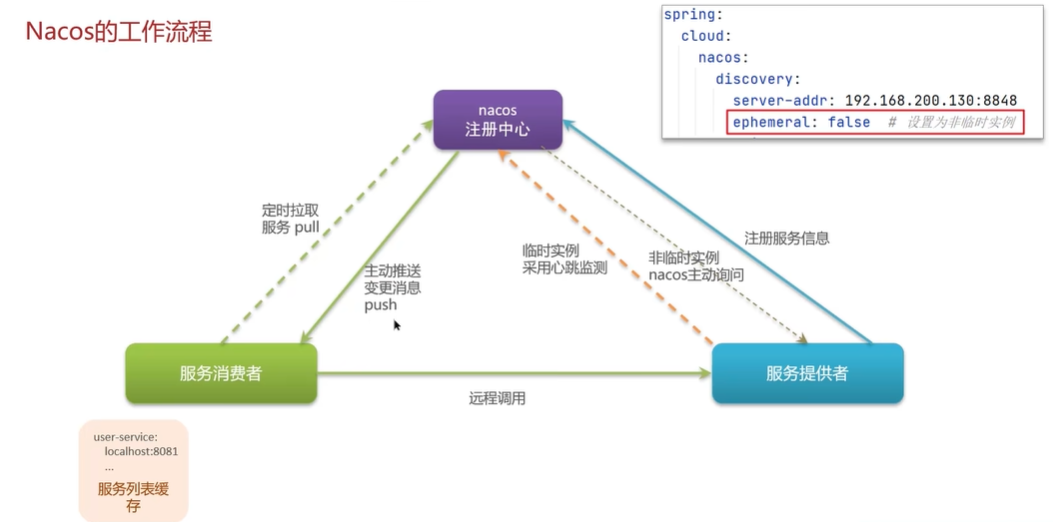
-
共同点
① 都支持服务注册和服务拉取
② 都支持服务提供者心跳方式做健康检测
-
区别
① Nacos支持服务端主动检测提供者状态:临时实例采用心跳模式,非临时实例采用主动检测模式
② 临时实例心跳不正常会被剔除,非临时实例则不会被剔除
③ Nacos支持服务列表变更的消息推送模式,服务列表更新更加及时
④ Nacos集群默认采用AP(高可用)方式,当集群中存在非临时实例时,采用CP(强一致)模式;Eureka采用AP方式
-
Nacos还支持了配置中心,Eureka则只有注册中心,也是选择使用Nacos的一个重要原因
4.2负载均衡
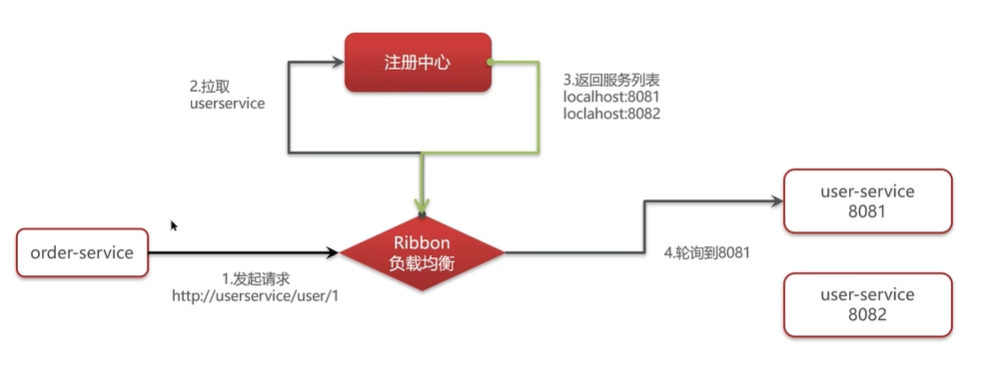
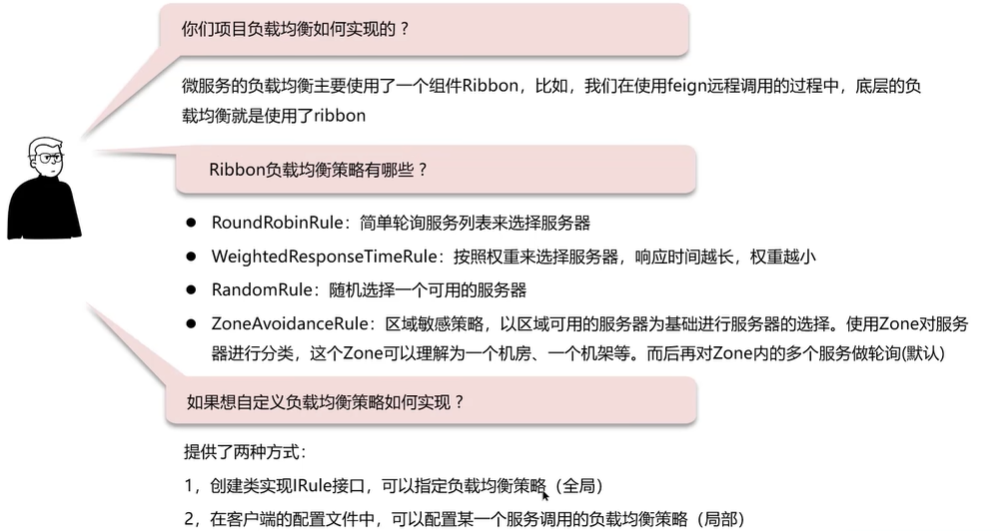
一、Ribbon负载均衡的流程
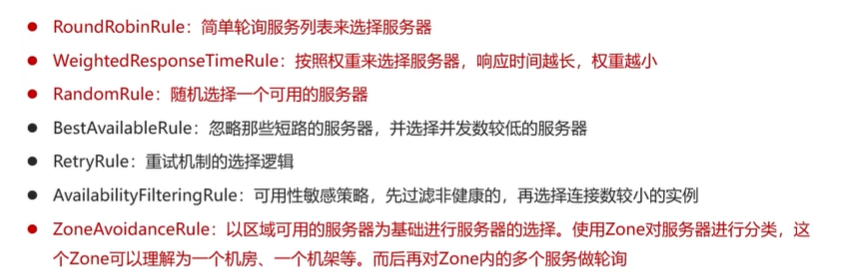
二、Ribbon负载均衡策略有哪些?
三、自定义负载均衡策略怎么实现?
可以自己创建类实现IRule接口,然后再通过配置类或者配置文件配置即可,通过定义IRule实现可以修改负载均衡规则,有两种方式:
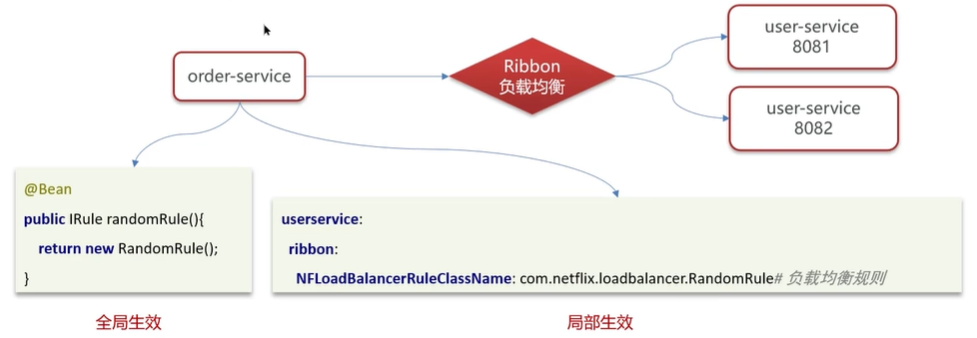
4.3熔断、降级
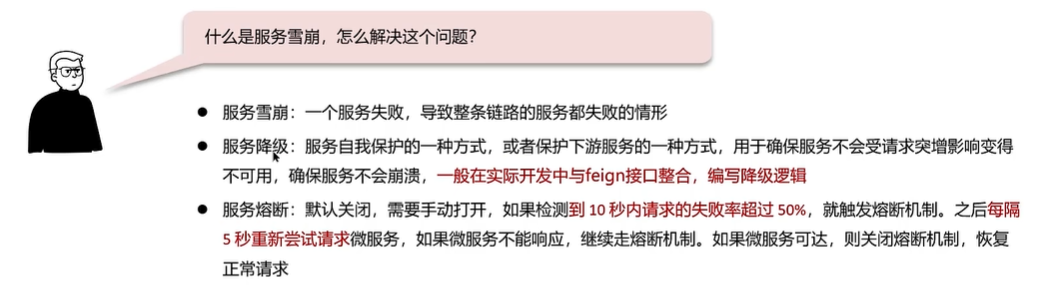
一、什么是服务雪崩,怎么解决?
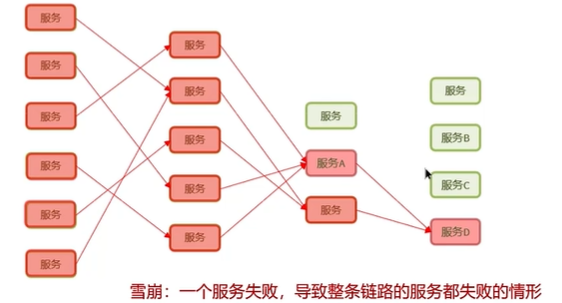
预防:限流
解决:Hystix 服务熔断降级[hɪst’rɪks]
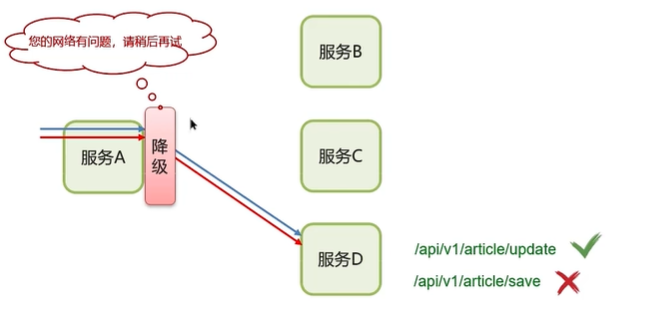
服务降级
服务降级是服务自我保护的一种方式,或者保护下游服务的一种方式,用于确保服务不会受请求突增影响变得不可用,确保服务不会崩溃
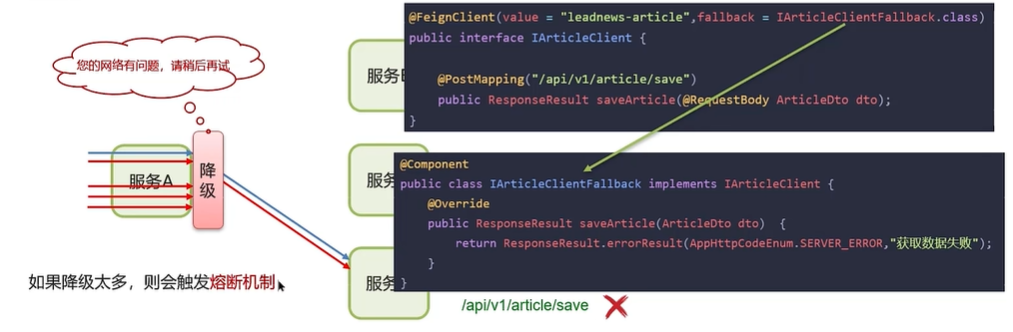
服务熔断
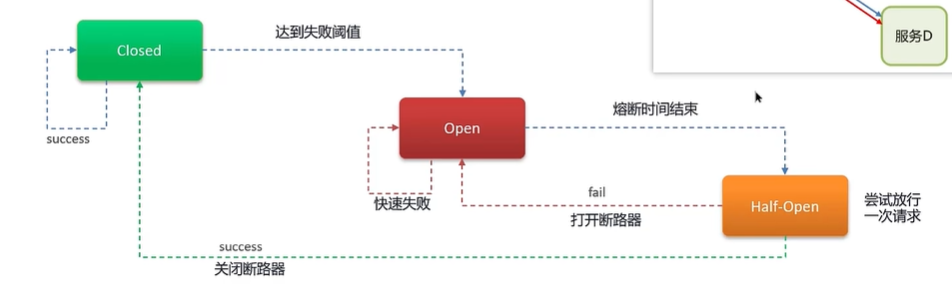
Hystrix熔断机制,用于监控微服务调用情况,默认是关闭的,如果需要开启需要在引导类上添加注解:@EnableCircuitBreaker,如果检测到10秒内请求的失败率超过50%,就触发熔断机制,之后每隔5秒重新尝试请求微服务,如果微服务不能响应,继续走熔断机制。如果微服务可达,则关闭熔断机制,恢复正常请求。
4.4监控
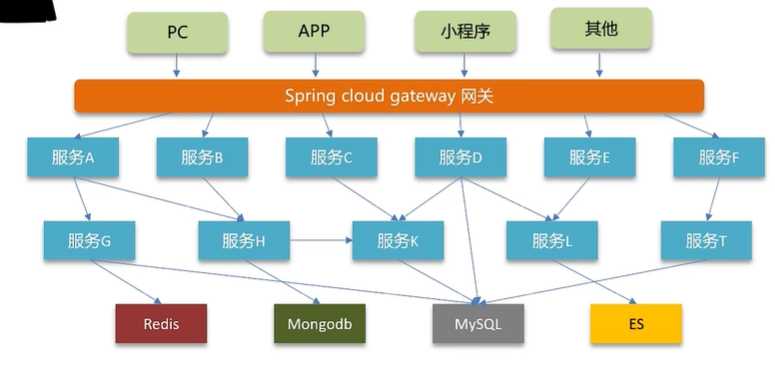
一、为什么需要监控
- 问题定位
- 性能分析
- 服务关系
- 服务告警
- Springboot-admin
- prometheus + Grafana
- zipkin(链路追踪工具)
- skywalking(链路追踪工具)
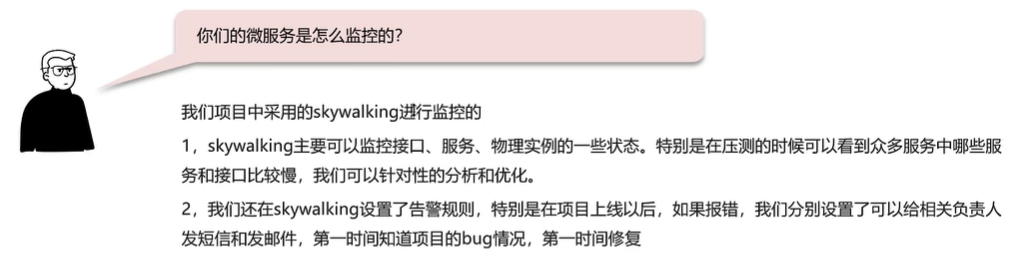
skywalking
一个分布式系统的应用程序性监控工具(Application Performance Managment),提供了完善的链路追踪能力,apache的的顶级项目(前华为产品经理吴晟主导开源)
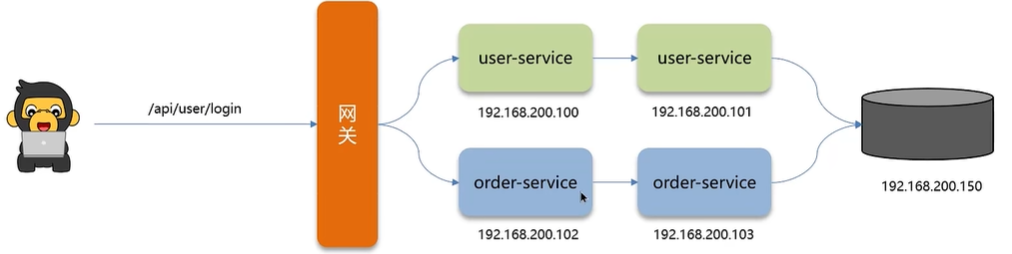
- 服务(service):业务资源应用系统(微服务)
- 端点(endpoint):应用系统对外暴露的功能接口(接口)
- 实例(instance):物理机
业务问题
4.5限流
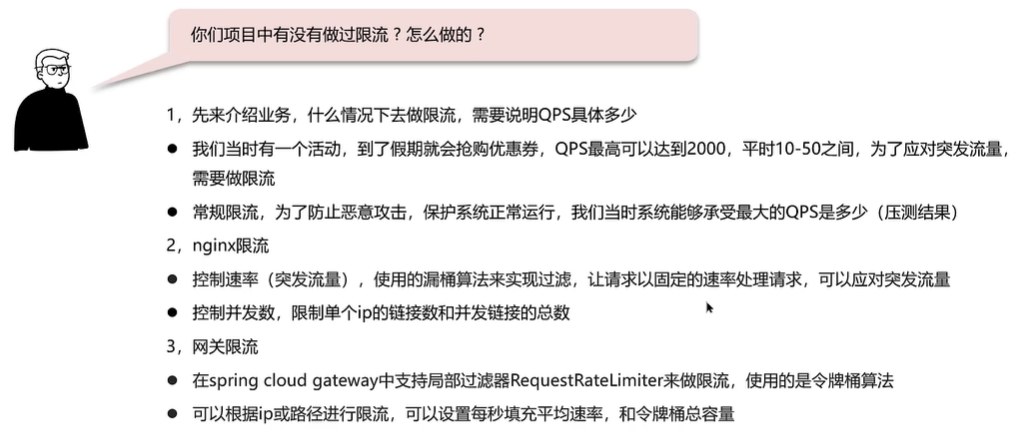
为什么要限流?
1、并发的确大(突发流量)
2、防止用于恶意刷接口
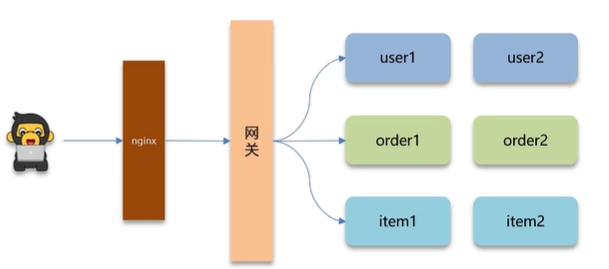
限流的实现方式:
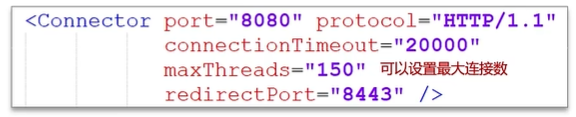
一、Tomcat:可以设置最大连接数(单项目推荐,分布式不推荐)
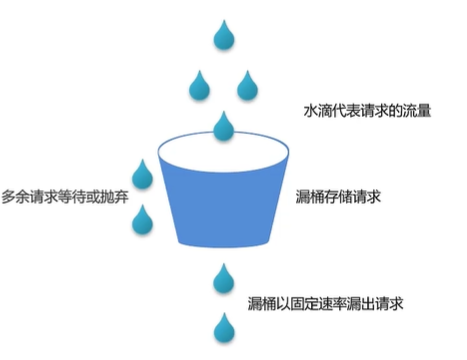
二、Nginx:漏桶算法(了解原理即可)
1、控制速率(突发流量)
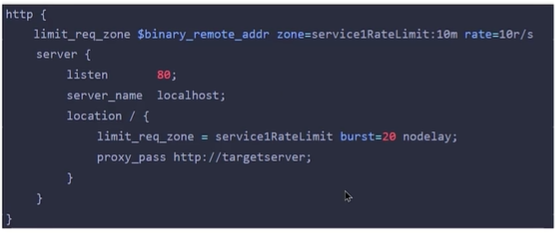
- 语法:limit_req_zone key zone rate
- key:定义限流对象,binary_remote_addr就是一种key,基于客户端ip限流
- Zone:定义共享存储区来存储访问信息,10m可以存储16wip地址访问信息
- Rate:最大访问速率,rate=10r/s 表示每秒最多请求10个请求
- burst=20:相当于桶的大小
- Nodelay:快速处理
2、控制并发连接数
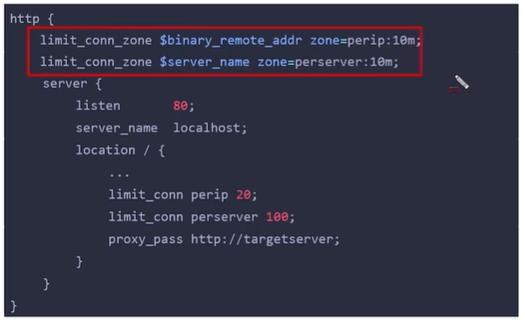
- limit_conn perip 20:对应的key是$binary_remote_addr,表示限制单个IP同时最多能持有20个连接
- limit_conn perserver 100:对应的key是$server_name,表示虚拟主机(server)同时能处理并发连接的总数
三、网关:令牌桶算法
yml配置文件中,微服务路由设置添加局部过滤器RequestRateLimiter
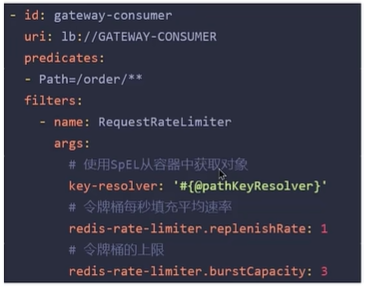
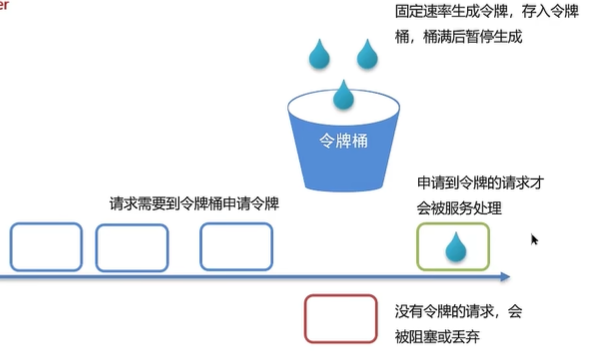
- key-resolver:定义限流对象(ip,路径,参数),需代码实现,使用spel表达式获取
- replenishRate:令牌桶每秒填充平均速率
- urstCapacity:令牌桶总容量
四、自定义拦截器
4.6分布式系统理论
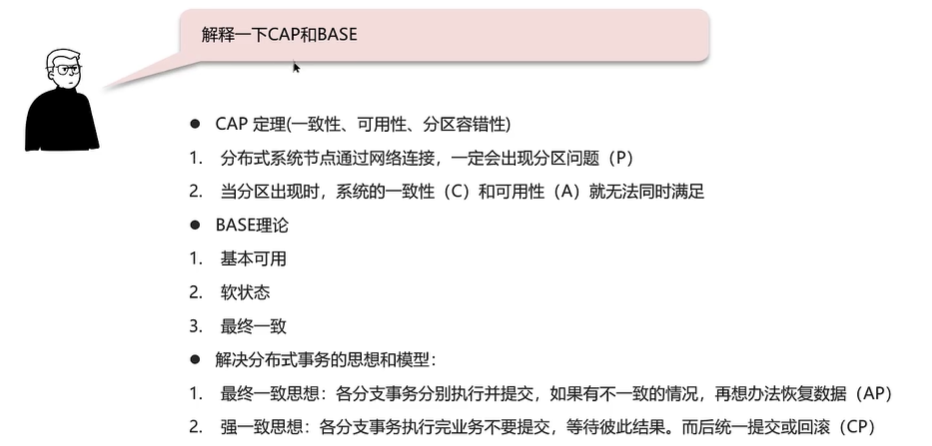
一、解释一下CAP定理和BASE理论
CAP
1998年,加州大学的计算机科学家Eric Brewer提出,分布式系统有三个指标:
- Consistency(一致性)
- Availability(可用性)
- Partiton tolerance(分区容错性)
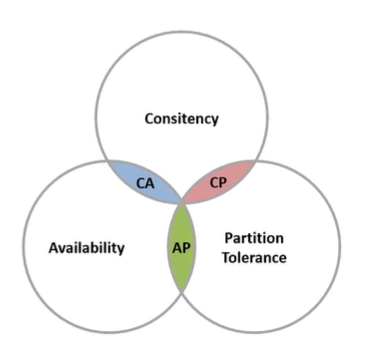
Eric Brewer说,分布式系统无法同时满足这三个指标。这个结论就叫做CAP定理
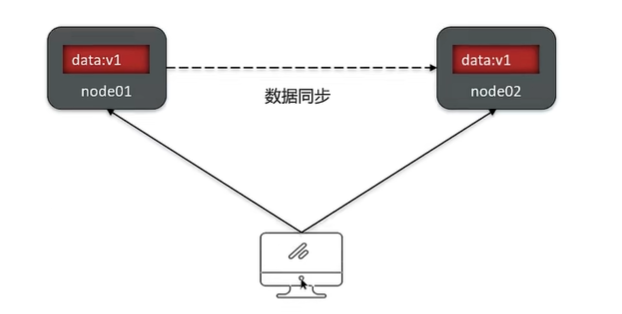
1、Consistency(一致性)
用户访问分布式系统中的任意节点,得到的数据必须一致
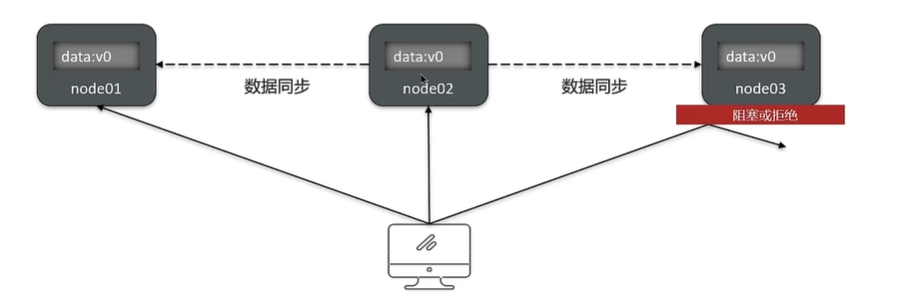
2、Availability(可用性)
用户访问集群中的任意健康节点,必须能得到响应,而不是超时或拒绝
3、Partiton tolerance(分区容错性)
Partiton (分区):因为网络故障或其它原因导致分布式系统中的部分节点与其它节点失去连接,形成独立分区
tolerance(容错):在集群出现分区时,整个系统也要持续对外提供服务
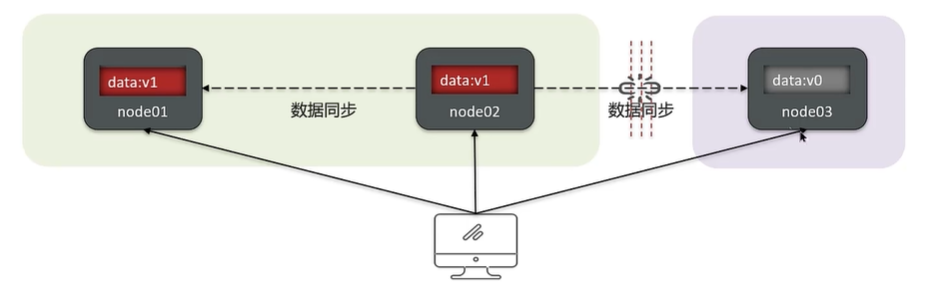
结论:
- 分布式系统节点之间肯定是需要网络连接的,分区(P)是必然存在的
- 如果保证访问的高可用性(A),可以持续对外提供服务,但不能保证数据的强一致性 —> AP
- 如果保证访问的数据强一致性(C),就要放弃高可用性—> CP
BASE
BASE理论是对CAP的一种解决思路,包括三个思想:
- Basically Available (基本可用):分布式系统在出现故障时,允许损失部分可用性,即保证核心可用。
- Soft State (软状态):在一定时间内,允许出现中间状态,比如临时的不一致状态
- Eventually Consistent (最终一致性):虽然无法保证强一致性,但是在软状态结束后,最终达到数据一致
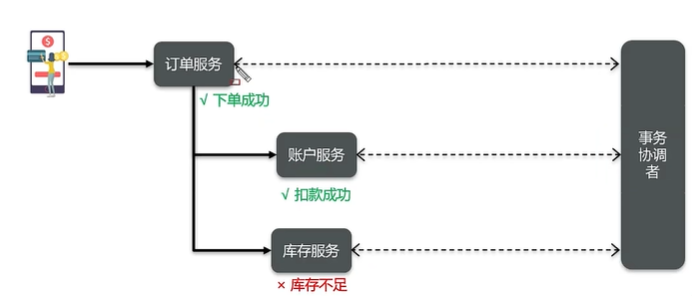
4.7分布式事务
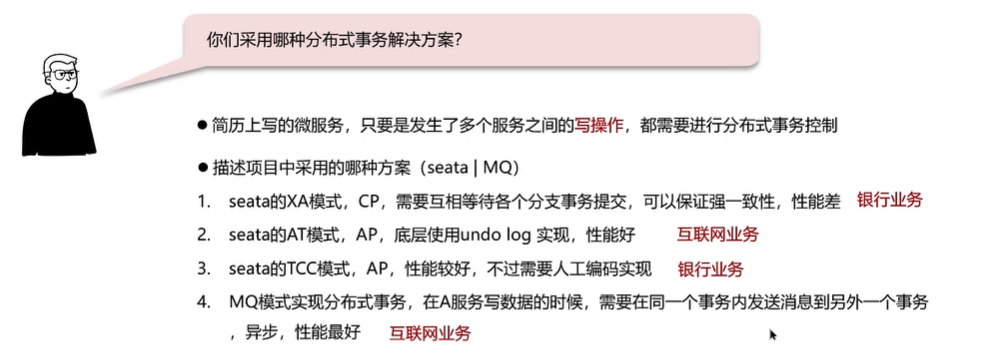
一、分布式事务解决方案
1、Seata框架(XA、AT、TCC)
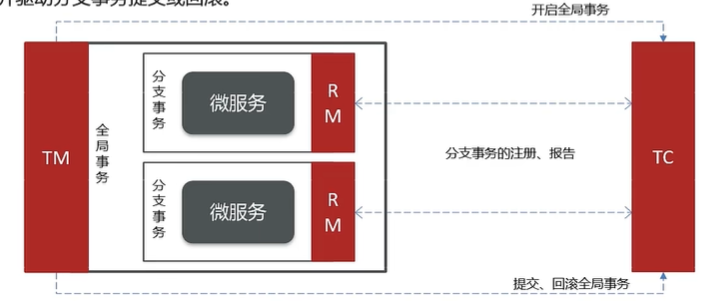
Seata事务管理中有三个重要的角色
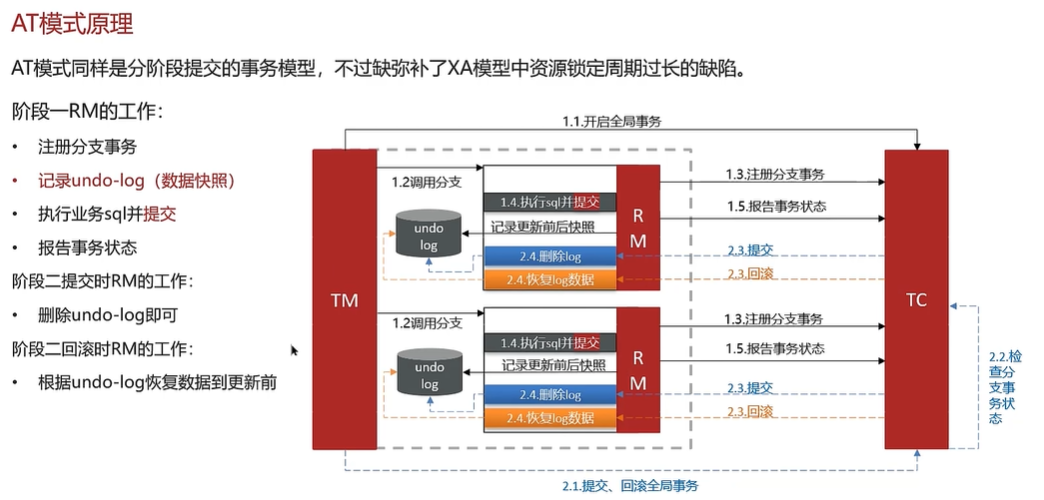
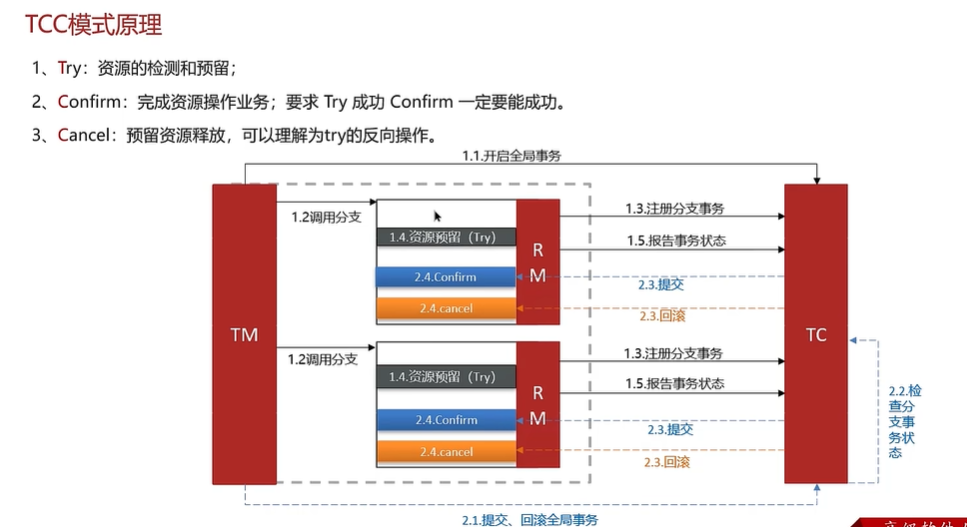
- **TC(Transaction Coordinator) - 事务协调者:**维护全局和分支事务的状态,协调全局事务提交或回滚
- **TM(Transaction Manager) - 事务管理者:**定义全局事务的范围,开始全局事务、提交或回滚全局事务
- **RM(Resource Manager) - 资源管理器:**管理分支事务处理的资源,与TC交谈以注册事务和报告分支事务的状态,并驱动分支事务提交或回滚。
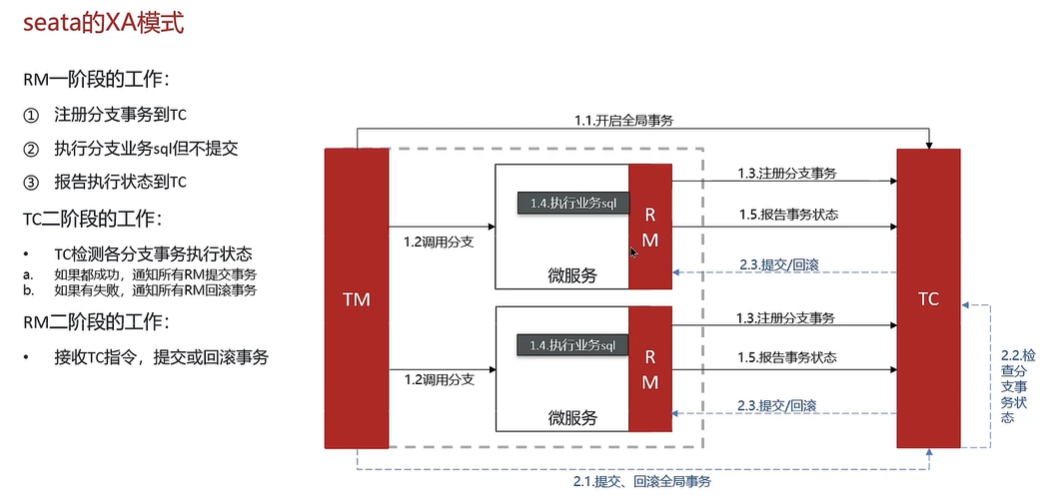
XA模式
AT模式
TCC模式
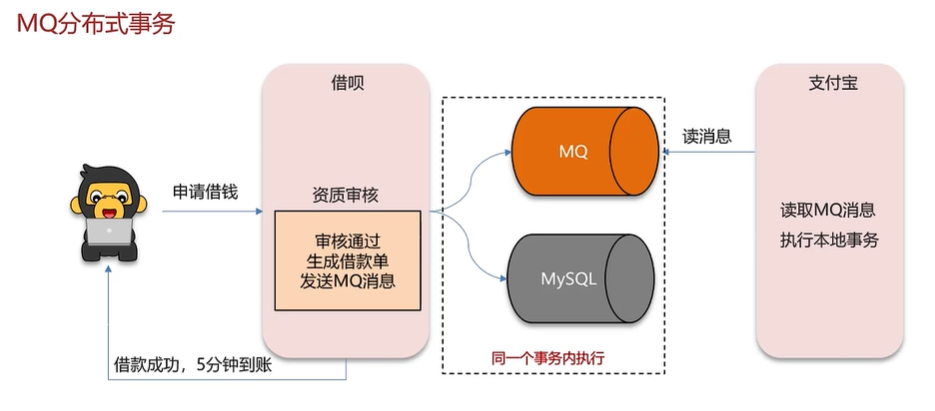
2、MQ
4.8分布式服务接口幂等
幂等:多次调用方法或者接口不会改变业务状态,可以保证重复调用的结果和单次调用的结果一致
需要幂等场景
- 用户重复点击(网络波动)
- MQ消息重复
- 应用使用失败或超时重试机制
接口幂等
基于RESTful API的角度对部分常见类型请求的幂等性特点进行分析
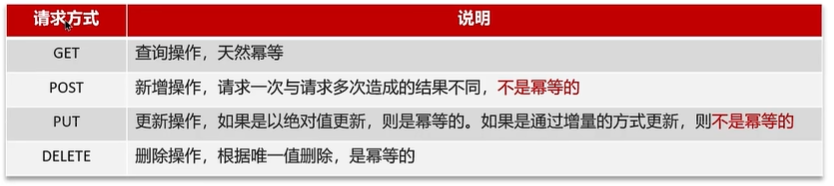
解决方案
- 数据库唯一索引 :新增
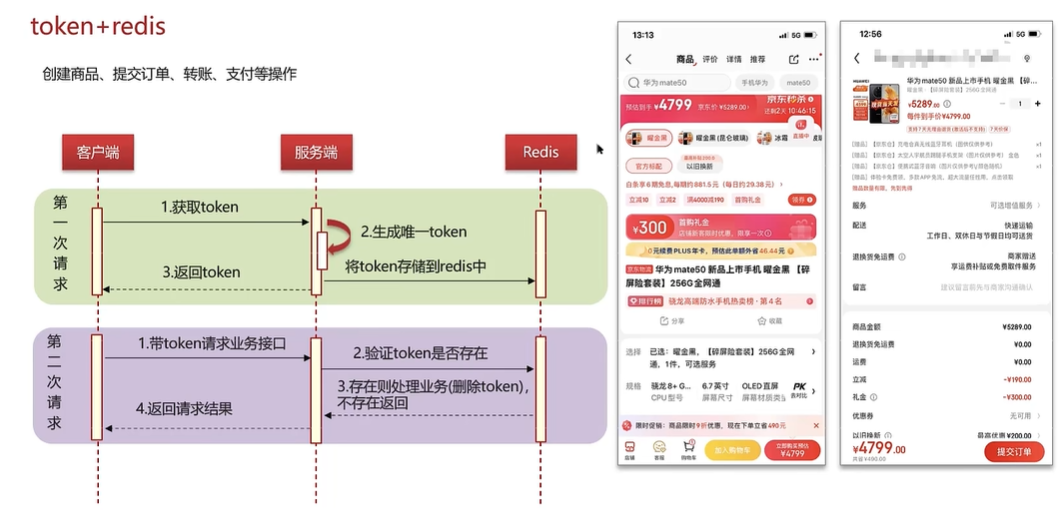
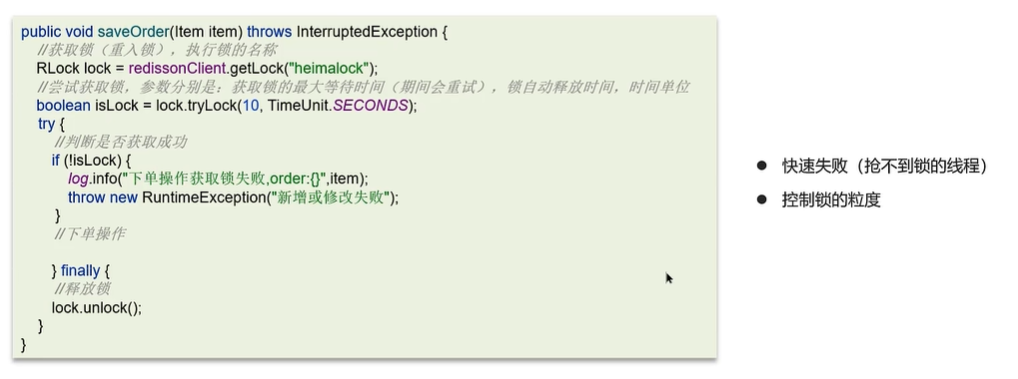
- token + redis :新增和修改
- 分布式锁 :新增和修改
token + redis
分布式锁

4.9分布式任务调度
xxl-job
xxl-job解决的问题:
- 解决集群任务的重复执行问题
- cron表达式定义灵活
- 定时任务失败了,重试和统计
- 任务量大,分片执行
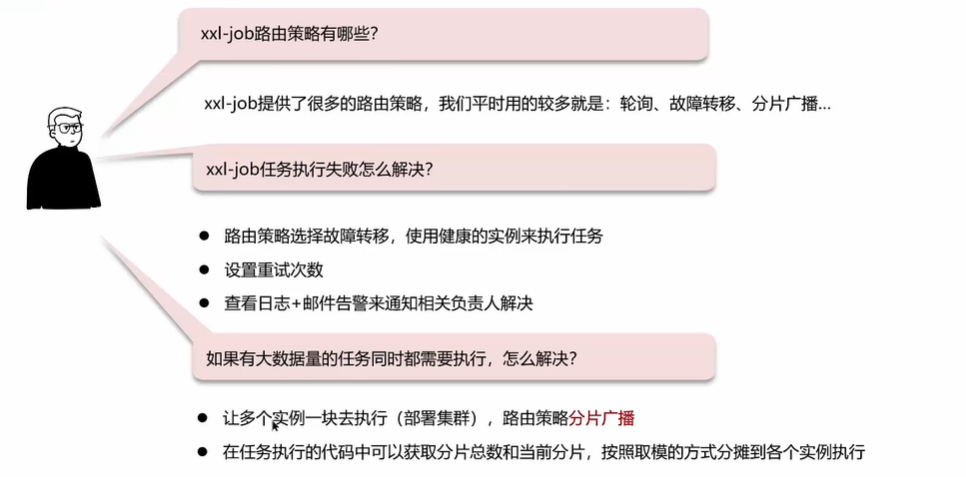
**一、xxl-job路由策略有哪些?**记住三个即可
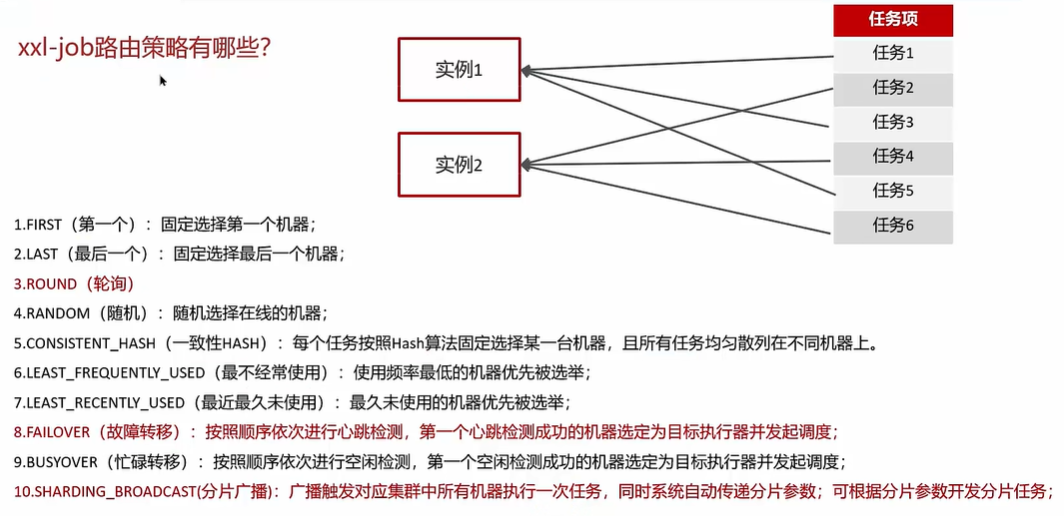
二、xxl-job任务执行失败怎么解决?
故障转移 + 失败重试,查看日志分析 -----> 邮件告警
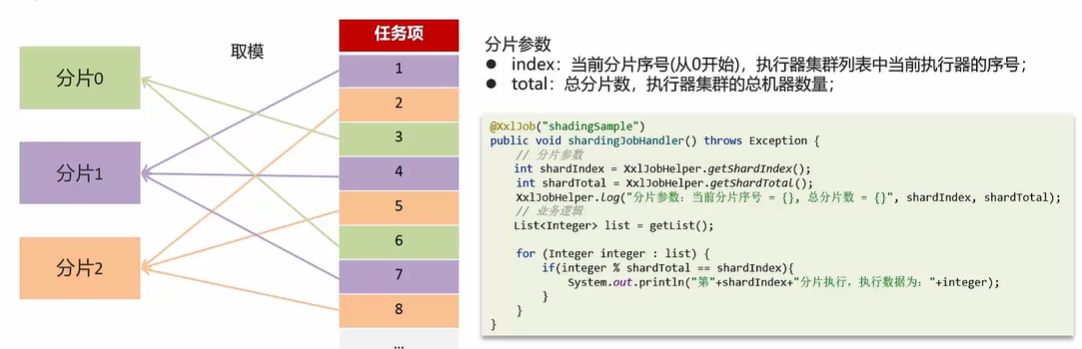
三、如果有大数据量的任务同时都需要执行,怎么解决?
执行器集群部署时,任务路由策略选择分片广播情况下,一次任务调度将会广播触发对应集群中所有执行器执行一次任务
4.10RabbitMQ
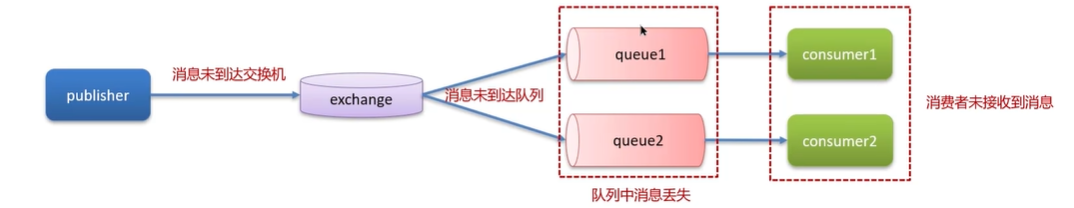
一、RabbitMQ如何保证消息不丢失
使用场景:
- 异步发送(验证码、短信、邮件…)
- MYSQL和Redis,Es之间的数据同步
- 分布式事务
- 削峰填谷
- …
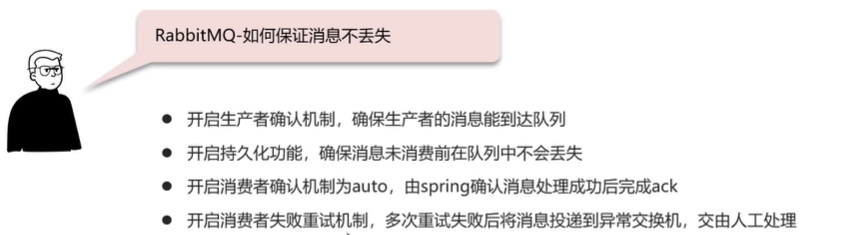
生产者确认机制
RabbitMQ提供了publisher confirm机制来避免消息发送到MQ过程中丢失,消息发送到MQ以后,会返回一个结果给发送者,表示消息是否处理成功。
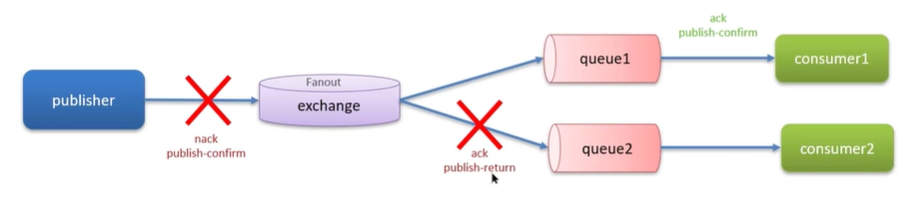
消息失败之后如何处理?
- 回调方法即时重发
- 记录日志
- 保存到数据库然后定时重发,成功发送后即刻删除表中的数据
消息持久化
MQ默认是内存存储消息,开启持久化功能可以确保缓存在MQ中的消息不丢失。
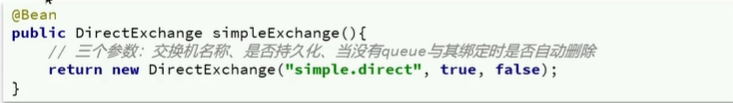
1、交换机持久化
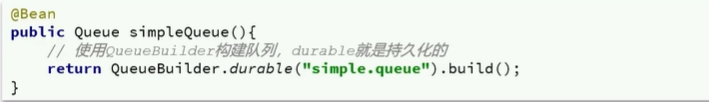
2、队列持久化
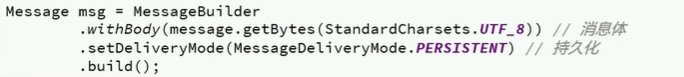
3、消息持久化,SpringAMQP中的消息默认是持久的,可以通过MessageProperties中的DeliveryMode来指定
消费者确认
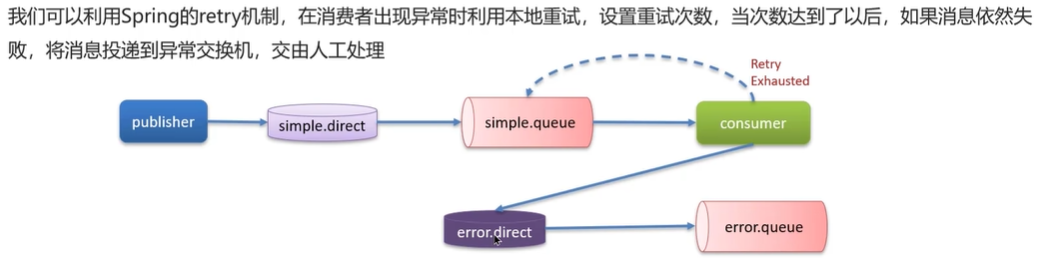
RabbitMQ支持消费者确认机制,即:消费者处理消息后可以向MQ发送ack回执,MQ收到ack回执后才会删除该消息。而SpringAMQP则允许配置三种确认模式:
- manual:手动ack,需要在业务代码结束后,调用api发送ack
- auto:自动ack,由spring检测listener代码是否出现异常,没有异常则返回ack;抛出异常则返回nack
- none:关闭ack,MQ假定消费者获取消息后会成功处理,因此消息投递后立即被删除
二、RabbitMQ消息的重复消费问题如何解决
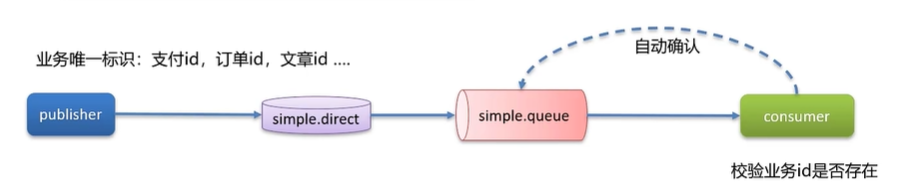
产生原因:
- 网络抖动
- 消费者挂了
解决方案:
- 每条消息设置一个唯一的标识id
- 幂等方案:【分布式锁、数据库锁(悲观锁、乐观锁)】
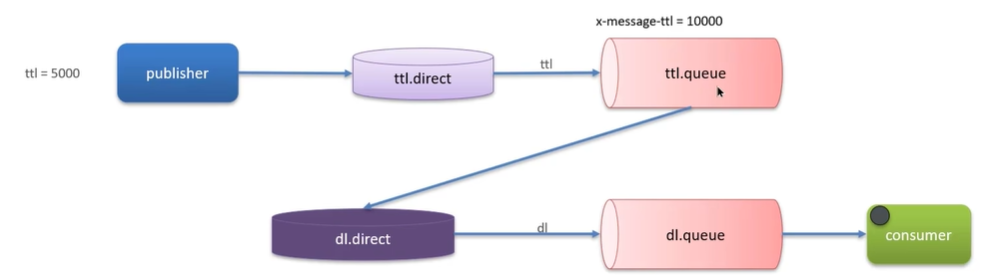
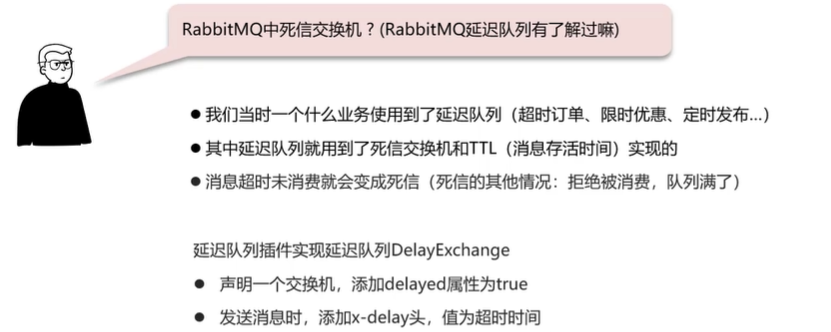
三、RabbitMQ中死信交换机(RabbitMQ延迟队列有了解过么)
- 延迟队列:进入队列的消息会被延迟消费的队列
- 场景:超时订单、限时优惠、定时发布
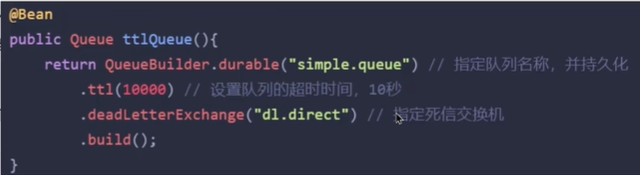
延迟队列 = 死信交换机 + TTL(生存时间)
①死信交换机
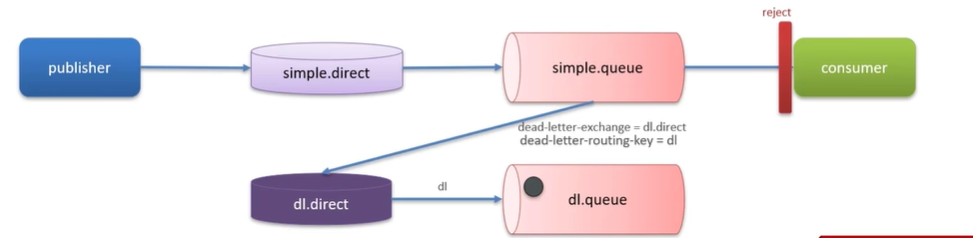
当一个队列中的消息满足下列情况之一时,可以成为死信(dead letter)
- 消费者使用basic.reject或basic.nack声明消费失败,并且消息的requeue参数设置为false
- 消息是一个过期消息,超时无人消费
- 要投递的队列消息堆积满了,最早的消息可能成为死信
如果该队列配置了dead-letter-exchange属性,指定了一个交换机,那么队列中的死信就会投递到这个交换机中,而这个交换机称为死信交换机(Dead Letter Exchange,简称DLX)
②TTL
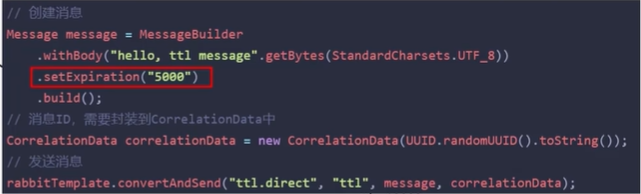
TTL,也就是Time-To-Live,如果一个队列中的消息TTL结束仍未消费,则会变为死信,ttl超时分为两种情况:
- 消息所在的队列设置了存活时间
- 消息本身设置了存活时间
延迟队列插件
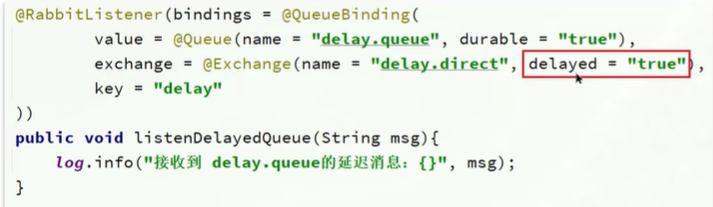
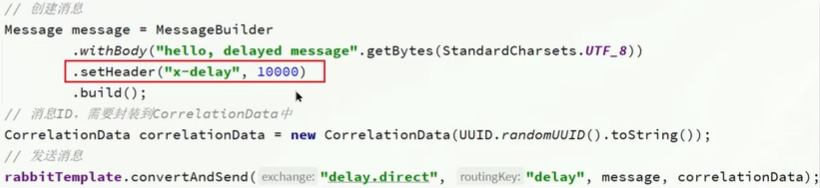
DelayExchange插件,需要安装在RabbitMQ中
DelayExchange的本质还是官方的三种交换机,只是添加了延迟功能,因此使用时只需要声明一个交换机,交换机的类型可以是任意类型,然后设定delayed属性为true即可
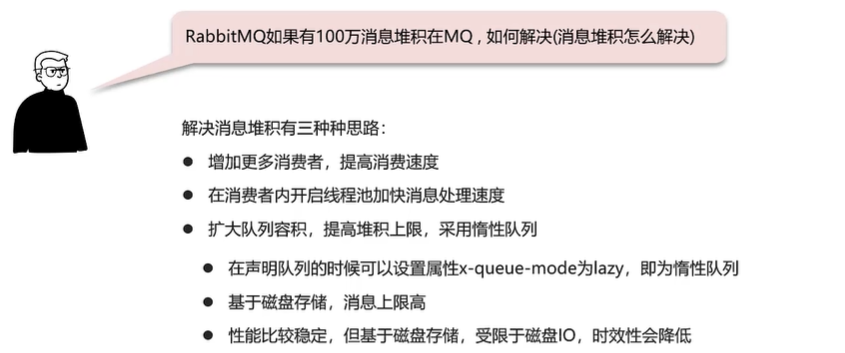
四、RabbitMQ如果有100万消息堆积在MQ,如何解决(消息堆积怎么解决)
当生产者发送消息的速度超过了消费者处理消息的速度,就会导致队列中的消息堆积,直到队列存储消息达到上限。之后发送的消息就会成为死信,可能会被丢弃,这就是消息堆积问题
解决思路:
- 增加更多消费者,提高消费速度
- 在消费者内开启线程池加快消息处理速度
- 扩大队列容积,提高堆积上限
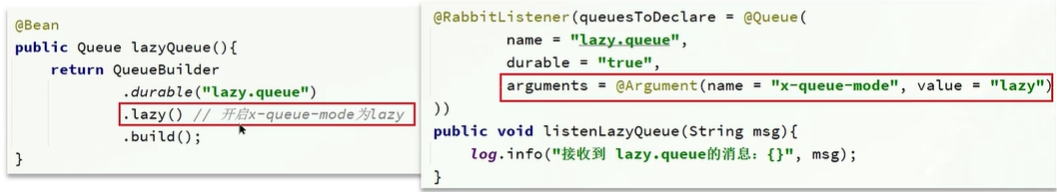
惰性队列
惰性队列的特征如下:
- 接受到消息后直接存入磁盘而非内存
- 消费者要消费消息时才会从磁盘中读取并加载到内存
- 支持数百万条消息的存储
五、RabbitMQ的高可用机制
- 在生产环境下,使用集群来保证高可用性
- 普通集群、镜像集群、仲裁队列
1、普通集群
普通集群,或者叫标准集群(class cluster),具备下列特征
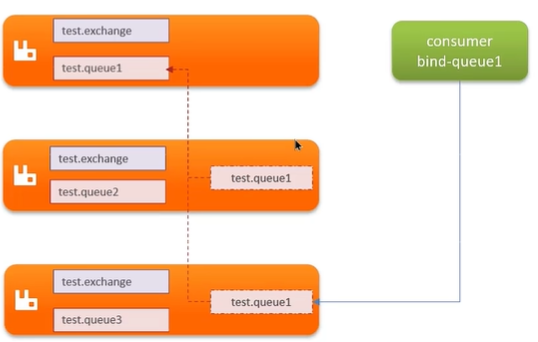
- 会在集群的各个节点间共享部分数据,包括:交换机,队列元信息。不包含队列中的消息
- 当访问集群某节点时,如果队列不在该节点,会从数据所在节点传递到当前节点并返回
- 队列所在节点宕机,队列中的消息就会丢失
2、镜像集群
镜像集群:本质是主从模式,具备下面的特征:
- 交换机、队列、队列中的消息会在各个mq的镜像节点之间同步备份
- 创建队列的节点被称为该队列的主节点,备份到的其它节点叫做该队列的镜像节点
- 一个队列的主节点可能是另一个队列的镜像节点
- 所有操作都是主节点完成,然后同步给镜像节点
- 主节点宕机后,镜像节点会代替成为新的主节点
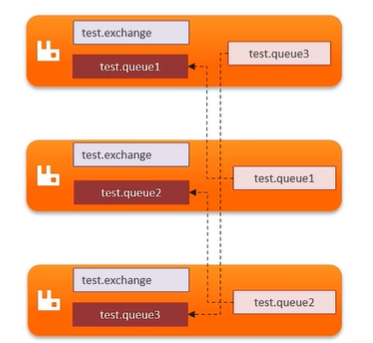
3、仲裁队列
仲裁队列:仲裁队列是3.8版本以后才有的新功能,用来替代镜像队列,具备下列特征:
- 与镜像队列一样,都是主从模式,支持主从数据同步
- 使用非常简单,没有复杂的配置
- 主从同步基于Raft协议,强一致
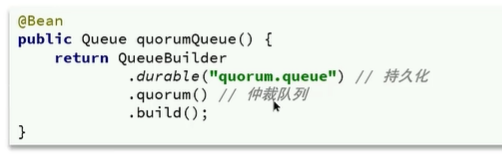
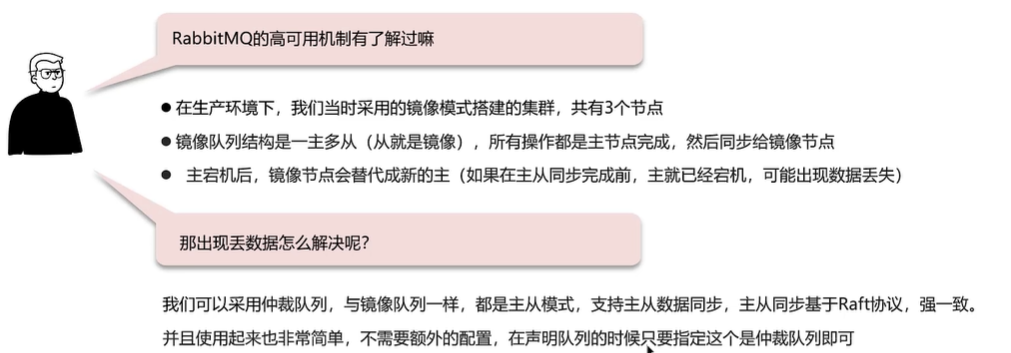
4.11Kafka
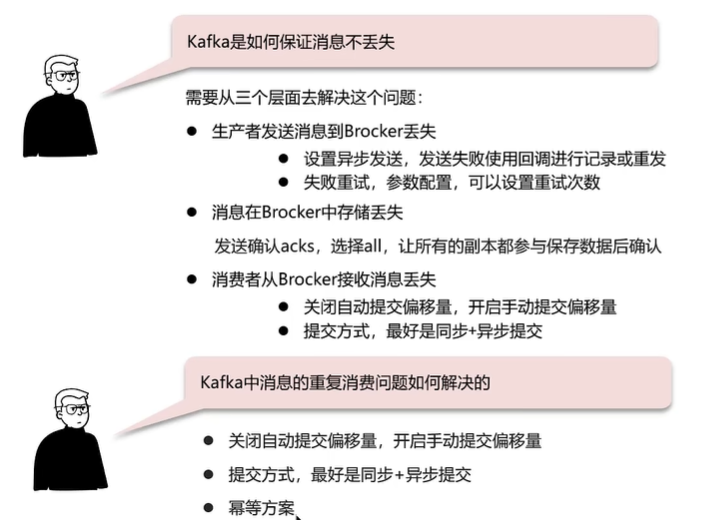
一、Kafka是如何保证消息不丢失
使用Kafka在消息的收发过程都会出现消息丢失,Kafka分别给出了解决方案
- 生产者发送消息到Brocker丢失
- 消息在Brocker中存储丢失
- 消费者从Brocker接收消息丢失
1、生产者发送消息到Brocker丢失
- 设置异步发送
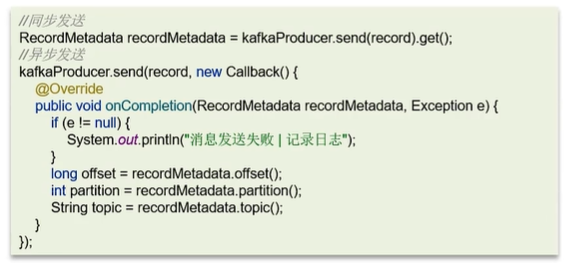
- 消息重试
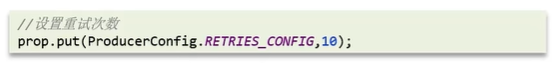
2、消息在Brocker中存储丢失
- 发送确认机制acks
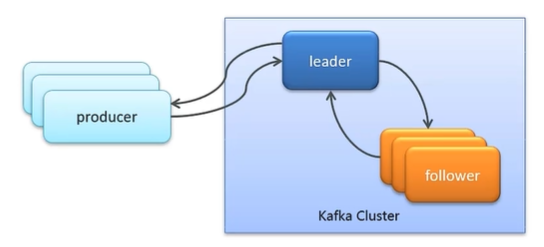
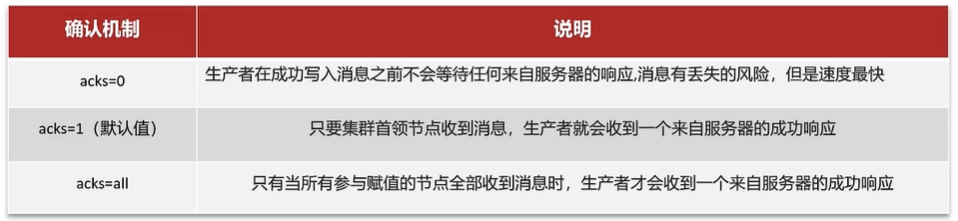
3、消费者从Brocker接收消息丢失
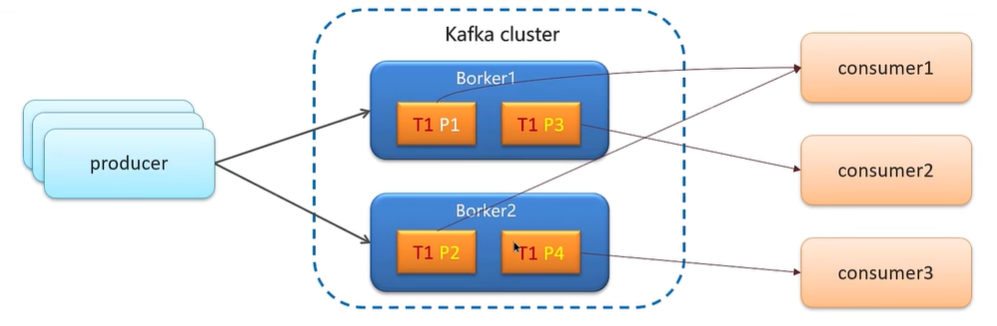
- Kafka中的分区机制指的是将每个主题划分成多个分区(Partition)
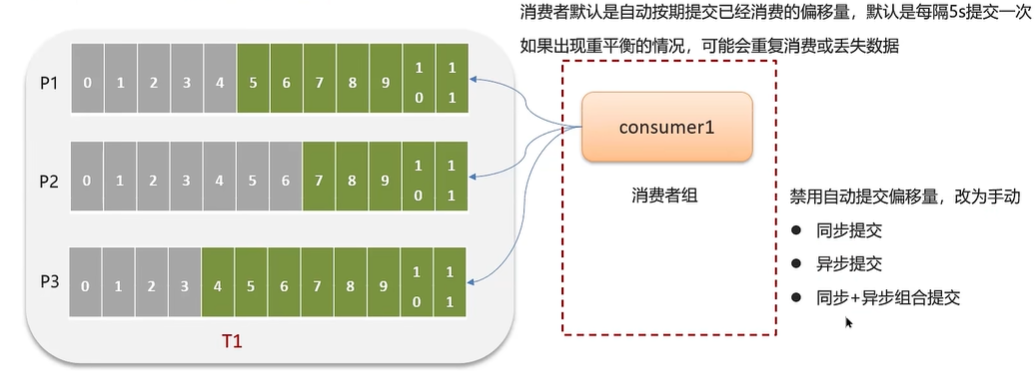
- topic分区中消息只能由消费者组中的唯一一个消费者处理,不同的分区分配给不同的消费者(同一个消费者组)

重平衡:当消费者组内某一个消费者宕机了,就会把实例分配给组内其它消费者,这个重新分配的过程就是重平衡
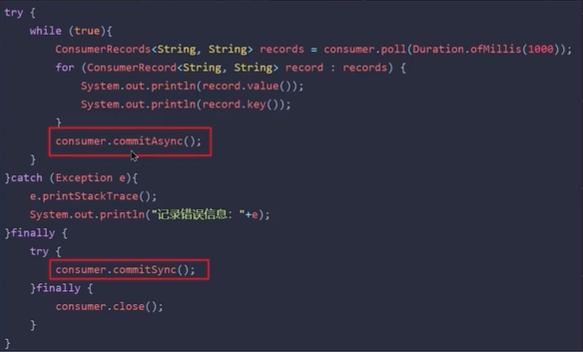
try代码块里设置异步提交,在finally里设置同步提交
二、Kafka是如何保证消费的顺序性
应用场景:
- 即时消息中的单对单聊天和群聊,保证发送方消息发送顺序与接收方的顺序一致
- 充值转账两个渠道在同一个时间进行余额变更,短信通知必须要有顺序
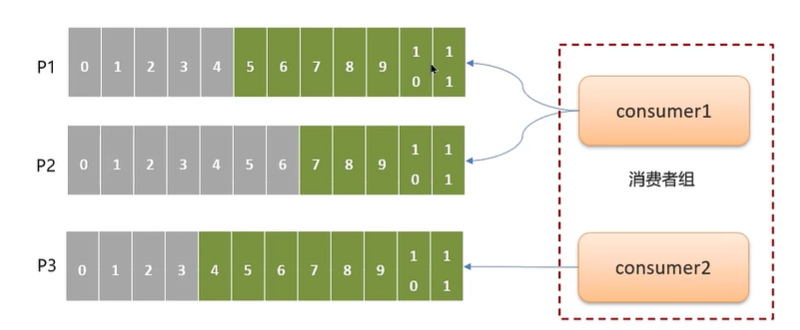
topic分区中消息只能由消费者组中的唯一一个消费者处理,所以消息肯定是按照先后顺序进行处理的、但是它也仅仅是保证Topic的一个分区顺序处理,不能保证跨分区的消息先后处理顺序。所以,如果想要顺序的处理Topic的所有消息,难就只提供一个分区。
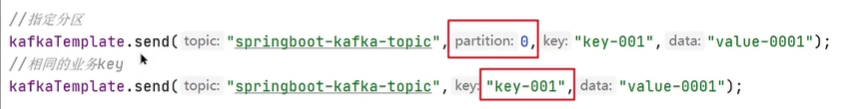
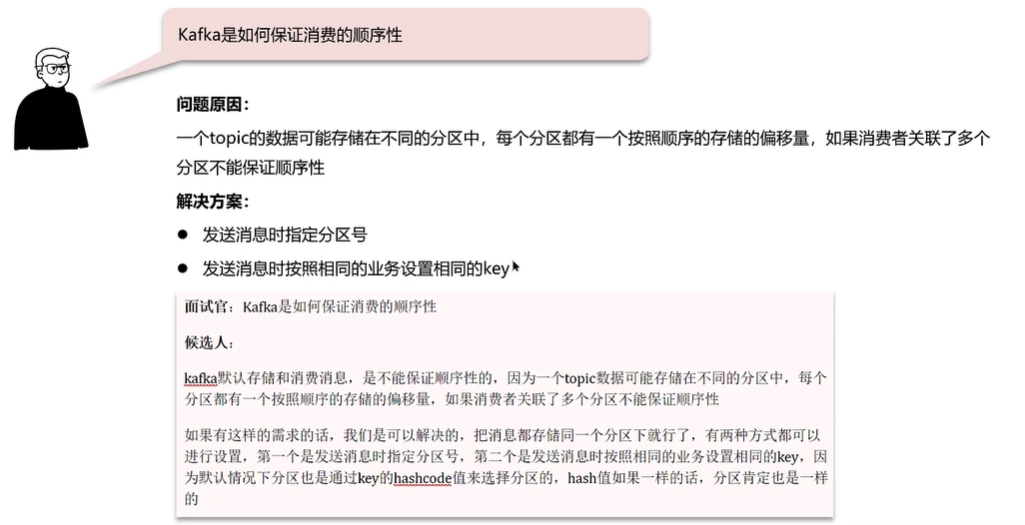
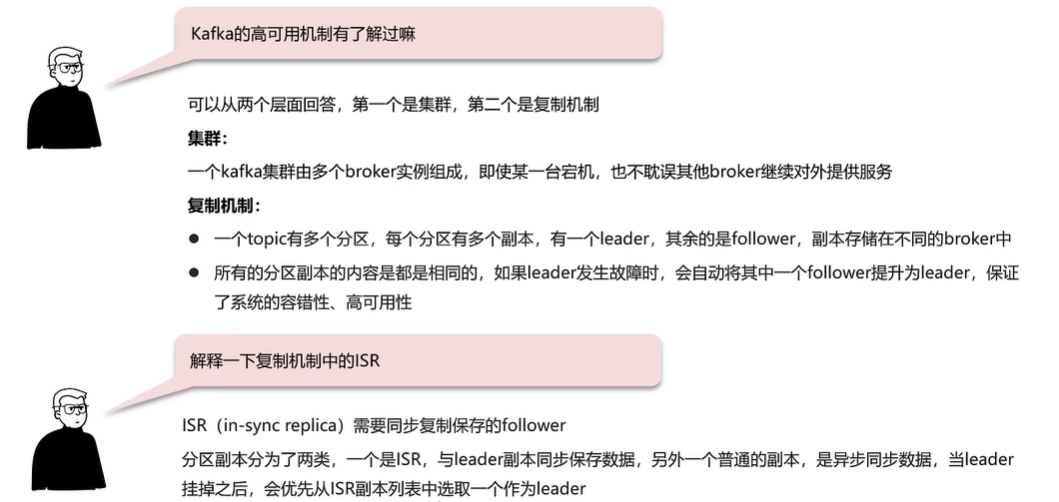
三、Kafka的高可用机制
1、集群模式
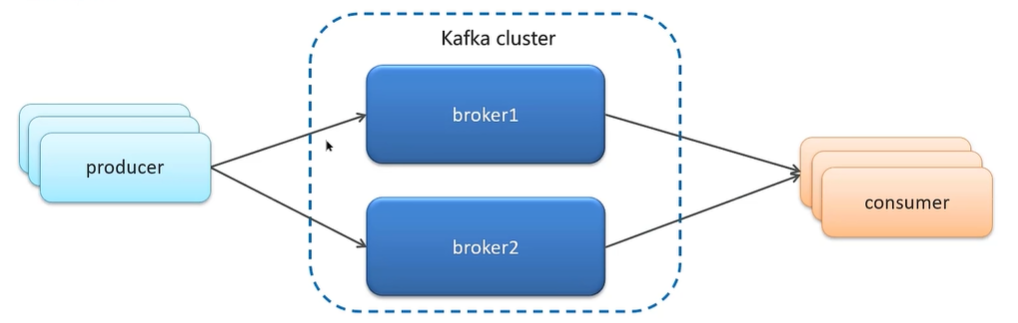
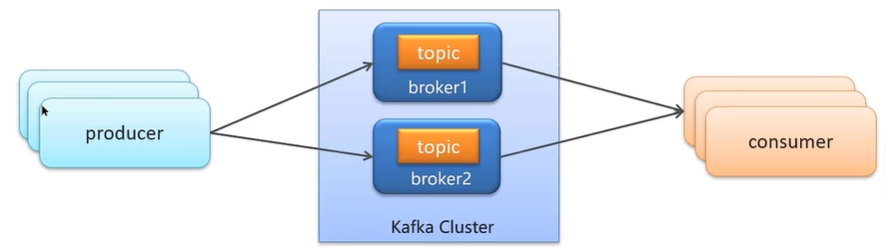
- Kafka的服务器端由被称为Broker的服务进程构成,即一个Kafka集群由多个Broker组成
- 这样如果集群中某一台机器宕机,其它机器上的Broker也依然能够对外提供服务,这其实就是Kafka提供高可用的手段之一
2、分区备份机制
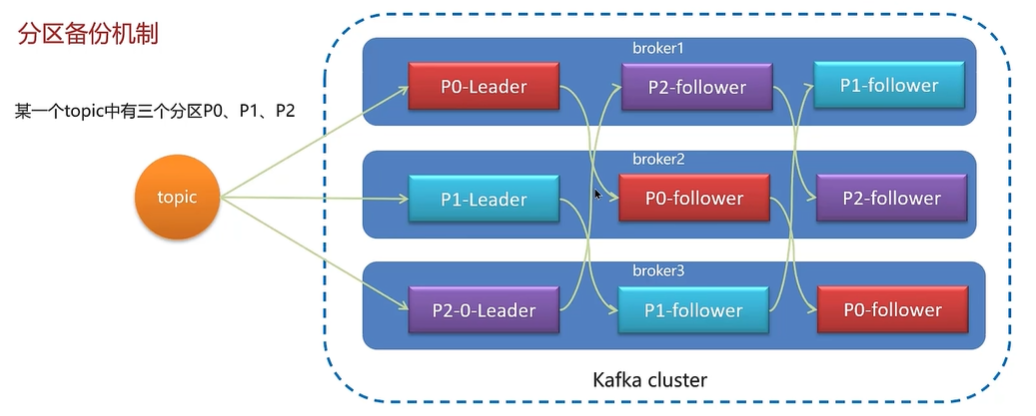
- 一个topic有多个分区,每个分区有多个副本,其中有一个leader,其余的是follower,副本存储在不同的broker中
- 所有的分区副本的内容都是相同的,如果leader发生故障时,会自动将其中一个follower提升为leader
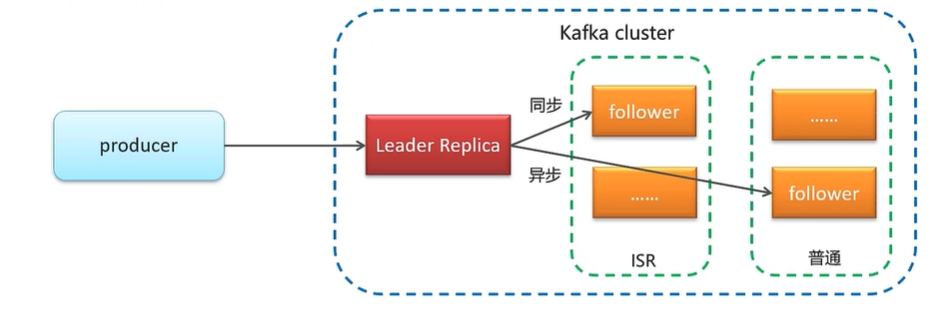
ISR(in-sync replica)需要同步复制保存的follower
如果leader失效后,需要选出新的leader,选举的原则如下:
第一:选举时优先从ISR中选定,因为这个列表中的follower的数据是与leader同步的
第二:如果ISR列表中的follower都不行了,就只能从其他follower中选取
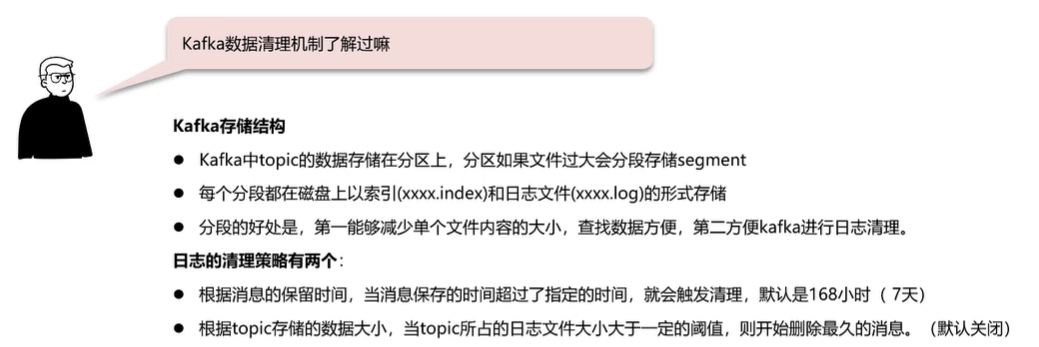
四、Kafka数据清理机制
1、Kafka文件存储机制
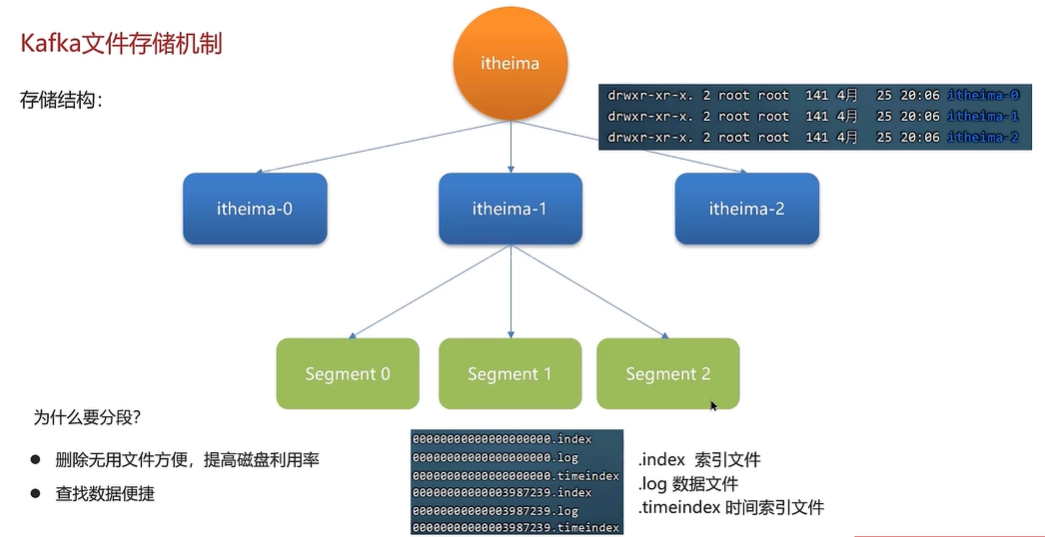
2、数据清理机制
日志的清理策略有两个
1、根据消息的保留时间,当消息在Kafka中保存的时间超过了指定的时间,就会触发清理过程
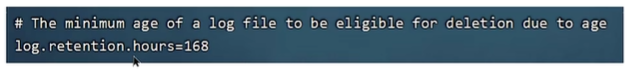
默认168个小时,七天
2、根据topic存储的数据大小,当topic所占的日志文件大小大于一定的阈值,则开始删除最久的消息。需手动开启
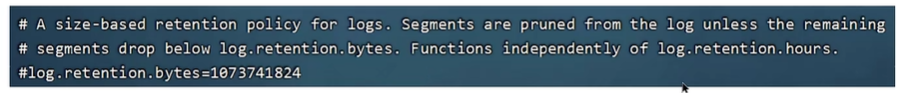
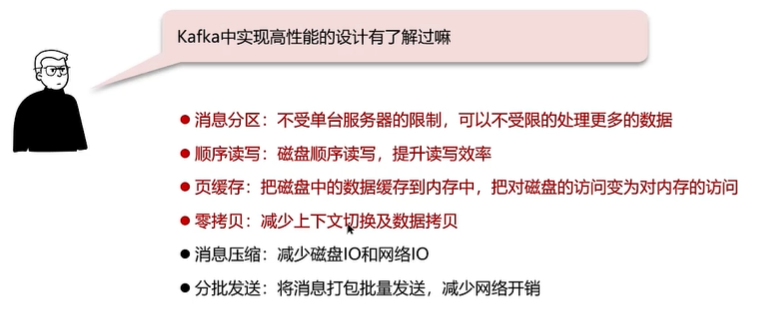
五、Kafka中实现高性能的设计
- 消息分区:不受单台服务器的限制,可以不受限的处理更多的数据
- 顺序读写:磁盘顺序读写,提升读写效率
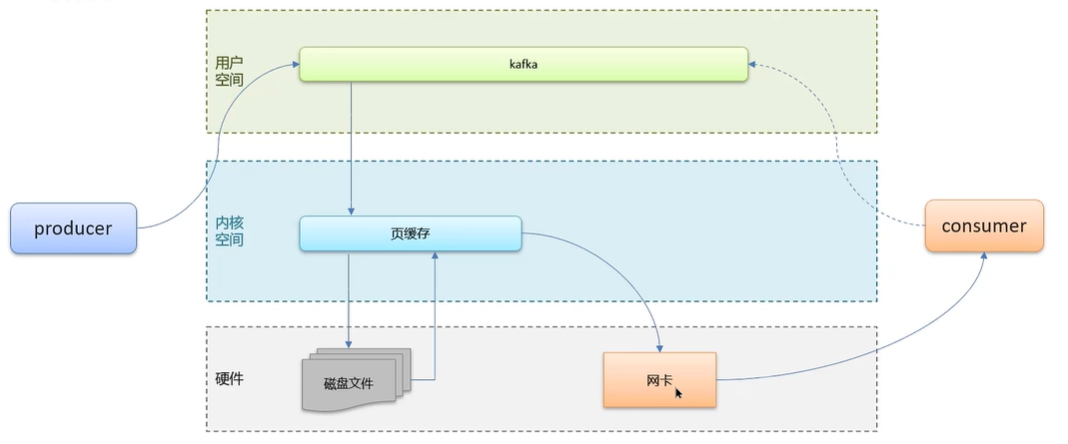
- 页缓存:把磁盘中的数据缓存到内存中,把对磁盘的访问变成对内存的访问
- 零拷贝:减少上下文切换及数据拷贝
- 消息压缩:减少磁盘IO和网络IO
- 分批发送:将消息打包批量发送,减少网络开销
零拷贝
以前:需要拷贝四次
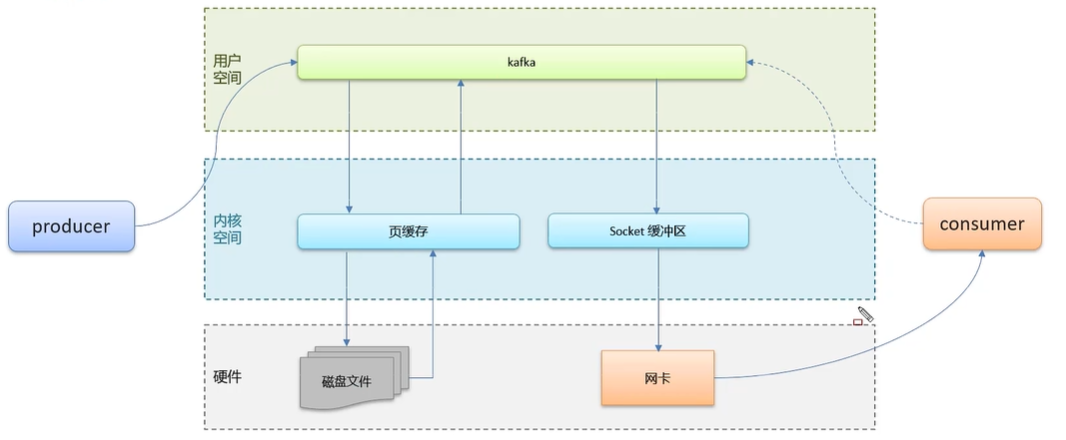
零拷贝:需要拷贝两次
第五章 集合
5.1数据结构
算法复杂度分析
时间复杂度:来评估代码的执行耗时
- 大O表示法:不具体表示代码真正的执行时间,而是表示代码执行时间随数据规模增长的变化趋势
- T(n)与代码的执行次数成正比(代码行数越多,执行时间越长)
- 当n很大时,公式中的低阶、常量、系数三部分并不左右其增长趋势,因此可以忽略。我们只需要记录一个最大的量级就可以了
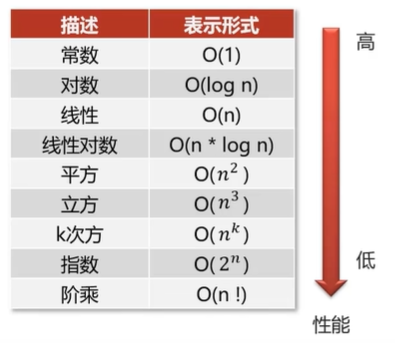
常对幂指阶
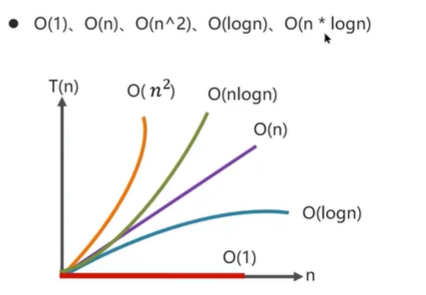
空间复杂度
空间复杂度全称是渐进空间复杂度,表示算法占用的额外存储空间与数据规模之间的增长关系
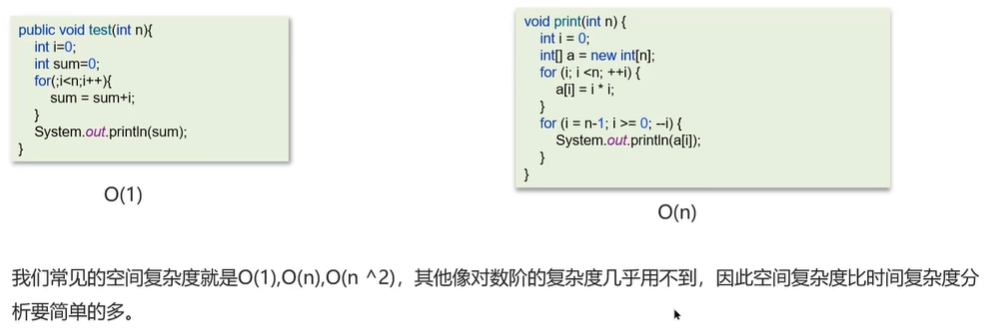
5.2List
一、数组
数组(Array)是一种用连续的内存空间存储相同数据类型数据的线性数据结构
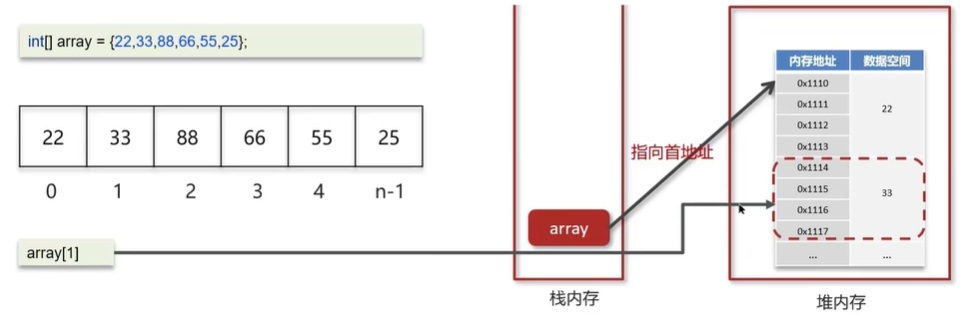
寻址公式:a[i] = baseAddress + i * dataTypeSize
- baseAddress:数组的首地址
- dataTypeSize:代表数组中元素类型的大小,int型的数据,dataTypeSize=4个字节
索引为什么从0开始,1开始不行吗?
在根据数组索引获取元素的时候,会用索引和寻址公式来计算内存所对应的元素数据,寻址公式是:数组的首地址+索引乘以存储数据的类型大小
如果数组的索引从1开始,寻址公式中,就需要增加一次减法操作,对于CPU来说就多了一次指令,性能不高
操作数组的时间复杂度(查找)
1、随机查询(根据索引查询)
数组元素的访问是通过下标来访问的,计算机通过数组的首地址和寻址公式能够很快速的找到想要访问的元素
O(1)
2、未知索引查询
排序前:遍历,平均时间复杂度O(n)
排序后:二分,O(log n)
操作数组的时间复杂度(插入,删除)
数组是一段连续的内存空间,因此为了保证数组的连续性会使数组的插入和删除的效率变的很低
需要挪动数组元素,最好情况下是O(1)的,最坏情况下是O(n)的,平均情况下的时间复杂度是O(n)
二、ArrayList
1、源码分析
成员变量
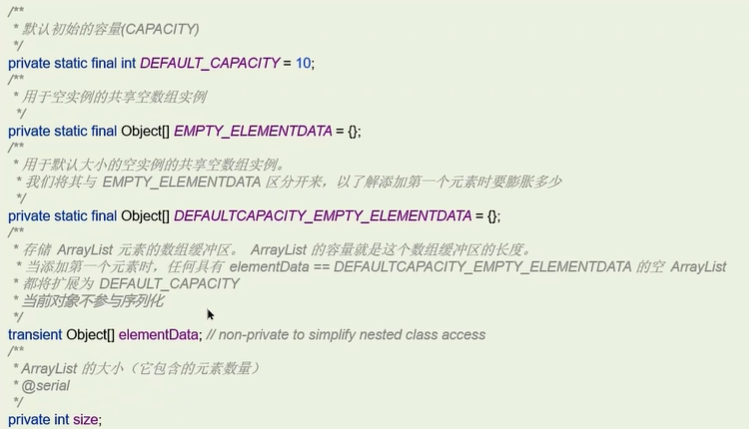
构造方法
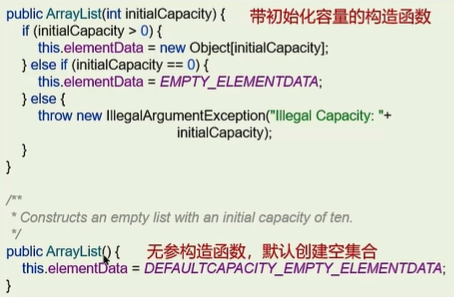
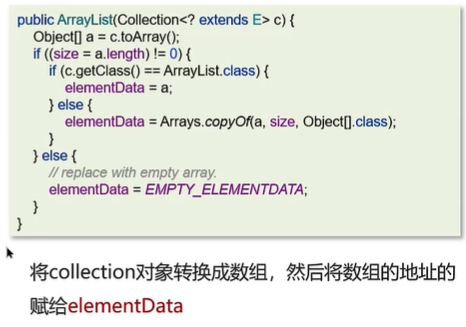
添加和扩容操作(第1次添加数据)
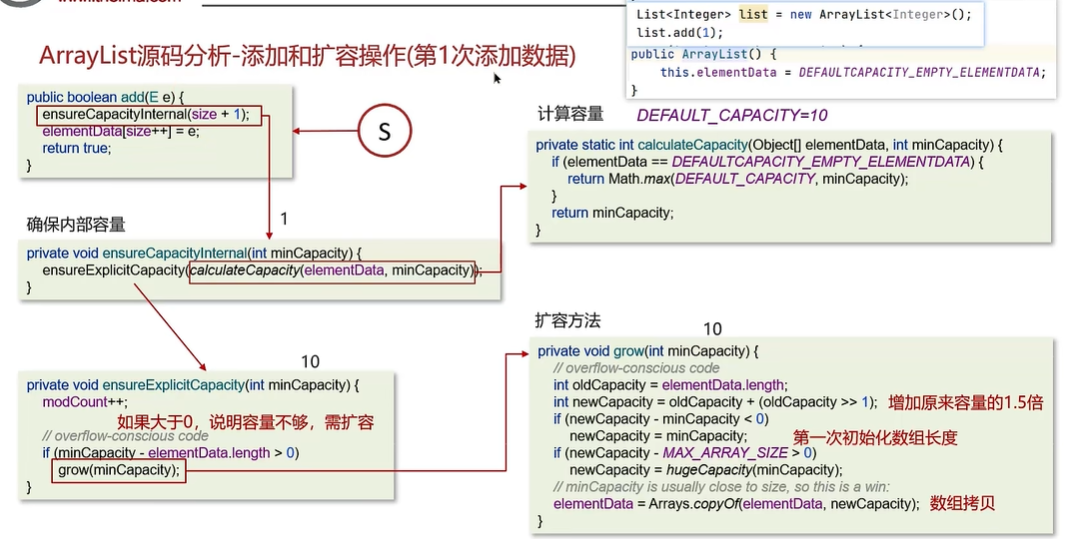
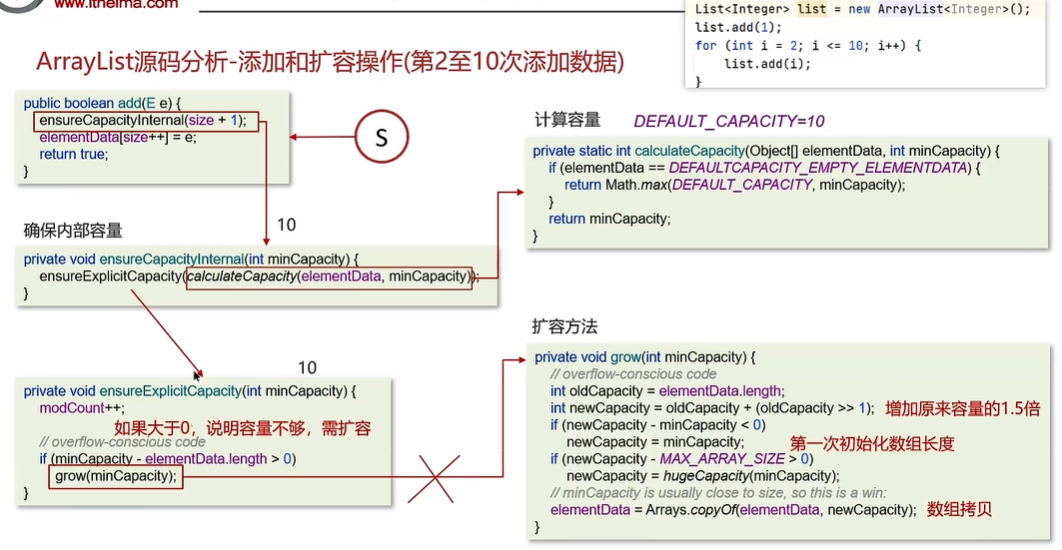
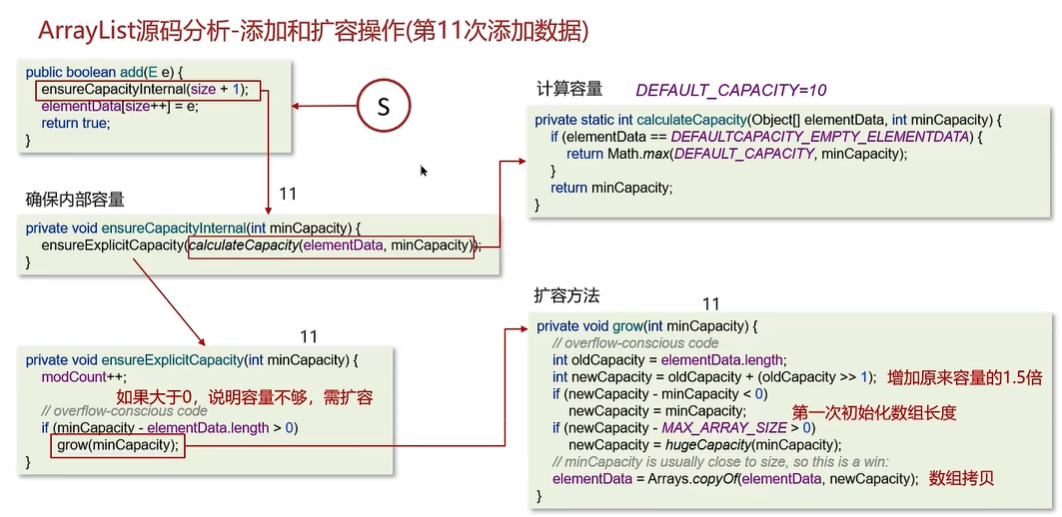
第一次添加数据时初始化默认长度是10,当位置不够时,增加1.5倍(右移1位,除2,再加上原来的长度)
2、底层原理
- ArrayList底层是用动态数组实现的
- ArrayList初始容量为0,当第一次添加数据的时候才会初始化容量为10
- ArrayList在进行扩容的时候是原来的1.5倍,每次扩容都需要拷贝数组
- ArrayList在添加数据的时候
- 确保数组已使用长度(size)加1之后足够存下下一个数据
- 计算数组容量,如果当前数组已使用长度+1后的长度大于当前数组长度,则调用grow方法扩容(原来的1.5倍)
- 确保新增的数据有地方存储之后,则将新元素添加到位于size的位置上
- 返回添加成功的布尔值
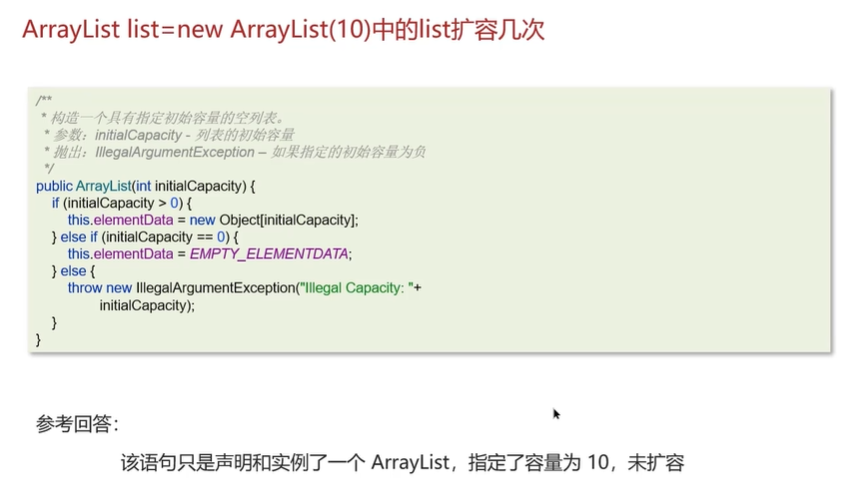
3、实现数组和List之间的转换
数组转List:使用JDK中java.util.Arrays工具类的asList方法
List转数组:使用List的toArray方法。无参toArray方法返回Object数组,传入初始化长度的数组对象,返回该对象数组
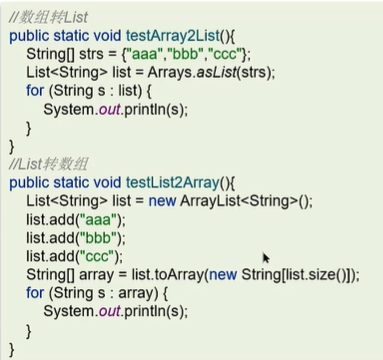
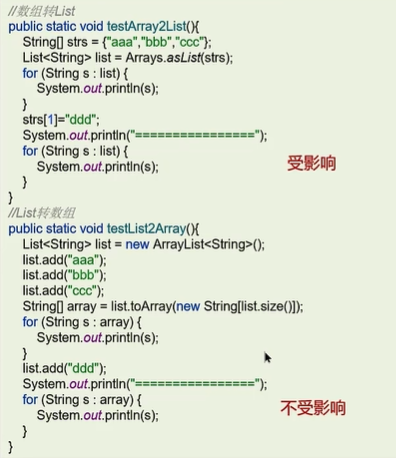
用Arrays.asList转List后,如果修改数组内容,list会受影响,因为它的底层使用的Arrays类中的一个内部类ArrayList来构造的集合,在这个集合的构造器中,把我们传入的这个集合进行了包装而已,最终指向的是同一个地址
List用toArray转数组后,如果修改List内容,数组不受影响,当调用了toArray以后,在底层是它是进行了数组的拷贝,跟原来的元素就没有关系了,所以即使list修改了以后,数组也不会受到影响
三、LinkedList
单向链表
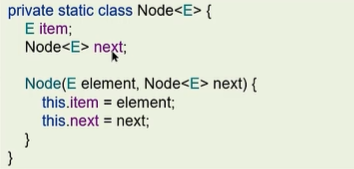
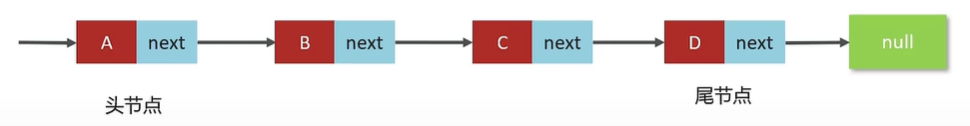
链表中的每一个元素称之为结点(Node),物理存储单元上,非连续、非顺序的存储结构
单向链表:每个结点包括两部分:一个是存储数据元素的数据域,另一个是存储下一个结点地址的指针域。记录下一个结点地址的指针叫作后继指针next
查询操作
- 只有在查询头结点的时候不需要遍历链表,时间复杂度是O(1)
- 查询其他结点需要遍历链表,时间复杂度是O(n)
插入/删除操作
- 只有在添加和删除头结点的时候不需要遍历链表,时间复杂度是O(1)
- 添加或删除其他结点需要遍历链表找到对应结点后,才能完成新增或删除结点,时间复杂度是O(n)
双向链表
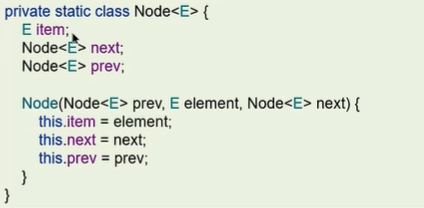
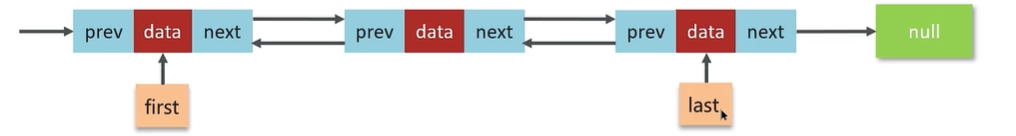
每个结点不止有一个后继指针next指向后面的结点,有一个前驱指针prev指向前面的结点
查询操作
查询头尾结点的时间复杂度是O(1),平均的查找时间复杂度是O(n),给定结点找前驱节点的时间复杂度是O(1)
增删操作
头尾节点增删的时间复杂度为O(1),其他部分节点增删的时间复杂度是O(n),给定节点进行前后增删时间复杂度是O(1)
对比:
- 双向链表需要额外的两个空间来存储后继结点和前驱结点的地址
- 支持双向遍历,这样也带来了双向链表操作的灵活性
ArrayList和LinkedList的区别
1、底层数据结构
- ArrayList是动态数组的数据结构实现
- LinkedList是双向链表的数据结构实现
2、操作数据效率
- ArrayList按照下标查询的时间复杂度为O(1)【内存是连续的,根据寻址公式】,LinkedList不支持下标查询
- 查找(未知索引):ArrayList需要遍历,LinkedList也需要遍历,时间复杂度都是O(n)
- 新增和删除
- ArrayList尾部插入和删除,时间复杂度是O(1),其他部分增删需要挪动数组,时间复杂度是O(n)
- LinkedList头尾节点增删,时间复杂度是O(1),其他都需要遍历链表,时间复杂度是O(n)
3、空间占用
- ArrayList底层是数组,内存连续,节省空间
- LinkedList是双向链表需要存储数据,和两个指针,更占用内存
4、线程安全
-
ArrayList和LinkedList都不是线程安全的
-
如果需要保证线程安全,有两种方案
-
在方法内使用,局部变量则是线程安全的
-
使用线程安全的ArrayList和LinkedList
List<Object> syncArrayList = Collections.synchronizedList(new ArrayList<>());
List<Object> syncLinkedList = Collections.synchronizedList(new LinkedList<>());
-
5.3Map
一、二叉树
二叉树,顾名思义,每个节点最多有两个“叉”,也就是两个子节点,分别是左子节点和右子节点。不过,二叉树并不要求每个节点都有两个子节点,有的节点只有左子节点,有的节点只有右子节点。
二叉树每个节点的左子树和右子树也分别满足二叉树的定义
用链式存储的树的节点可定义如下:
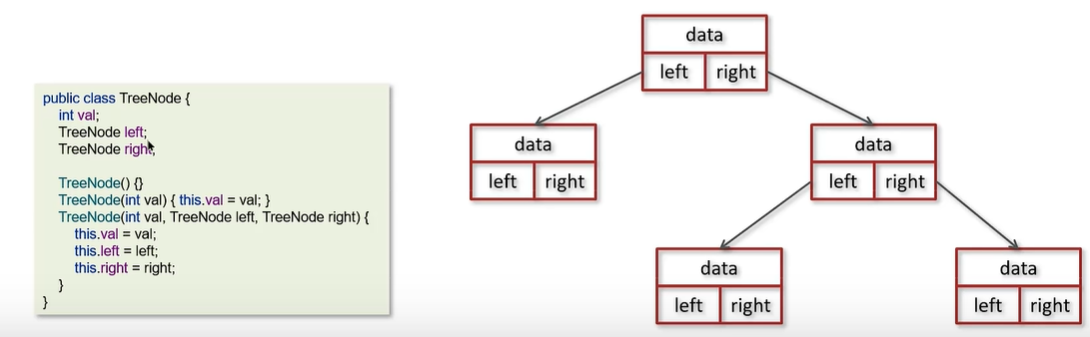
二叉树分类
- 满二叉树
- 完全二叉树
- 二叉搜索树
- 红黑树
二叉搜索树
(Binary Search Tree, BST)又名二叉查找树,有序二叉树或者排序二叉树,是二叉树中比较常用的一种类型,二叉查找树要求,在树中的任意一个节点,其左子树中的每个节点的值,都要小于这个节点的值,而右子树节点的值都大于这个节点的值。(没有键值相等的节点)
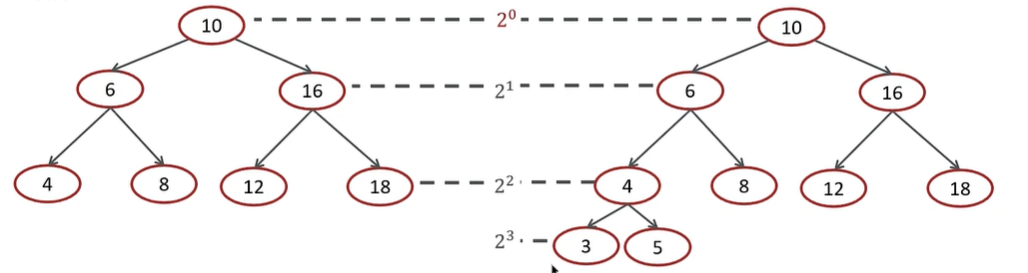
时间复杂度
插入、查找、删除的时间复杂度O(logn)
特殊情况下:当二叉树的节点只有左或右子节点时,二叉查找树退化成链表,左右子树极度不平衡,插入、查找、删除的时间复杂度O(n)
二、红黑树
(Red Black Tree):也是一种自平衡的二叉搜索树(BST),之前叫做平衡二叉B树(Symmetric Binary B-Tree)
性质:
- 节点要么是红色,要么是黑色
- 根节点是黑色
- 叶子节点都是黑色的空节点
- 红黑树中红色节点的子节点都是黑色
- 从任一节点到叶子节点的所有路径都包含相同数目的黑色节点
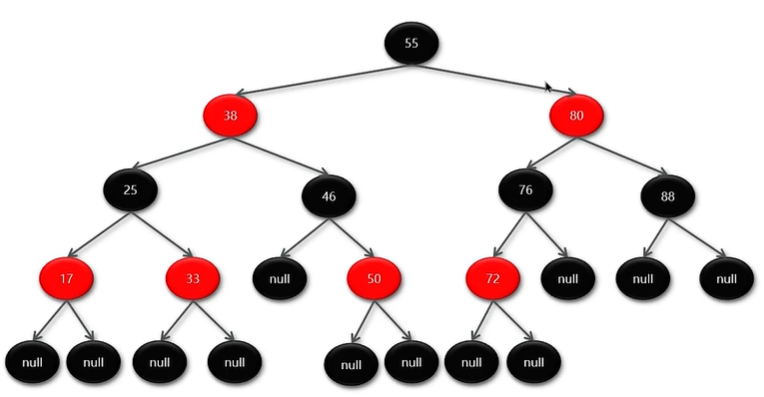
在添加或删除节点的时候,如果不符合这些性质会发生旋转,以达到所有的性质(保证平衡)
时间复杂度
查找:红黑树也是一棵BST,查找操作的时间复杂度为:O(log n)
添加:添加要先从根节点开始查找到元素添加的位置,时间复杂度为O(log n),添加完成后涉及到复杂度为O(1)的旋转调整操作,所以整体的时间复杂度是O(log n)
删除:删除要先从根节点开始查找到元素删除的位置,时间复杂度为O(log n),添加完成后涉及到复杂度为O(1)的旋转调整操作,所以整体的时间复杂度是O(log n)
三、散列表
在HashMap中的最重要的一个数据结构就是散列表,在散列表中又使用到了红黑树和链表
概念
散列表(Hash Table)又名哈希表/Hash表,是根据键(Key)直接访问在内存存储位置值(Value)的数据结构,它是由数组演化而来的,利用了数组支持按照下标进行随机访问数据的特性
散列函数
将键(Key)映射为数组下标的函数叫做散列函数。可以表示为:hashValue = hash(Key)
基本要求:
- 散列函数计算得到的散列值必须是大于等于0的正整数,因为hashValue需要作为数组的下标
- 如果key1 == key2,那么经过hash后得到的哈希值也必相同即:hash(key1) == hash(key2)
- 如果key1 != key2,那么经过hash后得到的哈希值也必不相同即:hash(key1) != hash(key2)
散列冲突
实际情况下想找一个散列函数能够做到对于不同的key计算得到的散列值都不同几乎是不可能的,即便像著名的MD5,SHA等哈希算法也无法避免这一情况,这就是散列冲突(或者哈希冲突,哈希碰撞,就是指多个Key映射到同一个数组下标位置)
拉链法
在散列表中,数组的每个下标位置我们可以称之为桶(bucket)或者槽(slot),每个桶(槽)会对应一条链表,所有散列值相同的元素我们都放到相同槽位对应的链表中。
插入操作,通过散列函数计算出对应的散列槽位,将其插入到对应链表中即可,插入的时间复杂度是O(1)
查找和删除,我们同样通过散列函数计算出对应的槽,然后遍历链表查找或删除
- 平均情况下基于链表法解决冲突时查询的时间复杂度是O(1)
- 散列表可能会退化为链表,查询的时间复杂度就从O(1)退化为O(n)
- 将链表法中的链表改造为其他高效的动态数据结构,比如红黑树,查询的时间复杂度是O(log n),可以防止DDos攻击
DDos攻击
分布式拒绝服务攻击(Distributed Denial of Service)
指处于不同位置的多个攻击者同时向一个或数个目标发动攻击,或者一个攻击者控制了位于不同位置的多台机器并利用这些机器对受害者同时实施攻击,由于攻击的发出点是分布在不同地方的,这类攻击称为分布式拒绝服务攻击,其中的攻击者可以有多个
三、HashMap实现原理
HashMap的数据结构:底层使用hash表数据结构,即数组和链表或红黑树
1、当我们往HashMap中put元素时,利用key的hashCode重新hash计算出当前对象的元素在数组中的下标
2、存储时,如果出现hash值相同的key,此时有两种情况
- 如果key相同,则覆盖原始值
- 如果key不同(出现冲突),则将当前的key-value放入链表或红黑树中
tips:链表长度大于8且数组长度大于64转换为红黑树
3、获取时,直接找到hash值对应的下标,再进一步判断key是否相同,从而找到对应值
jdk1.7和jdk1.8的hashMap有什么区别?
- jdk1.8之前采用的是拉链法,将链表和数组相结合,也就是说创建一个链表数组,数组中每一格就是一个链表,若遇到哈希冲突,则将冲突的值加到链表中即可
- jdk1.8在解决哈希冲突时有了较大的变化,当链表长度大于阈值(默认为8)时,并且数组长度达到64时,将链表转化为红黑树,以减少搜索时间,扩容resize()时,红黑树拆分成的树的结点数小于等于临界值6个,则退化成链表
HashMap的put方法的具体流程
常见属性
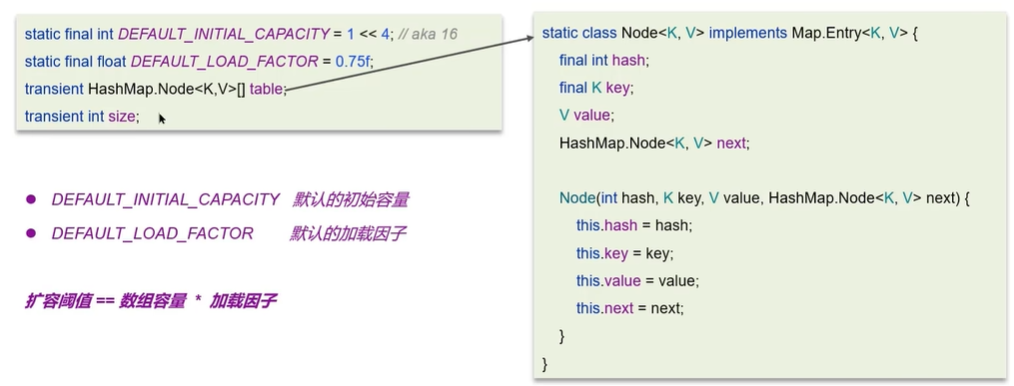
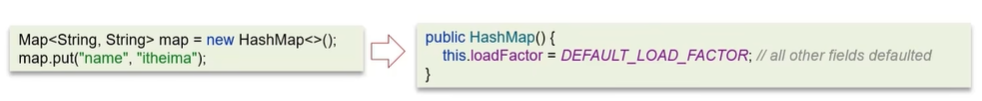
- HashMap是懒惰加载,在创建对象时并没有初始化数组
- 在无参的构造方法中,设置了默认的加载因子是0.75
添加数据流程图
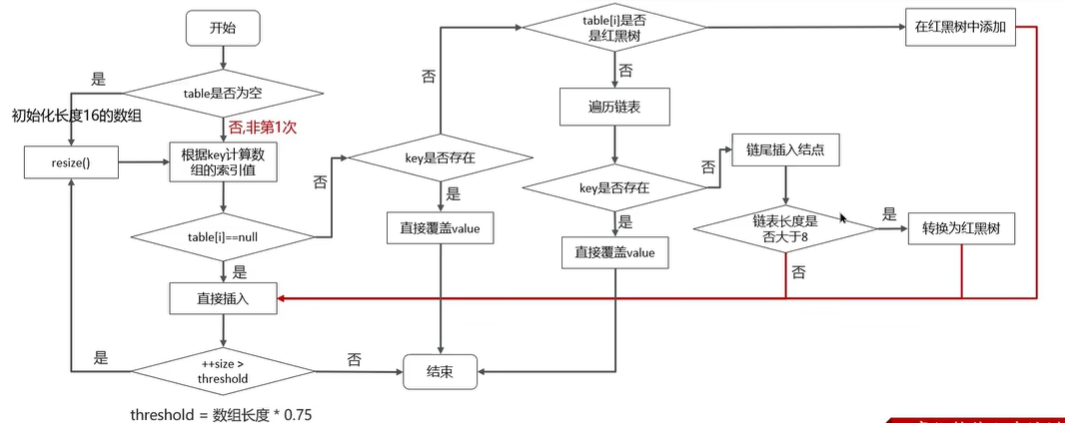
1、判断键值对数组table是否为空或为null,否则执行resize()进行扩容(初始化)
2、根据键值对key计算hash值得到数组索引
3、判断table[i] == null,条件成立,直接新建节点添加
4、如果table[i] == null,不成立
- 判断table[i]的首个元素是否和key一样,如果相同直接覆盖value
- 判断table[i]是否为treeNode,即table[i]是否是红黑树,如果是红黑树,则直接在树中插入键值对
- 遍历table[i],链表的尾部插入数据,然后判断链表长度是否大于8,大于8的话把链表转换为红黑树,在红黑树中执行插入操作,遍历过程中若发现key已经存在直接覆盖value
5、插入成功后,判断实际存在的键值对数量size是否超过了最大容量threshold(数组长度*0.75),如果超过,进行扩容
HashMap的扩容机制
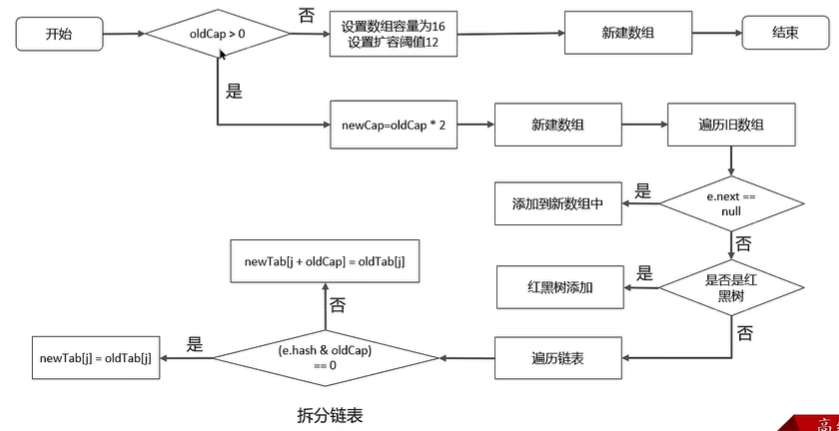
- 在添加元素或初始化的时候需要调用resize方法进行扩容,第一次添加数据初始化长度为16,以后每次扩容都是达到了扩容阈值(数组长度*0.75)
- 每次扩容,都是扩容之前容量的2倍
- 扩容之后,会新创建一个数组,需要把老数组中的数据挪动到新的数组中
- 没有hash冲突的节点,则直接使用**e.hash & (newCap - 1)**计算新数组的索引位置 当newCap的长度是2的n次幂时等价于 e.hash % newCap
- 如果是红黑树,走红黑树的添加
- 如果是链表,则需要遍历链表,可能需要拆分链表,判断e.hash & oldCap是否为0,该元素的位置要么停留在原始位置,要么移动到原始位置 + 增加的数组大小这个位置上
hashMap的寻址算法
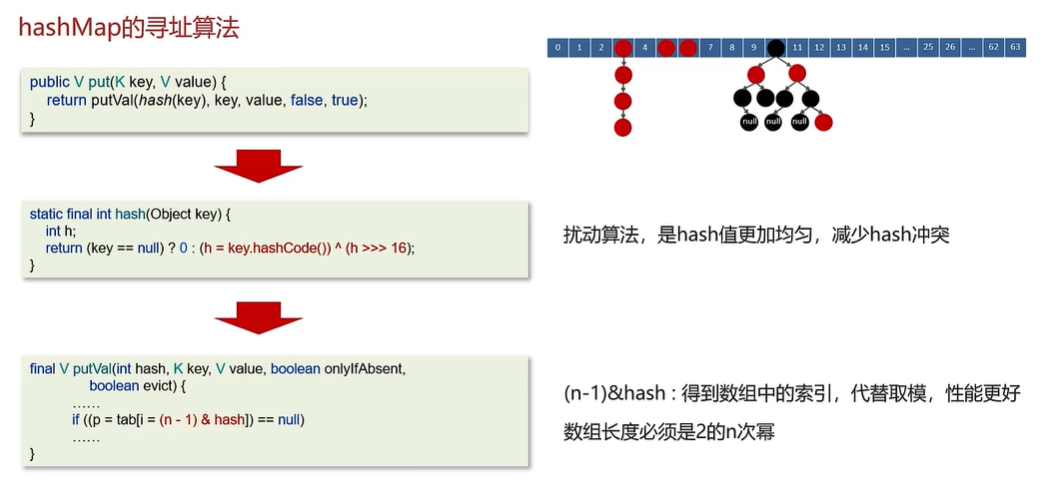
数组长度为什么必须是2的n次幂?
1、计算索引时效率更高,如果是2的n次幂可以使用位与运算代替取模
2、扩容时重新计算索引效率更高,hash & oldCap == 0的元素留在原来的位置,否则新位置 = 旧位置 + oldCap
hashMap在1.7情况下的多线程死循环问题
底层数据结构:数据 + 链表
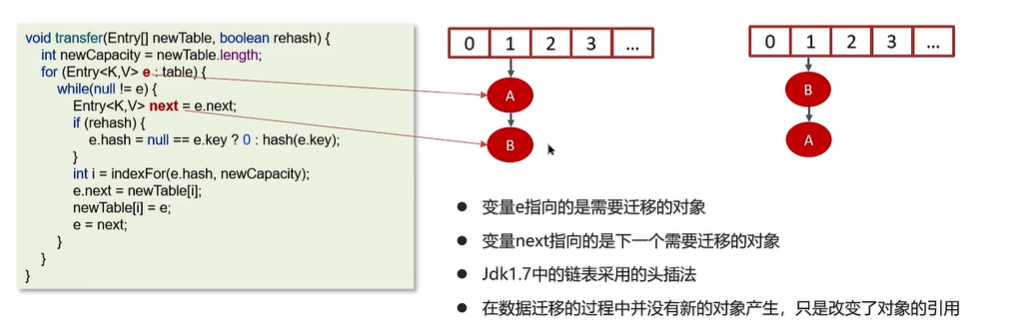
在数组进行扩容的时候,因为链表是头插法,在进行数据迁移的过程中,有可能导致死循环
比如说,现在有两个线程
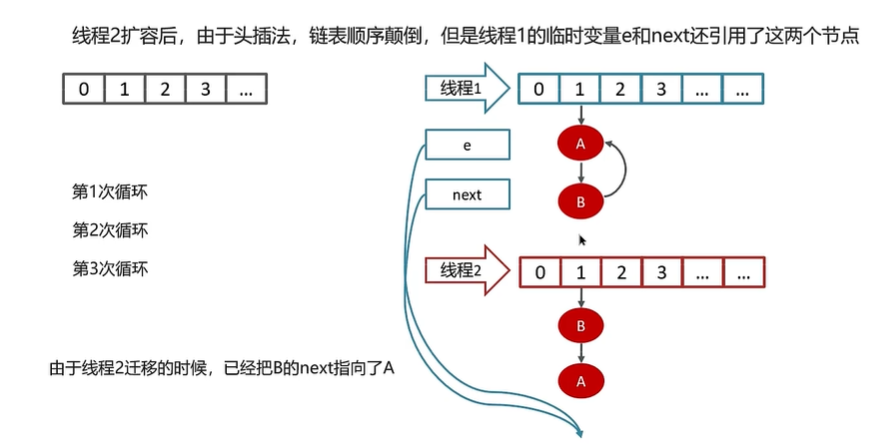
线程一:读取到当前的hashmap数据,数据中一个链表,在准备扩容时,线程二介入
线程二:也读取hashmap,直接进行扩容。因为是头插法,链表的顺序会进行颠倒过来,比如原来的顺序是AB,扩容后的顺序是BA,线程二执行结束。
线程一:继续执行的时候就会出现死循环的问题。
线程一先将A移入新的链表,再将B插入到链头,由于另一个线程的原因,B的next指向了A,所以B -> A -> B,形成循环
当然,JDK8将扩容算法做了调整,不再将元素加入链表头(而是保持与扩容前一样的顺序),尾插法,就避免了jdk7中死循环的问题。
第六章 并发编程
6.1线程基础
一、线程和进程的区别
进程
程序由指令和数据组成,但这些指令要运行,数据要读写,就必须将指令加载至CPU,数据加载至内存,在指令运行过程中还需要用到磁盘、网络等设备,进程就是用来加载指令、管理内存、管理IO的。
当一个程序被运行,从磁盘加载这个程序的代码至内存,这时就开启了一个进程
线程
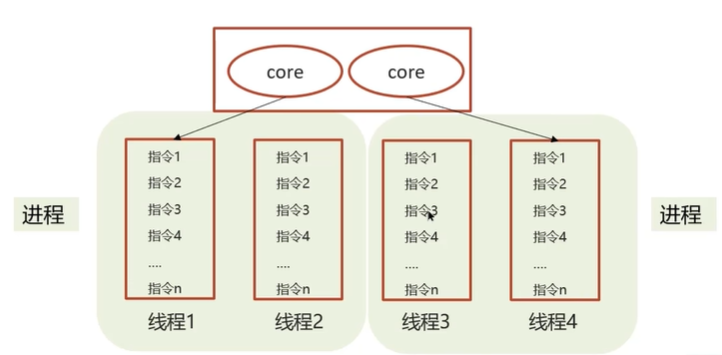
一个线程就是一个指令流,将指令流中的一条条指令以一定的顺序交给CPU执行,一个进程之内可以分为一到多个线程
对比
- 进程是正在运行程序的实例,进程中包含了线程,每个线程执行不同的任务
- 不同的进程使用不同的内存空间,在当前进程下的所有线程可以共享内存空间
- 线程更轻量,线程上下文切换成本一般上要比进程上下文切换低(上下文切换指的是从一个线程切换到另一个线程)
二、并行和并发的区别
单核CPU
- 单核CPU下线程实际还是串行执行的
- 操作系统中有一个组件叫做任务调度器,将cpu的时间片(windows下时间片最小约为15毫秒)分给不同的程序使用,只是由于cpu在线程间(时间片很短)的切换非常快,人类感觉是同时运行的,
- 微观串行,宏观并行
- 一般会将这种线程轮流使用CPU的做法称为并发(concurrent)
多核CPU
每个核(core)都可以调度运行线程,这时候线程是可以并行的
并发是同一时间应对多件事情的能力,并行是同一时间动手做多件事情的能力
三、创建线程的方式有哪些
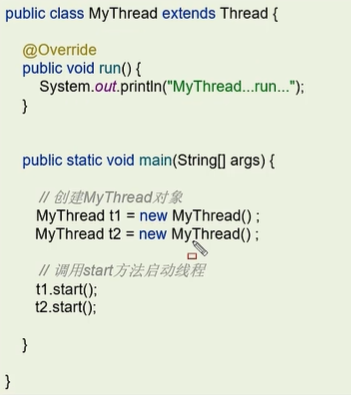
1、继承Thread类
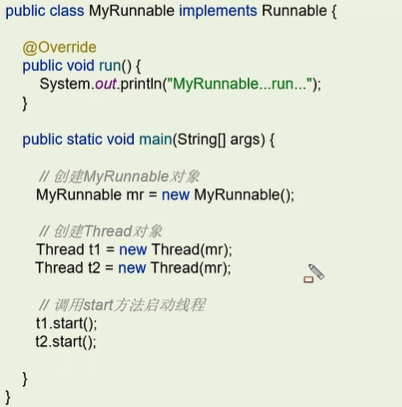
2、实现runnable接口
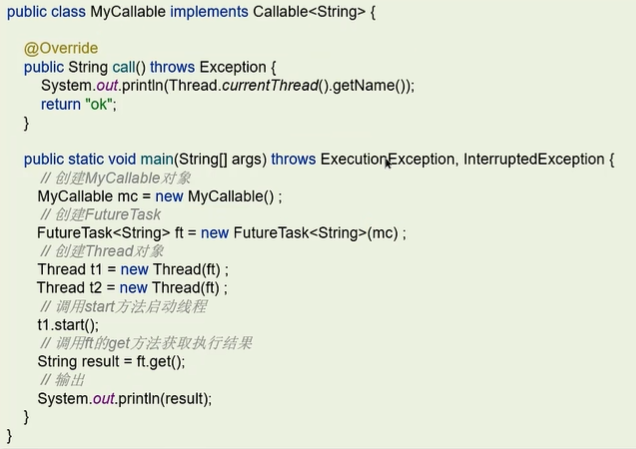
3、实现Callable接口
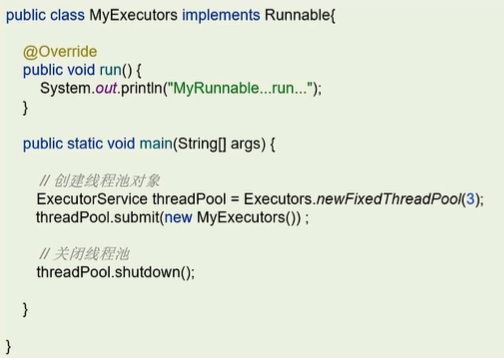
4、线程池创建线程
runnable和callable的区别?
- runnable接口run方法没有返回值
- callable接口call方法有返回值,是个泛型,和Future、FutureTask配合可以用来获取异步执行的结果
- callable接口的call方法允许抛出异常,而runnable接口的run方法的异常只能在内部消化,不能继续上抛
run方法和start方法的区别?
start():用来启动线程,通过该线程调用run方法执行run方法中所定义的逻辑代码,start方法只能被调用一次
run():封装了要被线程执行的代码,可以被调用多次
四、线程包括哪些状态,状态之间是如何变化的
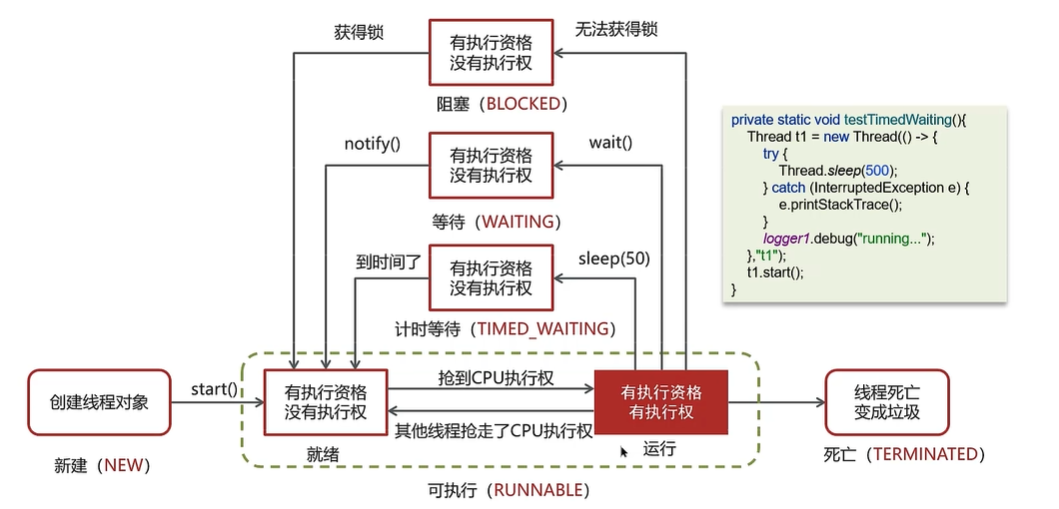
线程的状态可以参考JDK中的Thread类中的枚举State
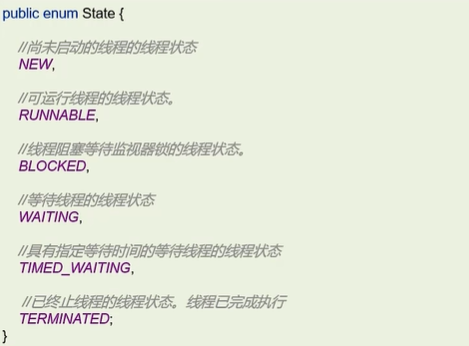
1、线程包括哪些状态
新建(NEW)、可运行(RUNNABLE)、阻塞(BLOCKED)、等待(WAITING)、时间等待(TIMED_WALTING)、终止(TERMINATED)
2、线程状态之间是如何变化的
- 创建线程对象是新建状态
- 调用了start()方法转变为可执行态
- 线程获取到了CPU的执行权,执行结束是终止状态
- 在可执行状态的过程中,如果没有获取CPU的执行权,可能会切换其他状态
- 如果没有获取锁(synchronized或lock)进入阻塞状态,获取锁再切换为可执行状态
- 如果线程调用了wait()方法进入等待状态,其他线程调用notify()唤醒后可切换为可执行状态
- 如果线程调用了sleep(50)方法,进入计时等待状态,到时间后可切换为可执行状态
sleep(0):调用sleep(0)可以释放cpu时间,让线程马上重新回到就绪队列而非等待队列,sleep(0)释放当前线程所剩余的时间片(如果有剩余的话),这样可以让操作系统切换其他线程来执行,提升效率。
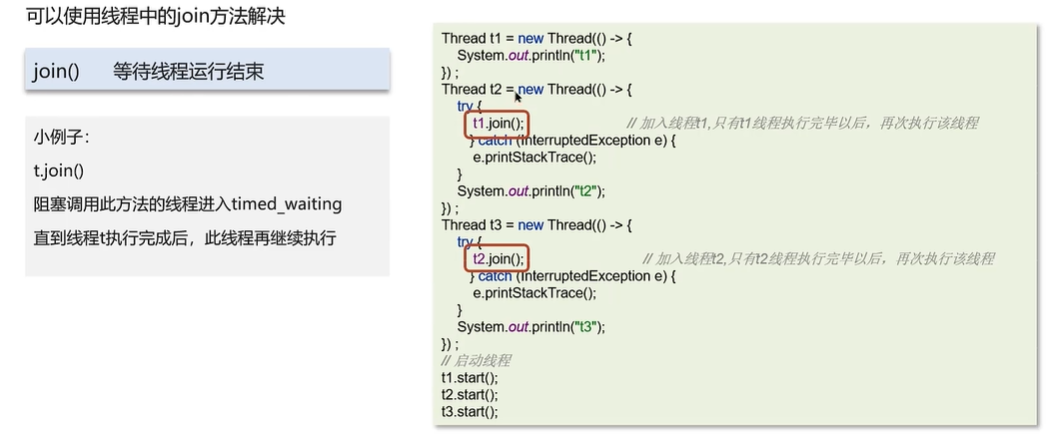
五、新建T1、T2、T3三个线程,如何保证它们按顺序执行
可以使用线程中的join方法解决
六、notify()和notifyAll()有什么区别
- notifyAll:唤醒所有wait的线程
- notify:只随机唤醒一个wait线程
七、java中wait和sleep方法的不同
共同点:效果都是让当前线程暂时放弃CPU的使用权,进入阻塞状态
不同点:
1、方法归属不同
- sleep(long)是Thread的静态方法
- 而wait(),wait(long)都是Object的成员方法,每个对象都有
2、醒来时机不同
- 执行sleep(long)和wait(long)的线程都会在等待相应毫秒后醒来
- wait(long)和wait()还可以被notify唤醒,wait()如果不唤醒就一直等下去
- 它们都可以被打断唤醒
3、锁特性不同
- wait方法的调用必须先获取wait对象的锁,而sleep则无此限制
- wait方法执行后会释放对象锁,允许其它线程获取该对象锁
- 而sleep如果在synchronized代码块中执行,并不会释放对象锁
八、如果停止一个正在运行的线程
1、使用退出标志,使线程正常退出,也就是当run方法完成后线程终止 布尔值flag while循环
2、使用stop方法强行终止(不推荐,方法已作废)
3、使用interrupt方法中断线程
- 打断阻塞的线程(sleep,wait,join)的线程,线程会抛出InterrupedException异常
- 打断正常的线程,可以根据打断状态来标记是否退出线程,跟第一种差不多
6.2线程安全
一、synchronized关键字的底层原理
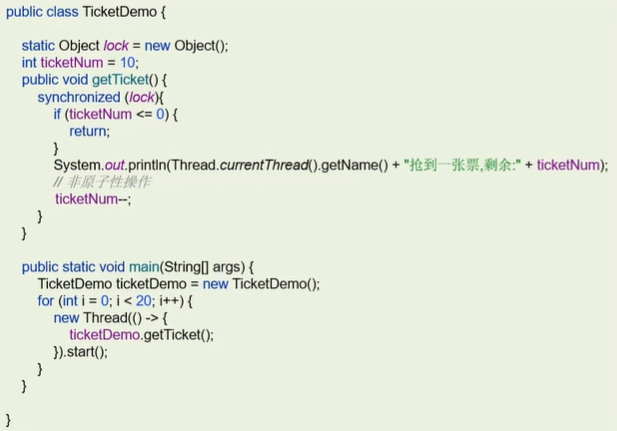
Synchronized【对象锁】采用互斥的方式让同一时刻至多只有一个线程能持有【对象锁】,其它线程再想获取这个【对象锁】时就会阻塞住。
Monitor
Monitor被翻译为监视器,是由jvm提供,C++语言实现
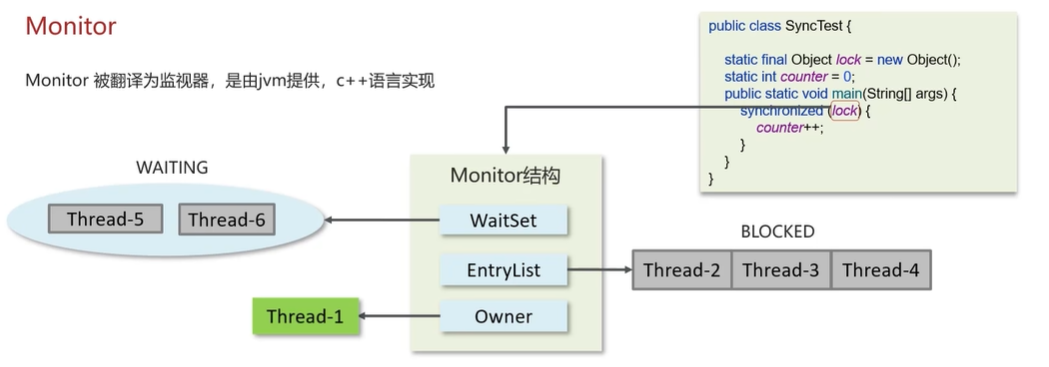
- Owner:存储当前获取锁的线程的,只能有一个线程可以获取
- EntryList:关联没有抢到锁的线程,处于Blocked状态的线程
- WaitSet:关联调用了wait方法的线程,处于Waiting状态的线程
1、Synchronized对象锁采用互斥的方式让同一时刻至多只有一个线程能持有对象锁
2、它的底层由monitor实现,moniter是jvm级别的对象(c++实现),线程获得锁需要使用对象(锁)关联monitor
3、在monitor内部有三个属性,分别是owner、entrylist、waitset
4、其中owner是关联的获得锁的线程,并且只能关联一个线程,entrylist关联的是处于阻塞状态的线程,waitset关联的是处于waiting状态的线程
重量级锁与锁升级
Monitor实现的锁属于重量级锁,里面设计到了用户态和内核态的切换、进程的上下文切换,成本较高。性能比较低
在JDK1.6引入了两种新型锁机制:偏向锁和轻量级锁,它们的引入是为了解决在没有多线程竞争或基本没有竞争的场景下因使用传统锁机制带来的性能开销问题。
对象是怎么关联上的Monitor?
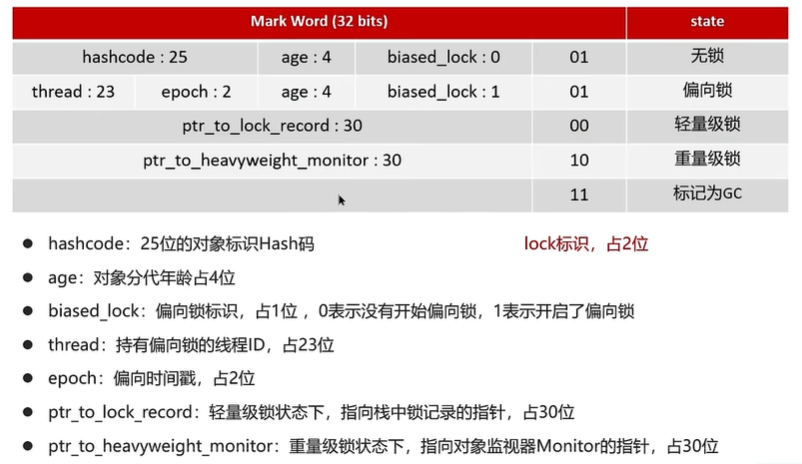
每个Java对象都可以关联一个Monitor对象,如果使用synchronized给对象上锁(重量级)之后,该对象对象头的Mark Word中就被设置指向Monitor对象的指针。
对象的内存结构
在HotSpot虚拟机中,对象在内存中存储的布局可以分为3块区域:对象头(Header)、实例数据(Instance Data)和对齐填充
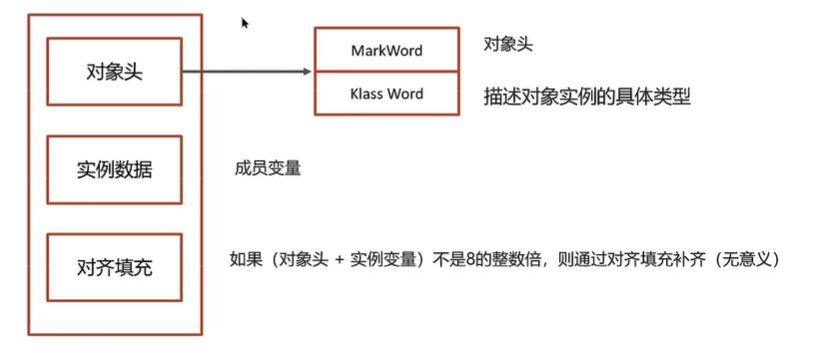
MarkWord
轻量级锁
在很多情况下,在Java程序运行时,同步块中的代码都是不存在竞争的,不同的线程交替的执行同步块中的代码,这种情况下,用重量级锁是每必要的,因此JVM引入了轻量级锁的概念。
加锁流程
1、在线程栈中创建一个Lock Record,将其obj字段指向锁对象
2、通过CAS指令将Lock Record的地址存储在对象头的mark word中,如果对象处于无锁状态则修改成功,代表该线程获得了轻量级锁
3、如果是当前线程已经持有该锁了,代表这是一次锁重入,设置Lock Record第一部分为null,起到了一个重入计数器的作用
4、如果CAS修改失败,说明发生了竞争,需要膨胀为重量级锁

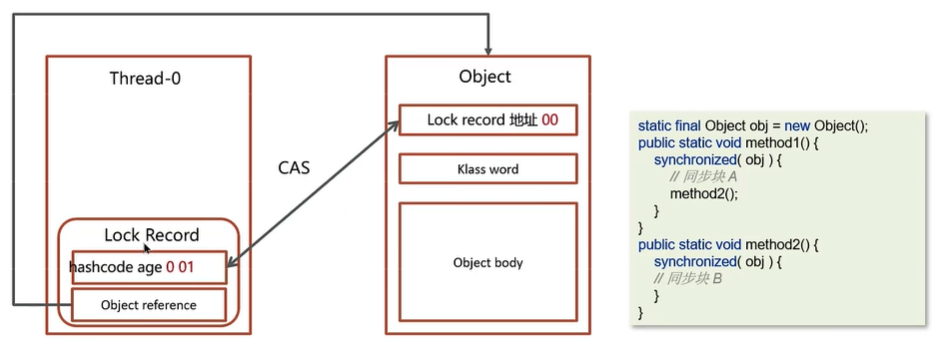
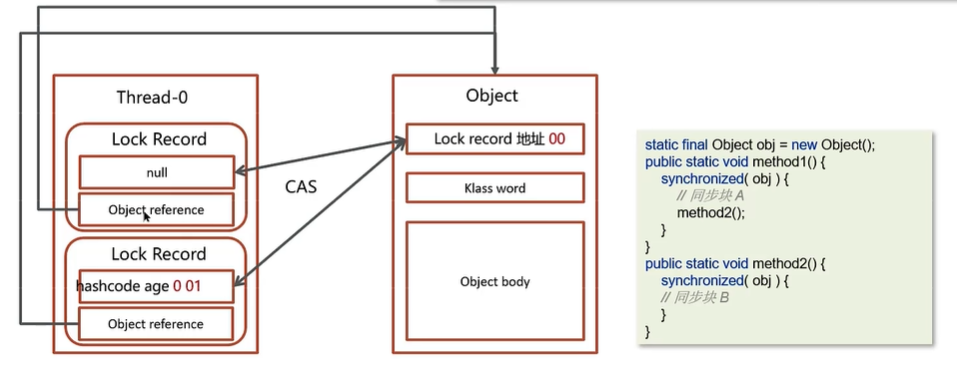
解锁过程
1、遍历线程栈,找到所有obj字段为等于当前锁对象的Lock Record
2、如果Lock Record的Mark Word为null,代表这是一次重入,将obj设置为null后continue
3、如果Lock Record的Mark Word不为null,则利用CSA指令将对象头的mark word恢复成无锁状态。如果失败则碰撞为重量级锁
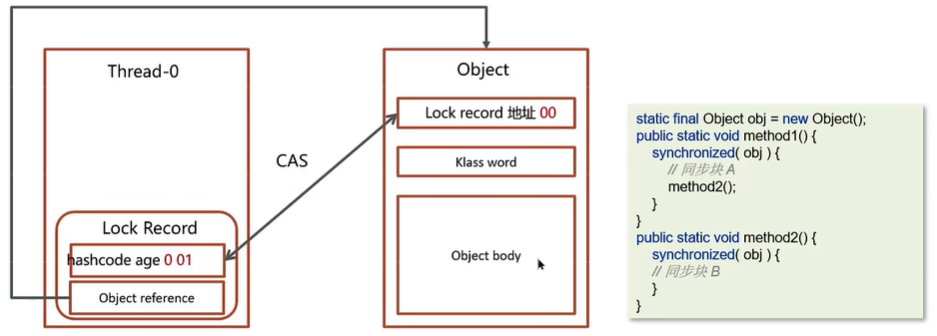
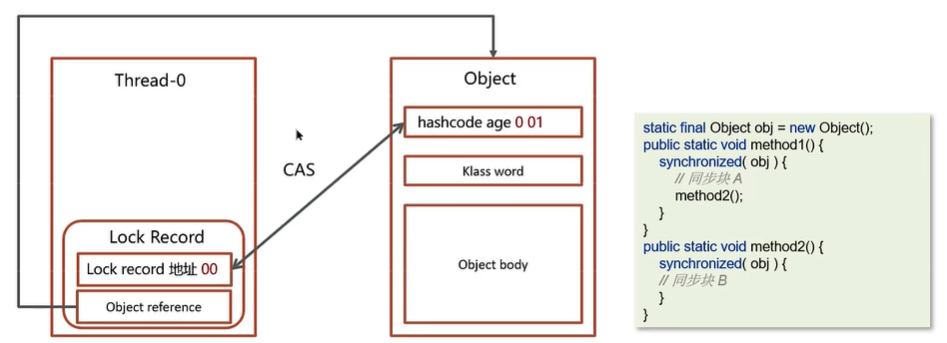
偏向锁
轻量级锁在没有竞争时(就自己这个线程),每次重入仍需要执行CAS操作。
Java6中引入了偏向锁来做进一步优化,只有第一次使用CAS将线程ID设置到对象头的Mark Word头,之后发现这个线程ID是自己的就表示没有竞争,不用重新CAS,以后只要不发生竞争,这个对象就归该线程所有
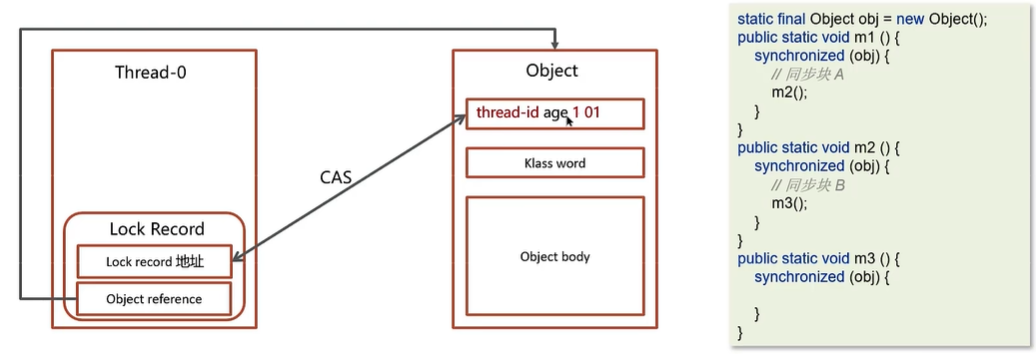
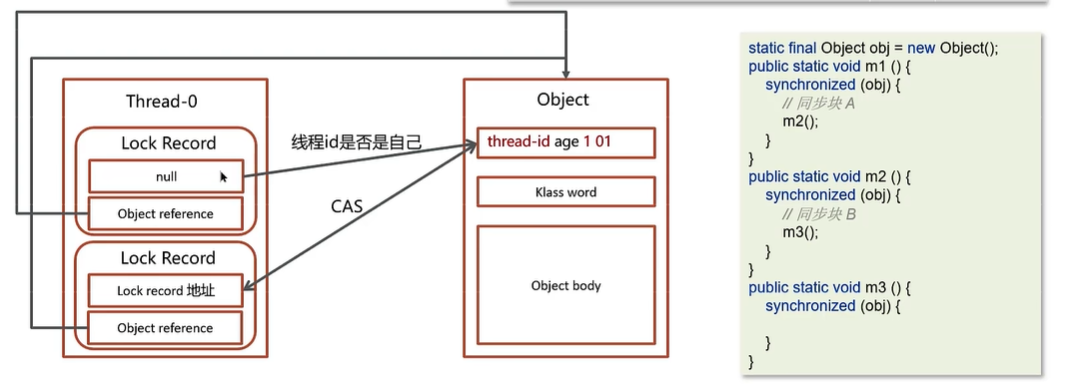
对比
Java中的synchronized有偏向锁、轻量级锁、重量级锁三种形式,分别对应了锁只被一个线程持有、不同线程交替持有锁、多线程竞争锁三种。
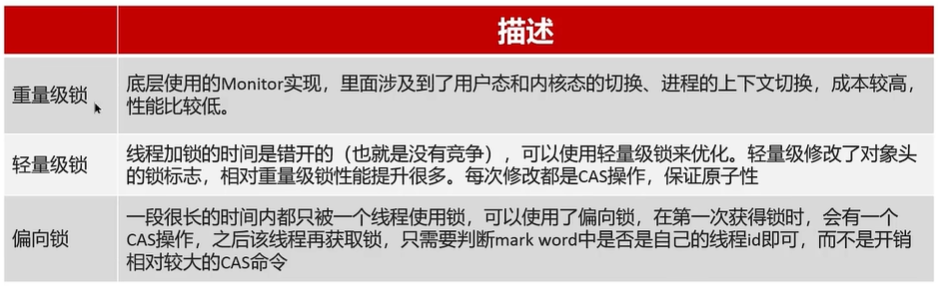
一旦锁发生了竞争,都会升级为重量级锁
二、JMM(Java内存模型)
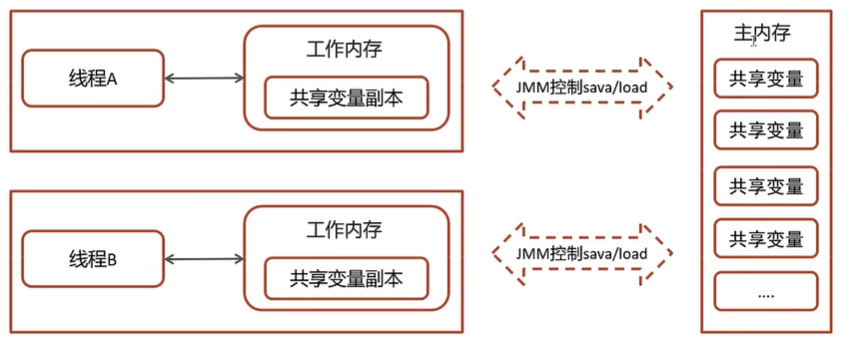
JMM(Java Memory Model)Java内存模型,定义了共享内存中多线程程序读写操作的行为规范,通过这些规则来规范对内存的读写操作从而保证指令的正确性
JMM把内存分为两块,一块是私有线程的工作区域(工作内存),一块是所有线程的共享区域(主内存)
线程跟线程之间是相互隔离,线程跟线程交互需要通过主内存
三、CAS
CAS:Compare And Swap(比较再交换),它体现的一种乐观锁的思想,在锁情况下保证线程操作共享数据的原子性。
在JUC(java.util.concurrent)包下实现的很多类都用到了CAS操作
- AbstractQueuedSynchronizer(AQS框架)
- AtomicXXX类
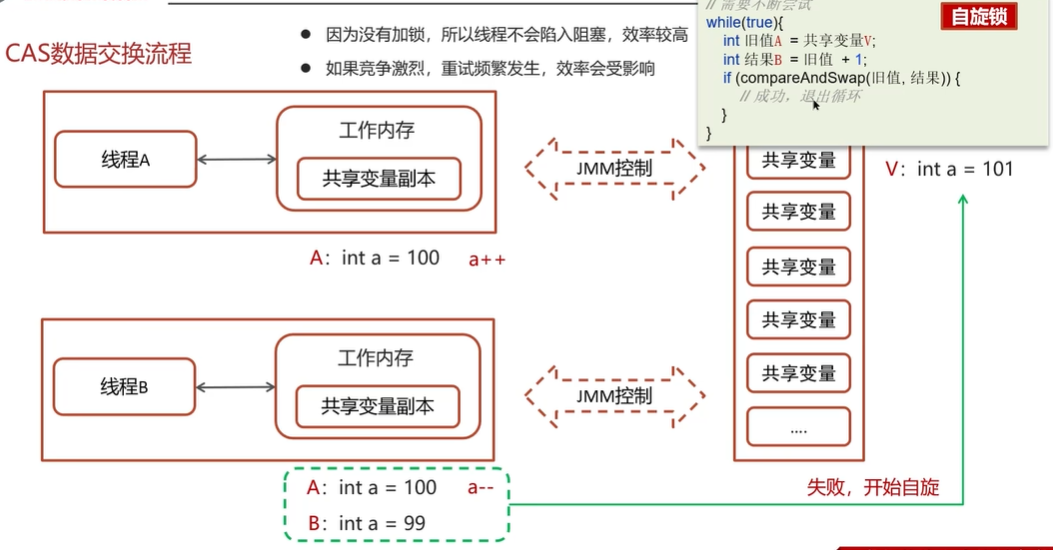
CAS底层依赖于一个Unsafe类来直接调用操作系统底层的CSA指令
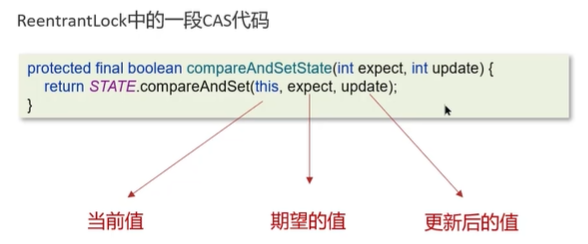
乐观锁和悲观锁
CSA基于乐观锁思想,最乐观的估计,不怕别的线程来修改共享变量,就算改了也没关系,可以重试
synchronized基于悲观锁,最悲观的估计,防止其它线程来修改共享变量,释放锁之后,其它线程才可以修改
四、对volatile的理解
一旦一个共享变量(类的成员变量、类的静态成员变量)被volatile修饰后,那么就具备了两层语义:
1、保证线程间的可见性
用volatile修饰共享变量,能够防止编译器等优化发生,让一个线程对共享变量的修改对另一个线程可见
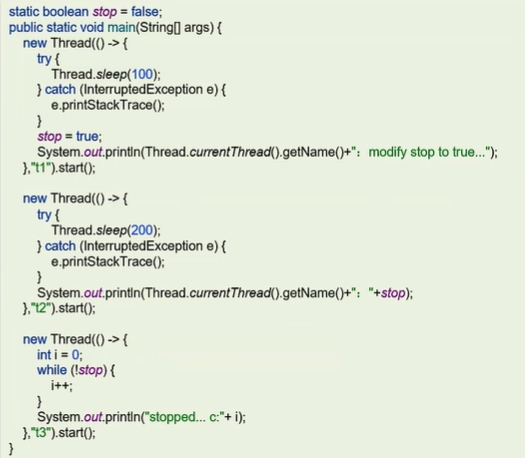
线程一打印正常,线程二打印true,但是线程三一直不结束
原因:主要因为在JVM虚拟机种有一个JIT(即时编译器)给代码做了优化
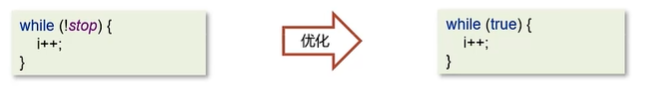
解决方案一:在程序运行的时候加入vm参数**-Xint**表示禁用即时编译器,不推荐,其它程序还要使用
解决方案二:在修饰stop变量的时候加上volatile,当前告诉JIT,不要对volatile修饰的变量做优化
2、禁止指令重排序
用volatile修饰共享变量会在读、写共享变量时加入不同的屏障,阻止其他读写操作越过屏障,从而达到阻止重排序的效果
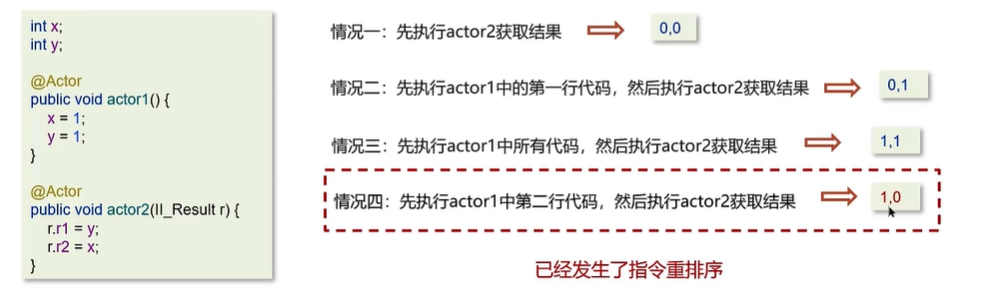
注解**@Actory**保证方法内的代码在同一个线程下进行
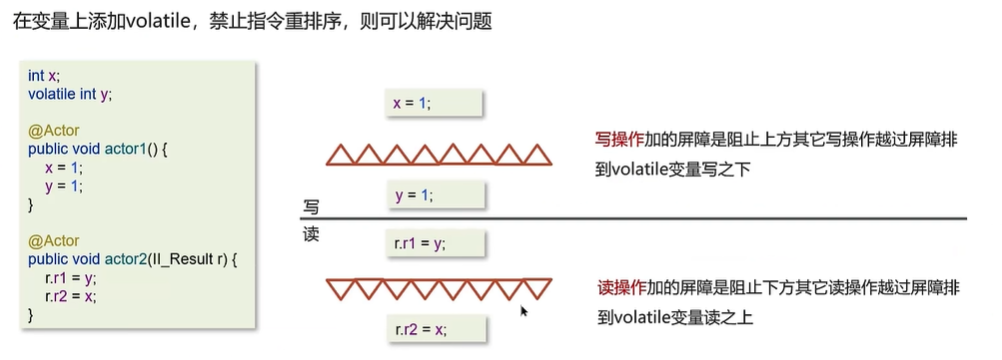
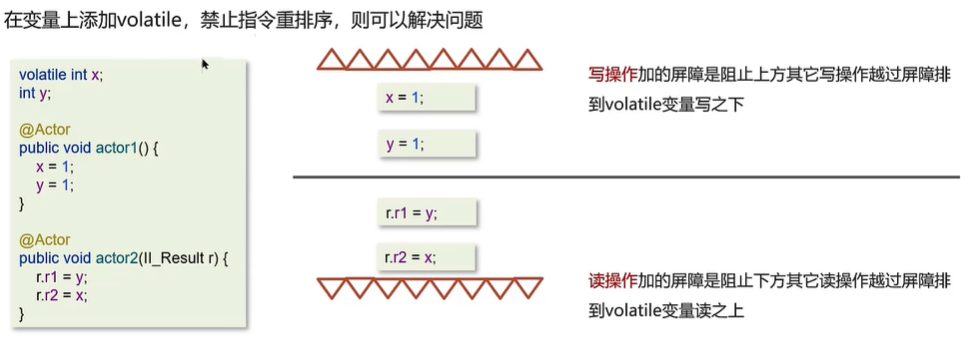
使用技巧:
- 写变量让volatile修饰的变量在代码的最后位置
- 读变量让volatile修饰的变量在代码的最开始位置
五、AQS
全称是 AbsrtactQueuedSynchronizer,即抽象队列同步器,它是构建锁或其他同步组件的基础框架
AQS与Synchronized的区别
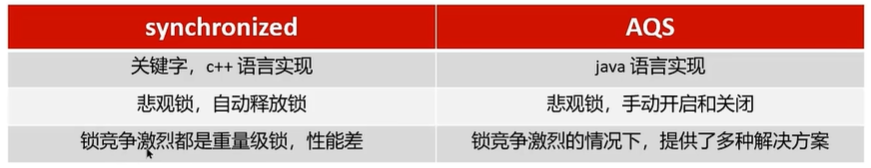
AQS常见的实现类
- ReentrantLock 阻塞式锁
- Semaphore 信号量
- CountDownLatch 倒计时锁
基本工作机制
AQS内部维护了一个先进先出的双向队列,队列中存储排队的线程
在AQS内部还有一个属性state,这个state就相当于是一个资源,默认是0(无锁状态),如果队列中的一个线程修改成功了state为1,则当前线程就相当于获取了资源
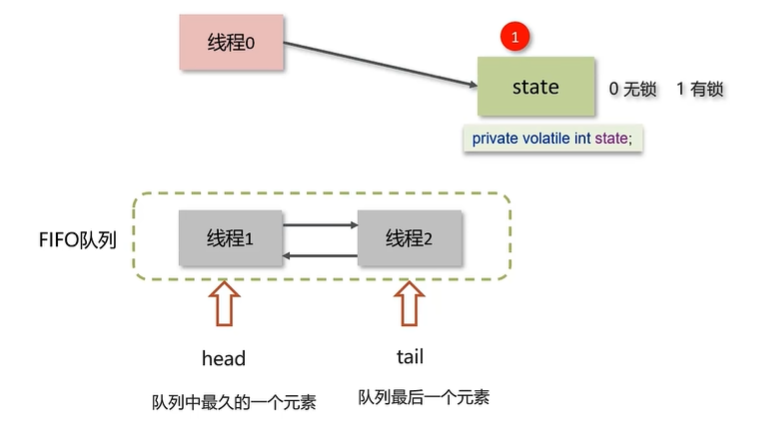
多个线程同时去抢资源,如果保证原子性?
CAS设置state状态,保证操作的原子性
AQS是公平锁还是非公平锁?
都可以实现
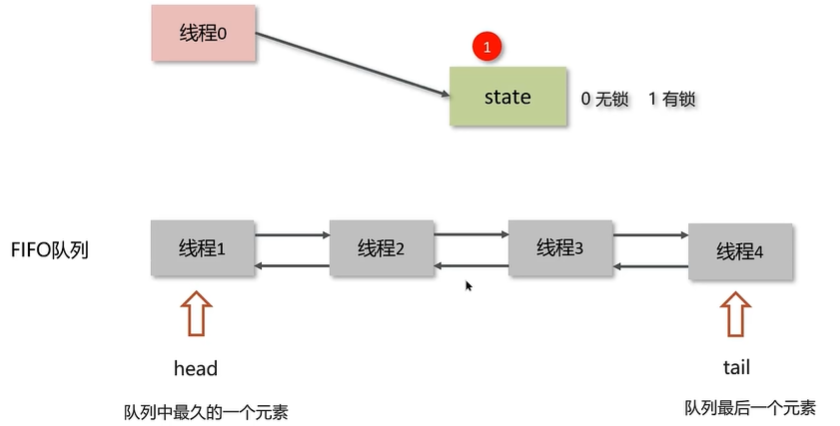
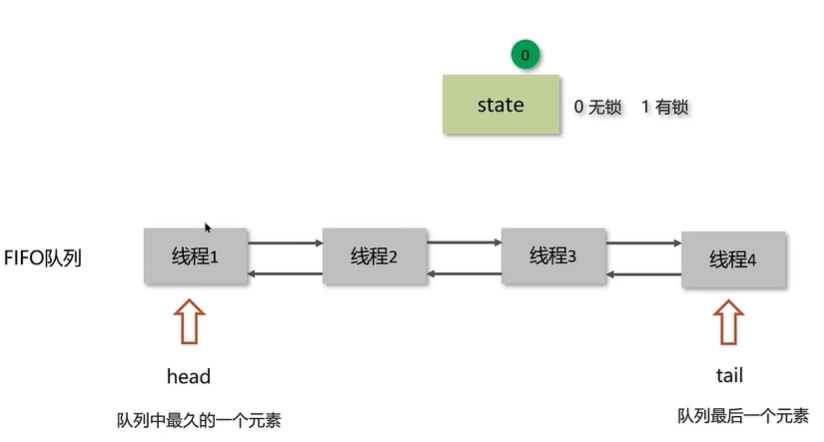
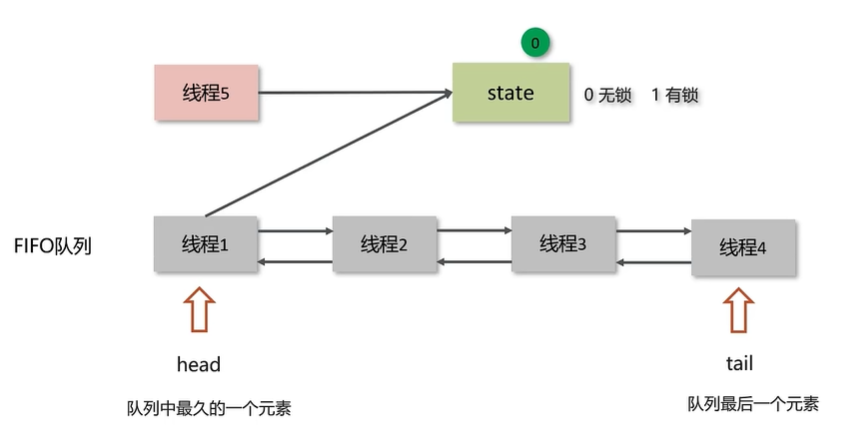
线程0结束后,把state状态改为0,此时唤醒队列中的head线程1,这时又来了一个不在队列中的线程5,恰巧线程5修改了state的状态(0 -> 1),此时就是非公平锁
线程0结束后,把state状态改为0,此时唤醒队列中的head线程1,这时进入队列,处在tail,线程1修改;了state的状态(0 -> 1),此时就是公平锁
六、ReentrantLock的实现原理
ReentrantLock翻译过来是可重入锁,相对于synchronized
- 可中断
- 可以设置超过时间
- 可以设置公平锁
- 支持多个条件变量
- 与synchronized一样,都支持重入
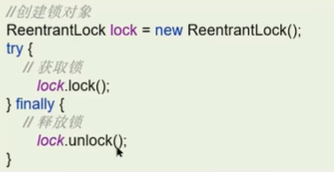
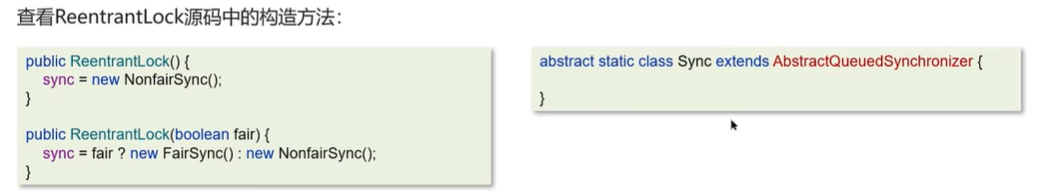
ReentrantLock主要利用CAS + AQS队列来实现,它支持公平锁和非公平锁,两者的实现类似
构造方法接受一个可选的公平参数(默认非公平锁),当设置为true时,表示公平锁,否则为非公平锁。公平锁的效率往往没有非公平锁的效率高,在许多线程访问的情况下,公平锁表现出较低的吞吐量。
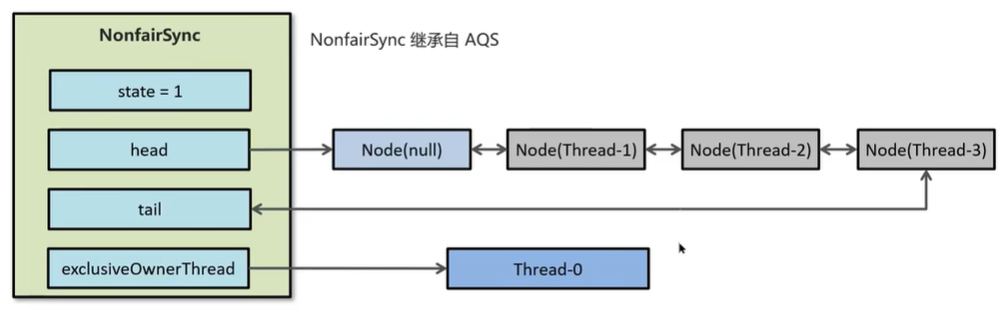
- 线程来抢锁后使用CAS的方式修改state状态,修改状态成功为1,则让exclusiveOwnerThread属性指向当前线程,获取锁成功
- 加入修改状态失败,则会进入双向队列中等待,head指向双向队列头部,tail指向双向队列尾部
- 当exclusiveOwnerThread为null的时候,则会唤醒在双向队列中等待的线程
- 公平锁则体现在按照先后顺序获取锁,非公平体现在不在排队的线程也可以抢锁
七、synchronized和Lock的区别
- 语法层面
synchronized是关键字,源码在jvm中,用c ++ 语言实现
Lock是接口,源码由jdk提供,用java语言实现
使用synchronized时,退出同步代码块锁会自动释放,而使用Lock时,需要手动调用unlock方法释放锁
- 功能层面
二者均属于悲观锁、都具备基本的互斥、同步、锁重入功能
Lock提供了许多synchronized不具备的功能,例如公平锁,可打断锁,可超时,多条件变量
Lock有适合不同场景的实现,如ReentrantLock,ReentrantReadWriteLock(读写锁)
- 性能层面
在没有竞争时,synchronized做了很多优化,如偏向锁,轻量级锁,性能不赖
在竞争激烈时,Lock的实现通常会提供更好的性能
八、死锁产生的条件
死锁:一个线程需要同时获取多把锁,这是就容易发生死锁
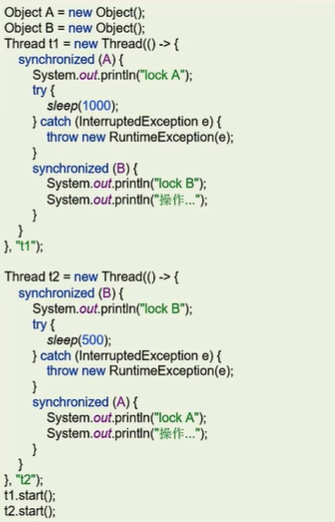
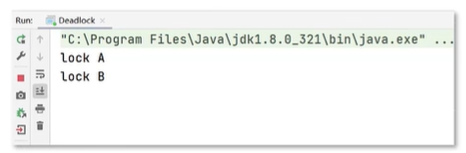
此时程序并没有结束,这种现象就是死锁现象,线程t1持有A的锁等待获取B锁,线程t2持有B的锁等待获取A的锁
如何进行死锁诊断?
当程序出现了死锁现象,我们可以使用jdk自带的工具:jps和jstack
- jps:输出JVM中运行的进程状态信息
- jstack:查看java进程内线程的堆栈信息
输入jps后,会显示这个死锁进程的id,然后输入jstack -l id
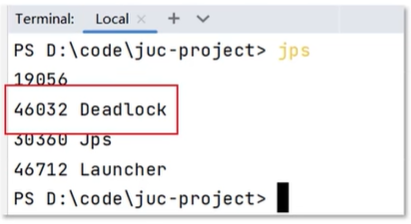
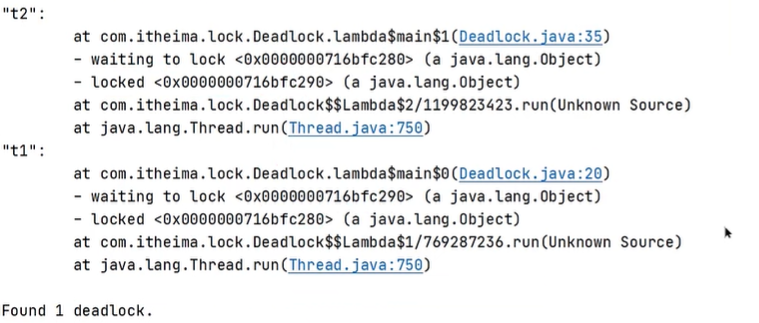
可视化工具:
- jconsole
用于对jvm的内存,线程,类的监控,是一个基于jmx的GUI性能监控工具,打开方式:java安装目录bin目录下 直接启动jconsole.exe运行
- VisualVM:故障处理工具
能够监控线程,内存情况,查看方法的CPU时间和内存中的对象,已被GC的对象,反向查看分配的堆栈,打开方式:java安装目录bin目录下 直接启动jvisualvm.exe就行
九、ConcurrentHashMap
ConcurrentHashMap是一种线程安全的高效Map集合
底层数据结构:
- jdk1.7底层采用分段数组+链表实现
- jdk1.8采用的数据结构跟HashMap1.8的结构一样,数组+链表/红黑树
jdk1.7
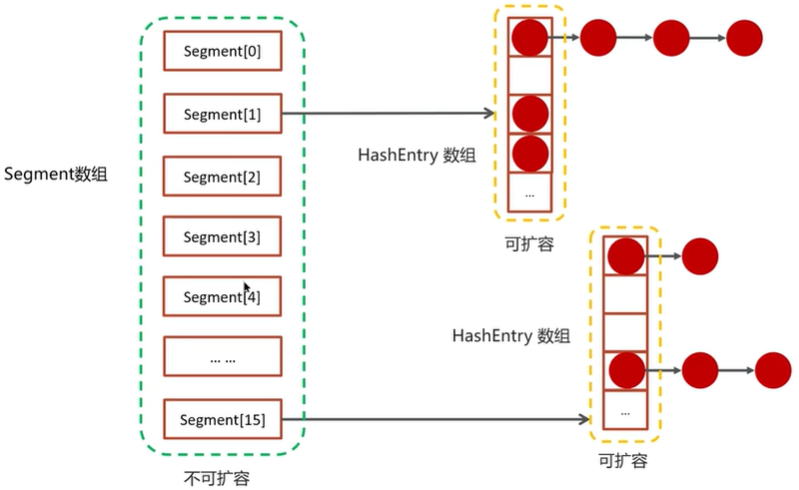
put操作

jdk1.8
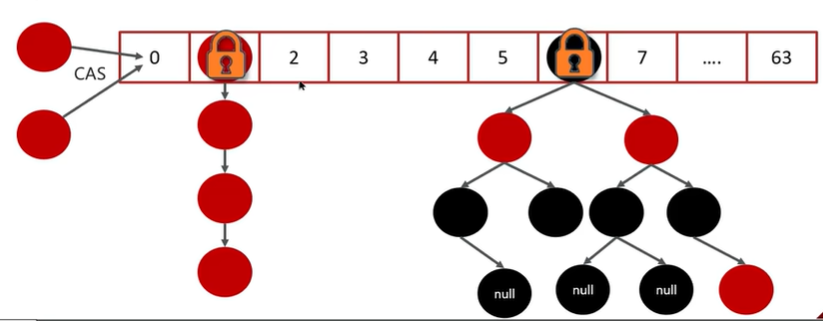
放弃了Segment臃肿的设计,数据结构跟HashMap1.8的数据结构一样:数组 + 链表 + 红黑树,采用CAS + Synchronized来保证并发安全进行实现
- CAS控制数组节点的添加
- synchronized只锁定当前链表或红黑树的首节点,只要hash不冲突,就不会产生并发的问题,效率得到提升
十、导致并发程序出现问题的根本原因/Java程序中怎么保证多线程的执行安全
Java并发编程三大特性:原子性,可见性,有序性
原子性
一个线程在CPU中操作不可暂停,也不可中断,要么执行完成,要么不执行
解决:
1、synchronized:同步加锁
2、JUC里面的lock:加锁
内存可见性
让一个线程对共享变量的修改对另一个线程可见
解决:
1、加锁,synchronized或Lock
2、用volatile修饰共享变量
有序性
指令重排:处理器为了提高程序运行效率,可能会对输入代码进行优化,它不保证程序中各个语句的执行先后顺序同代码中的顺序一致,但是它会保证程序最终执行结果和代码顺序执行的结果是一致的
解决:
用volatile修饰变量
- 写变量让volatile修饰的变量在代码的最后位置
- 读变量让volatile修饰的变量在代码的最开始位置
6.3线程池
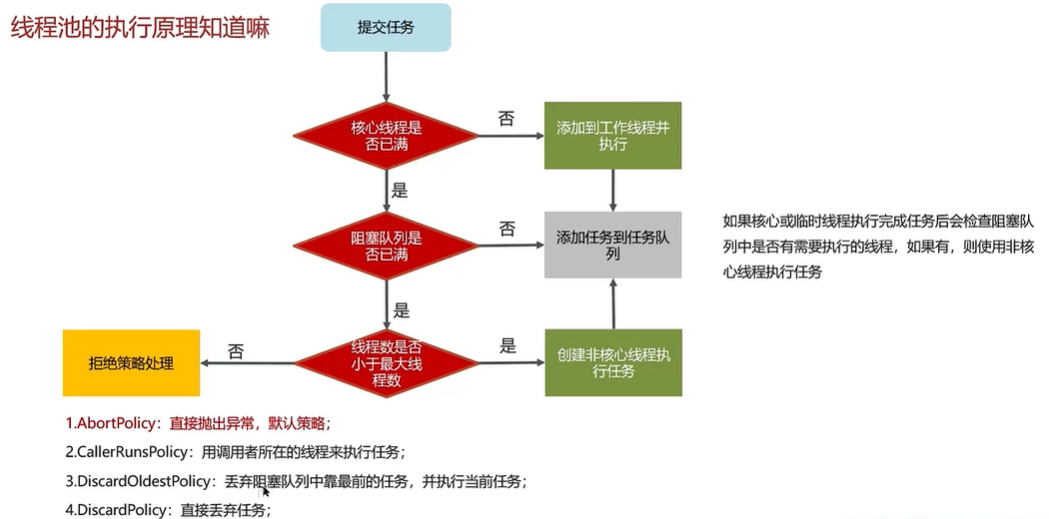
一、线程池的执行原理(线程池的核心参数)
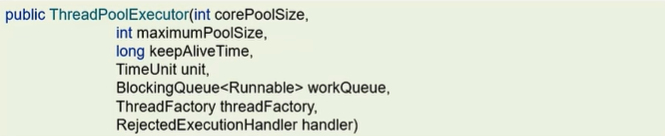
- corePoolSize:核心线程数目
- maximumPoolSize:最大线程数目 = (核心线程 + 救急线程的最大数目)
- KeepAliveTime:生存时间 - 救急线程的生存时间,生存时间内没有新任务,此线程资源会释放
- unit:时间单位 - 救急线程的生存时间单位,如秒、毫秒等
- workQueue:当没有空闲核心线程时,新来任务会加入到此队列排队,队列满时会创建救急线程执行任务
- threadFactory:线程工厂,可以定制线程对象的创建,例如设置线程名字,是否守护线程等
- handler:拒绝策略,当前所有线程都在繁忙,workQueue也放满时,会触发拒绝策略
二、线程池中有哪些常见的阻塞队列
workQueue:当没有空闲核心线程时,新来任务会加入到此队列排队,队列满时会创建救急线程执行任务
1、ArrayBlockingQueue:基于数组结构的有界阻塞队列,FIFO
2、LinkedBlockingQueue:基于链表结构的有界阻塞队列,FIFO
3、DelayedWorkQueue:是一个优先级队列,可以保证每次出队的任务都是当前队列中执行时间最靠前的
4、SynchronousQueue:不存储元素的阻塞队列,每个插入操作都必须等待一个移出操作
ArrayBlockingQueue和LinkedBlockingQueue的区别
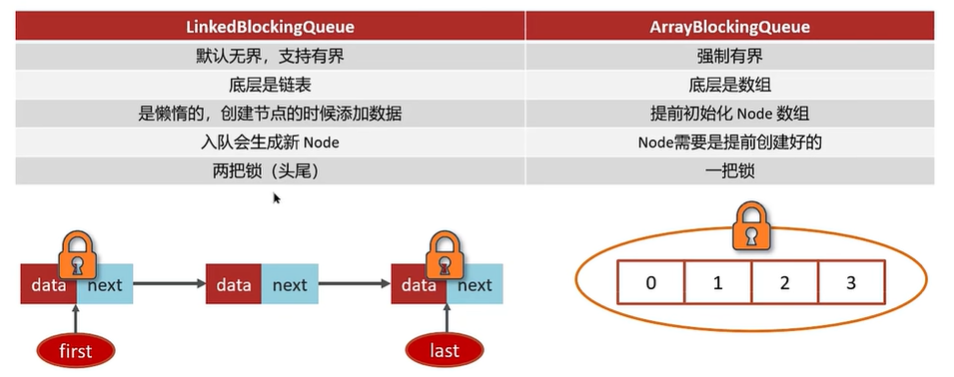
无界:最大为Integer的最大值
三、如何确定核心线程数
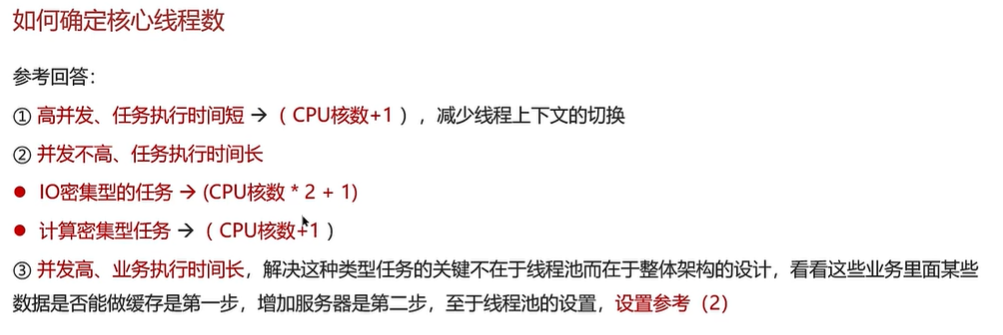
- IO密集型任务
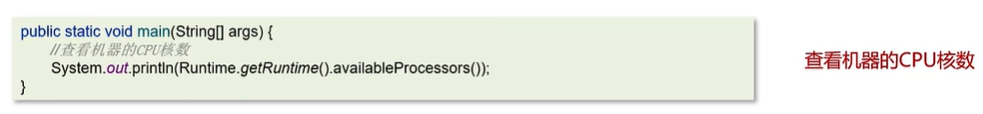
一般来说:文件读写,DB读写,网络请求等 核心线程数大小设置为CPU核数 * 2 + 1
- CPU密集型任务
一般来说:计算型代码,Bitmap转换,Gson转换等 核心线程数大小设置为CPU核数 + 1
四、线程池的种类有哪些
在java.util.concurrent.Executors类中提供了大量创建连接池的静态方法,常见就有四种
1、newFixedThreadPool
创建使用固定线程数的线程池——适用于任务量已知,相对耗时的任务
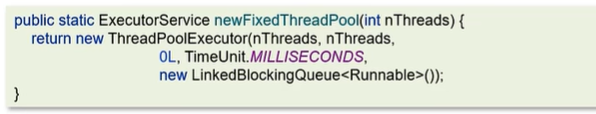
- 核心线程数与最大线程数一样,没有救急线程
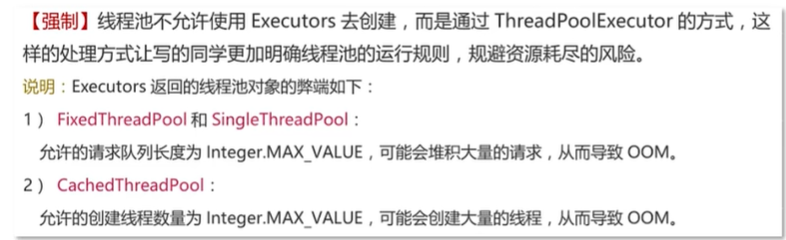
- 阻塞队列是LinkedBlockedQueue,最大容量为Integer.MAX_VALUE
2、newSingleThreadExecutor
单线程化的线程池,它只会用唯一的工作线程来执行任务,保证所有任务按照指定顺序(FIFO)执行——适用于按照顺序执行的任务
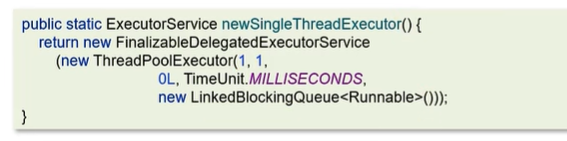
- 核心线程数和最大线程数都是1
- 阻塞队列是LinkedBlockingQueue,最大容量为Integer.MAX_VALUE
3、newCachedThreadPool
可缓存线程池——适合任务数比较密集,但每个任务执行时间较短的情况
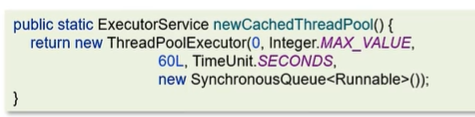
- 核心线程数为0
- 最大线程数是Integer.MAX_VALUE
- 阻塞队列为SynchronousQueue:不存储元素的阻塞队列,每个插入操作都必须等待一个移出操作
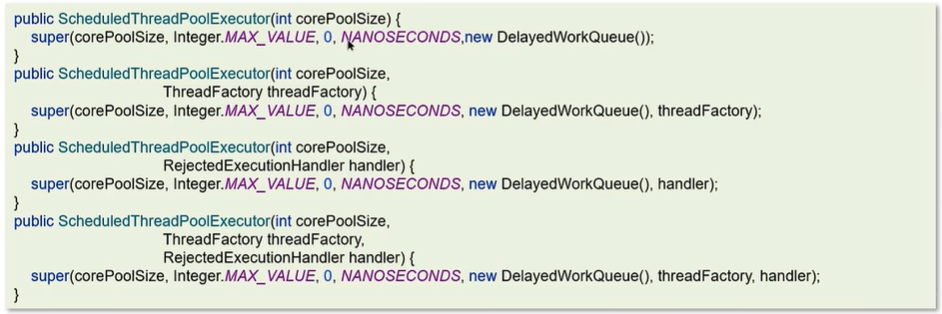
4、newScheduledThreadPool
提供了“延迟”和“周期执行”功能的ThreadPoolExecutor
五、为什么不建议用Executors创建线程池
6.4使用场景
一、线程池的使用场景(CountDownLatch、Future)
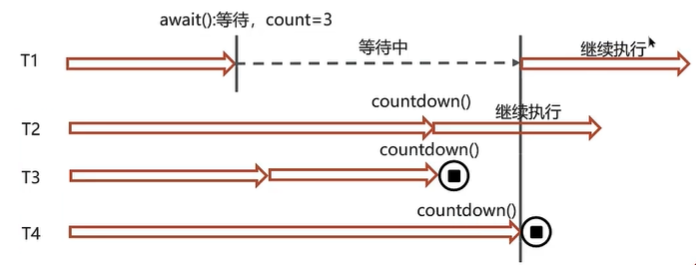
CountDownLatch(闭锁、倒计时锁)用来进行线程同步协作,等待所有线程完成倒计时(一个或者多个线程,等待其他多个线程完成某件事情之后才能执行)
- 其中构造参数用来初始化等待计数值
- await()用来等待计数归零
- countDown()用来让计数减一
使用场景一:es数据批量导入
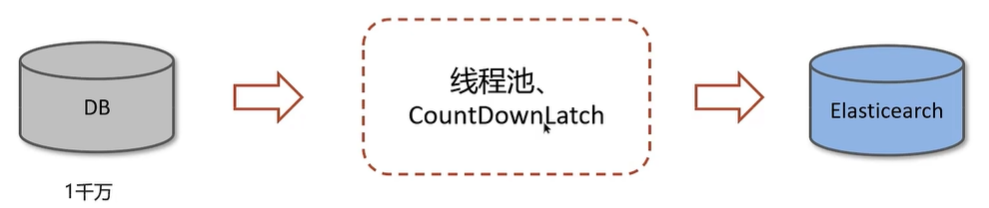
在我们项目上线之前,我们需要把数据库中的数据一次性同步到es索引库中,但是当时的数据好像是1000万左右,一次性读取数据肯定不行(oom异常),当时我就想到可以使用线程池的方式导入,利用CountDownLatch来控制,就能避免一次性加载过多,防止内存溢出

使用场景二:数据汇总
在一个电商网站中,用户下单之后,需要查询数据,数据包含了三部分:订单信息,包含的商品,物流信息,这三块信息都在不同的微服务中进行实现的,我们如何完成这个业务呢?
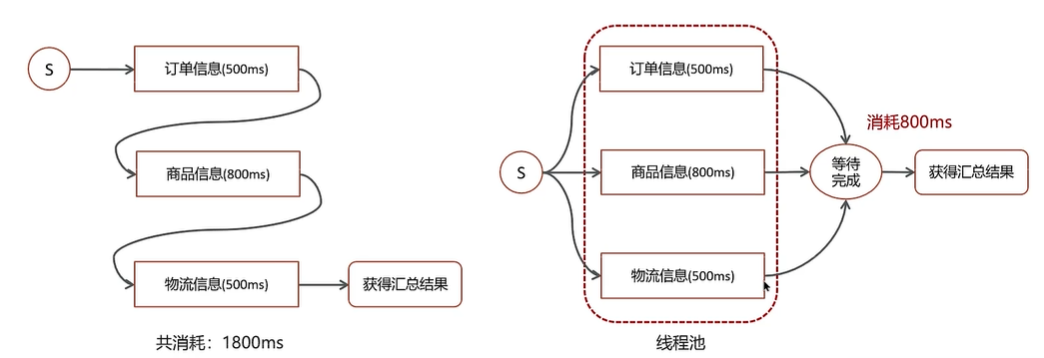
在实际开发的过程中,难免需要调用多个接口来汇总数据,如果所有接口(或部分接口)没有依赖关系,就可以使用线程池+future来提升性能
使用场景三:异步调用
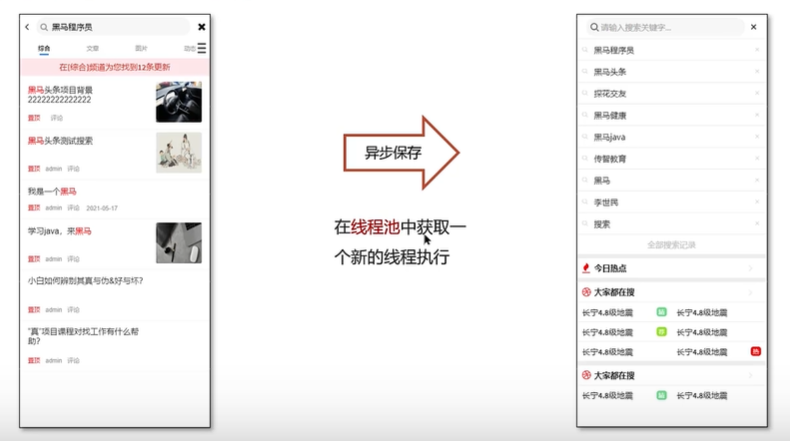
为了避免下一级方法(保存历史记录)影响上一级方法(查询结果)(性能考虑),可使用异步线程调用下一个方法(前提:上一级方法不需要下一级方法返回值),可以提升方法响应时间
二、如何控制某个方法允许并发访问线程的数量
Semaphore:信号量,是JUC包下的一个工具类,底层是AQS,我们可以通过其限制执行的线程数量
使用场景:通常用于那些资源有明确访问数量限制的场景,常用于限流
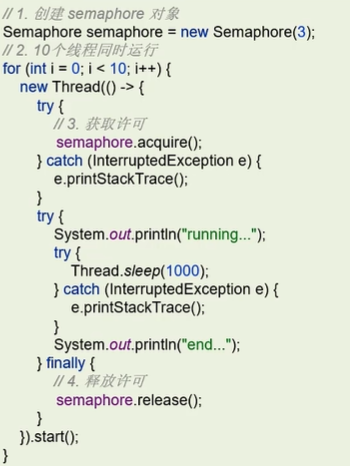
Semaphore使用步骤
- 创建Semaphore对象,可以给一个容量
- semaphore.acquire():请求一个信号量,这时候信号量个数-1(一旦没有可使用的信号量,即信号量个数变为负数时,再次请求的时候就会阻塞,直到其他线程释放了信号量)
- semaphore.release():释放一个信号量,此时信号量个数+1
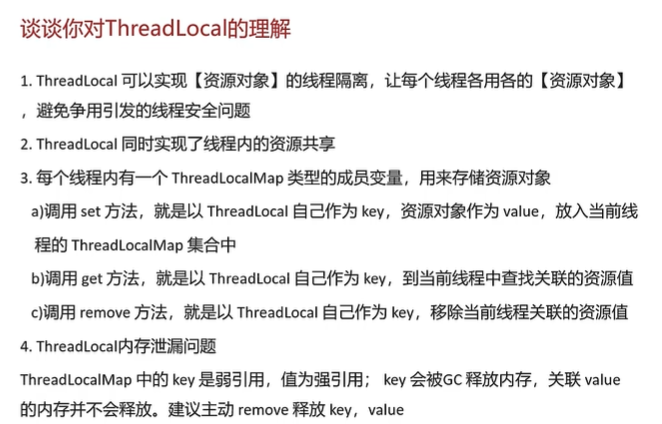
三、谈谈你对ThreadLocal的理解
ThreadLocal是多线程中对于解决线程安全的一个操作类,它会为每个线程都分配一个独立的线程副本从而解决了变量并发访问冲突的问题。ThreadLocal同时实现了线程内的资源共享
案例:使用JDBC操作数据库时,会将每一个线程的Connection放入各自的ThreadLocal中,从而保证每个线程都在各自的Connection上进行数据库的操作,避免A线程关闭了B线程的连接
ThreadLocal基本使用
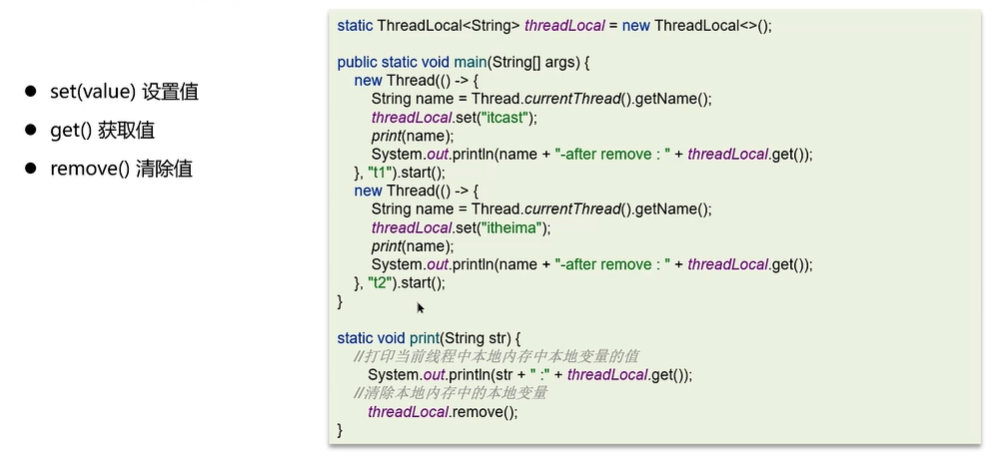
ThreadLocal实现原理&源码解析
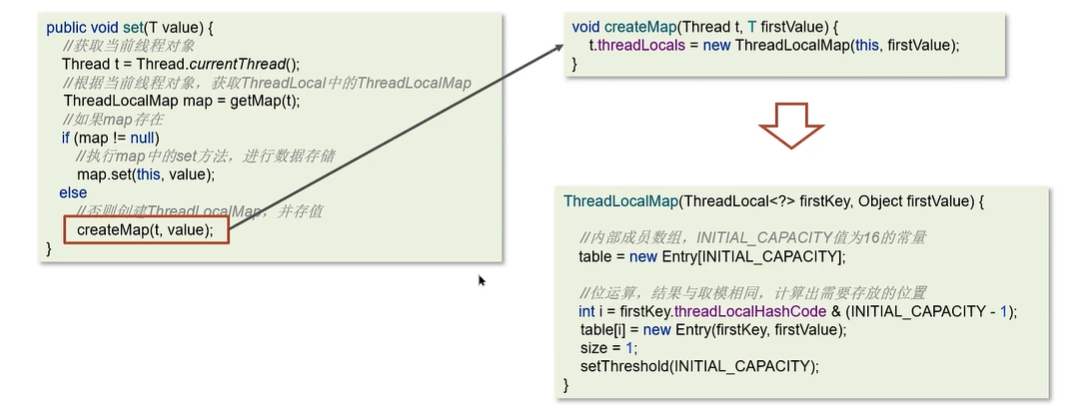
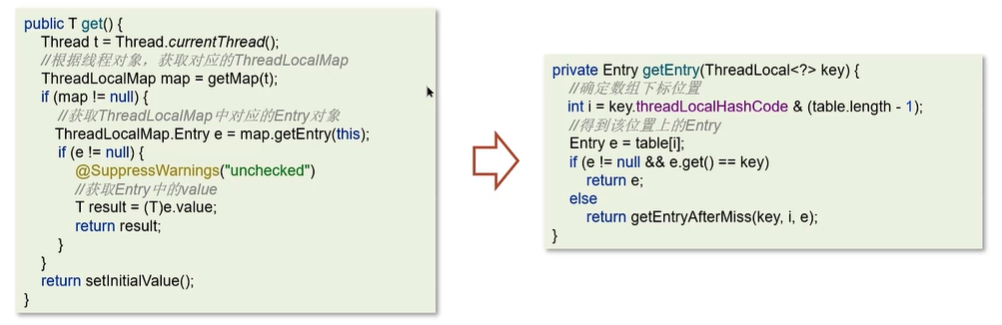
ThreadLocal本质来说就是一个线程内部存储类,从而让多个线程只操作自己内部的值,从而实现线程数据隔离
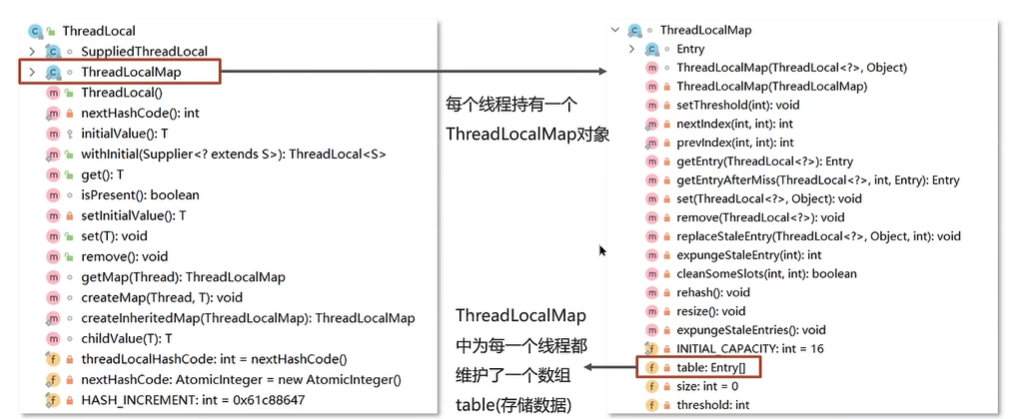
set方法
get方法/remove方法
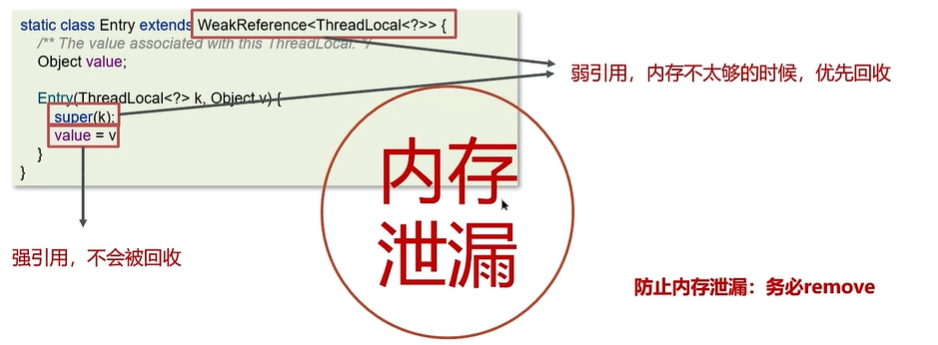
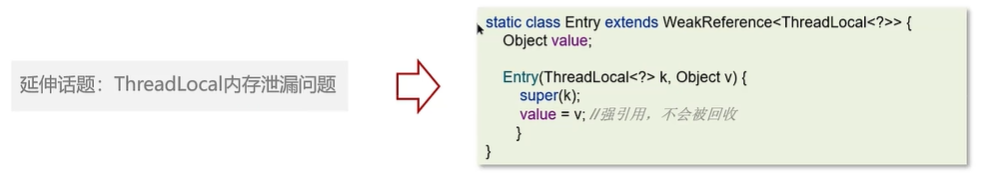
ThreadLocal内存泄漏的问题
Java对象中的四种引用类型:强引用、软引用、弱引用、虚引用
- 强引用:最为普通的一种引用方式,表示一个对象处于有用且必须的状态,如果一个对象具有强引用,则GC并不会回收它,即便堆中的内存不足了,宁可出现OOM,也不会对其进行回收
User user = new User();- 弱引用:表示一个对象处于可能有用且非必须的状态,在GC线程扫描内存区域时,一旦发现弱引用,就会回收到弱引用相关联的对象,对于弱引用的回收,无关内存区域是否足够,一旦发现则会被回收
User user = new User();
WeakReference weakReference = new WeakReference(user);每一个Thread维护一个ThreadLocalMap,在ThreadLocalMap中的Entry对象继承了WeakReference。其中Key为使用弱引用的ThreadLocal实例,value为线程变量的副本
第七章 JVM
Java Virtual Machine Java程序的运行环境(java二进制字节码的运行环境)
好处:
- 一次编写,到处运行
- 自动内存管理,垃圾回收机制
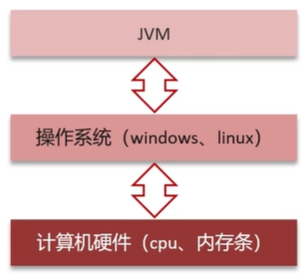
运行流程
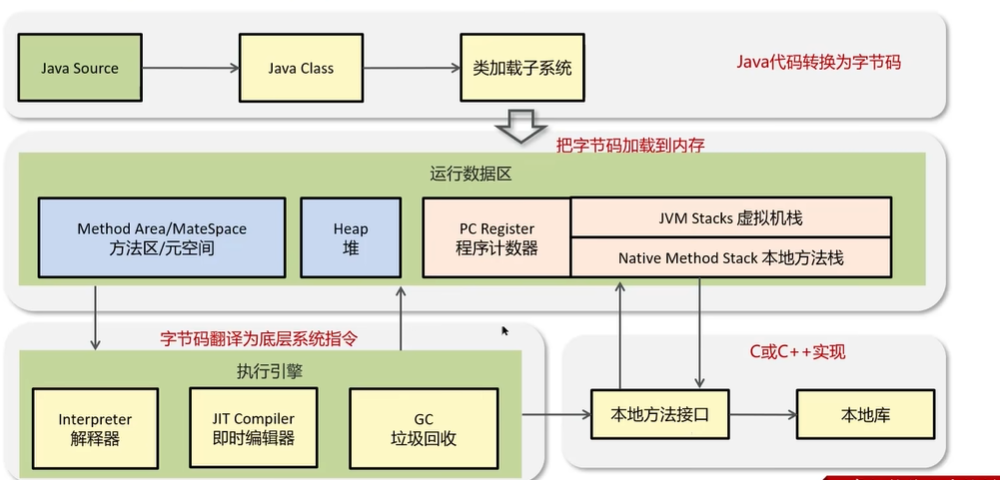
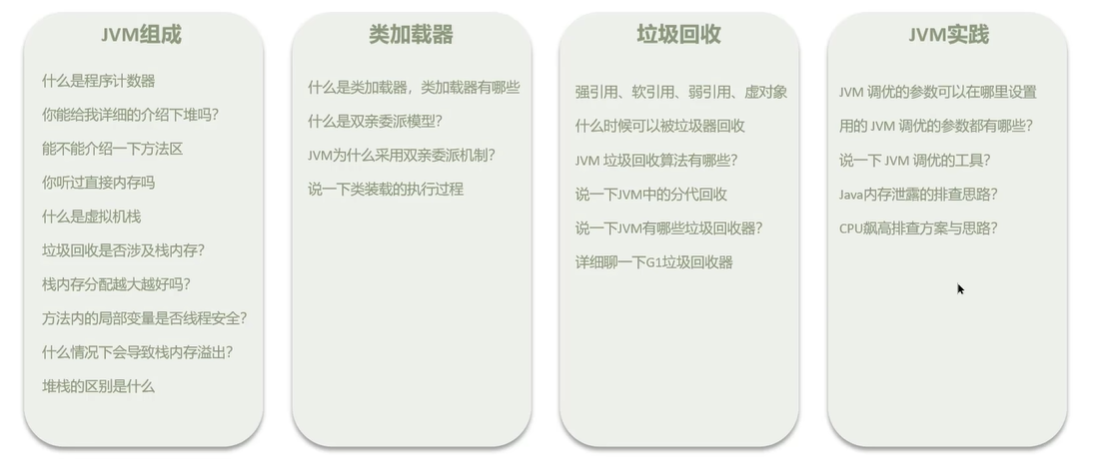
7.1JVM组成
一、什么是程序计数器
程序计数器:线程私有的,每个线程一份,内部保存的字节码的行号,用于记录正在执行的字节码指令的地址
javap -v xx.class //打印堆栈大小,局部变量的数量和方法的参数
二、Java堆
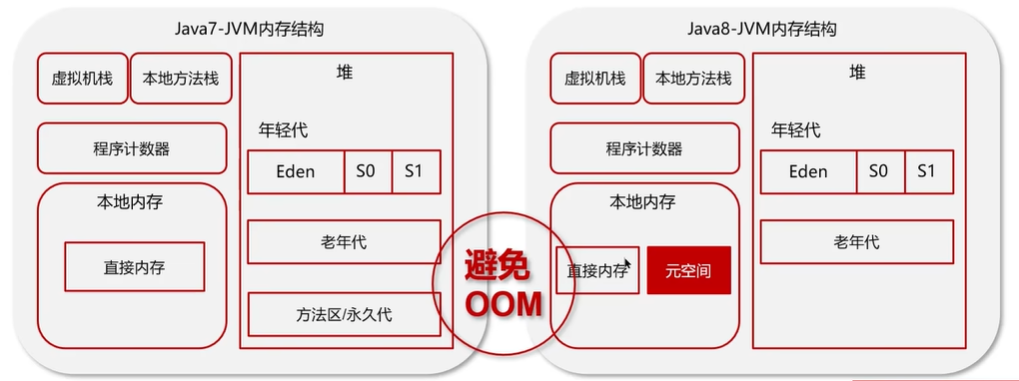
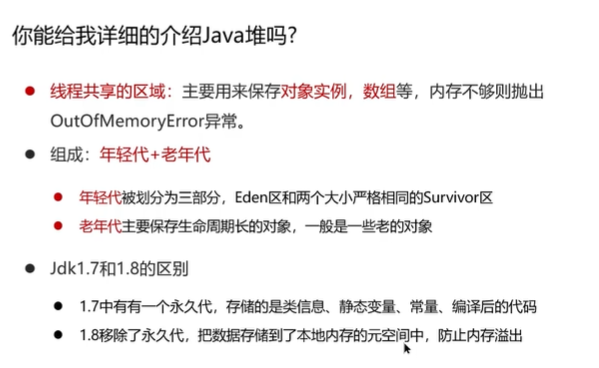
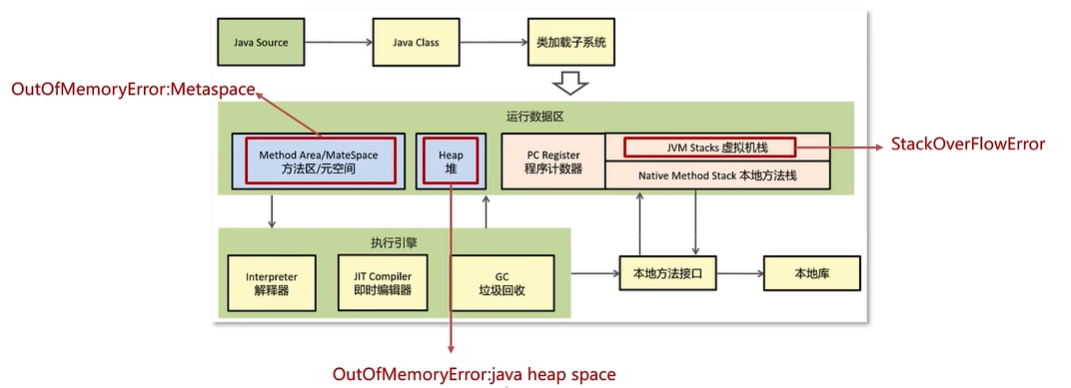
线程共享的区域:主要用来保存对象实例,数组等,当堆中没有内存空间可分配给实例,也无法再扩展时,则抛出OutOfMemoryError(OOM)(内存溢出)异常
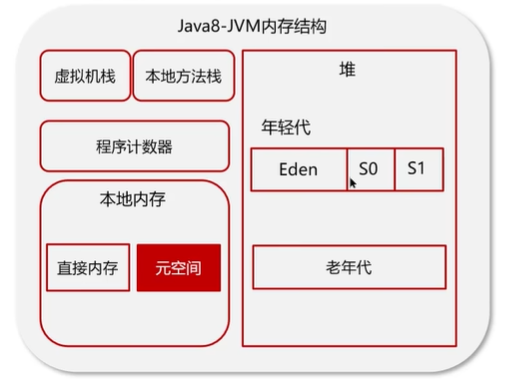
年轻代被划分为三部分,Eden区和两个大小严格相同的Survivor(幸存者)区,根据JVM的策略,在经过几次垃圾收集后,仍然存活于Survivor的对象将被移动到老年代区间
老年代主要保存生命周期长的对象,一般是一些老的对象
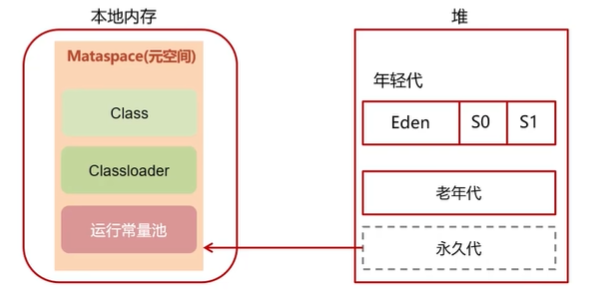
元空间保存的类信息,静态变量,常量,编译后的代码
java7和java8的JVM内存结构的区别
三、什么是虚拟机栈
Java Virtual machine Stacks(java虚拟机栈)
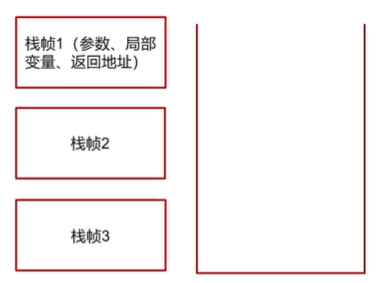
- 每个线程运行时需要的内存,称为虚拟机栈,先进后出
- 每个栈由多个栈帧(frame)组成,对应着每次方法调用时所占用的内存
- 每个线程只能有一个活动栈帧,对应着当前正在执行的那个方法
1、垃圾回收是否涉及栈内存?
垃圾回收主要指的就是堆内存,当栈帧弹栈以后,内存就会释放
2、栈内存分配越大越好吗?
未必,默认的栈内存通常为1024k
栈帧过大会导致线程数变少,例如,机器总内存为512m,目前能活动的线程数为512个,如果把栈内存改为2048k,那么能活动的栈帧就会减半
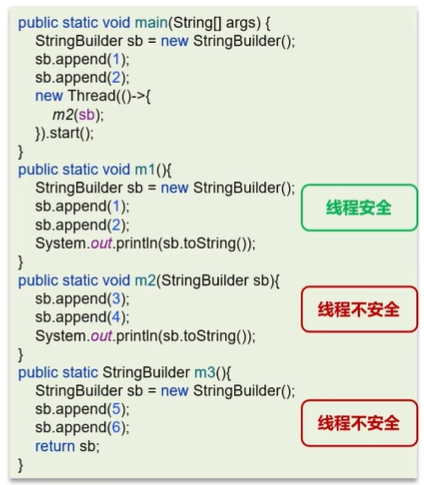
3、方法内的局部变量是否是线程安全的?
- 如果方法内局部变量没有逃离方法的作用范围,它是线程安全的
- 如果是局部变量引用了对象,并逃离方法的作用范围,需要考虑线程安全
四、栈内存溢出(OOM)情况
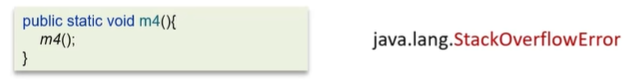
- 栈帧过多导致栈内存溢出,典型:递归调用
- 栈帧过大导致栈内存溢出
五、栈和堆的区别
- 栈内存一般会用来存储局部变量和方法调用,但堆内存是用来存储Java对象和数组的、堆会GC垃圾回收,而栈不会
- 栈内存是线程私有的,而堆内存是线程共有的
- 两者异常错误不同,但如果栈内存或者堆内存不足都会抛异常
- 栈空间不足:java.lang.StackOverFlowError
- 堆空间不足:java.lang.OutOfMemoryError
六、方法区/元空间
- 方法区(Method Area)是各个线程共享的内存区域
- 主要存储类的信息、运行时常量池
- 虚拟机启动的时候创建,关闭虚拟机时释放
- 如果方法区域中的内存无法满足分配请求,则会抛出OutOfMemoryError:Metaspace
常量池
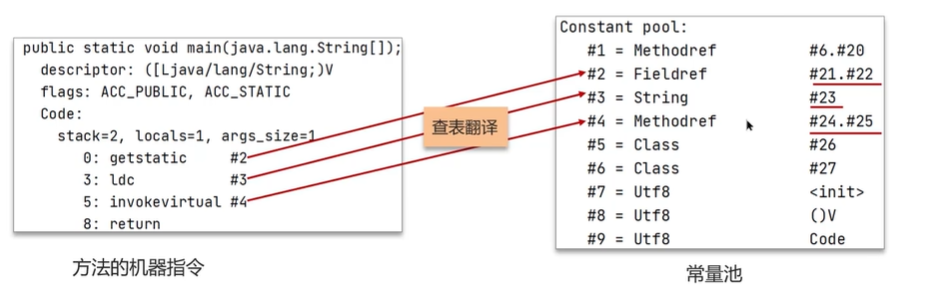
可以看作是一张表,虚拟机指令根据这张常量表找到要执行的类名,方法名,参数类型,字面量等信息

运行时常量池
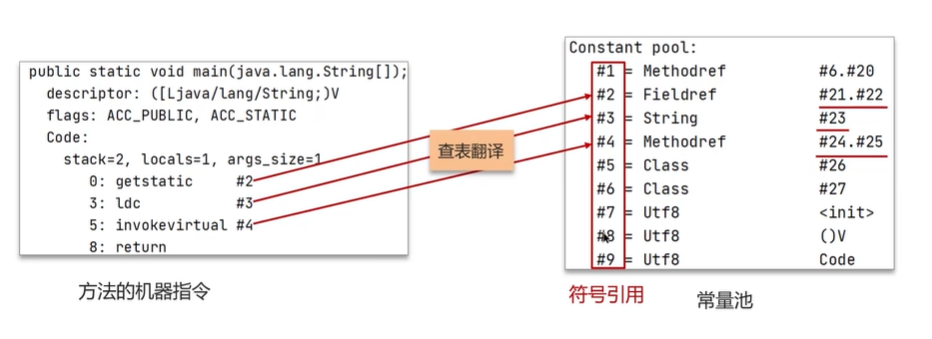
常量池是***.class文件中的,当该类被加载,它的常量池信息就会放入运行时常量池**,并把里面的符合地址变为真实地址
七、直接内存
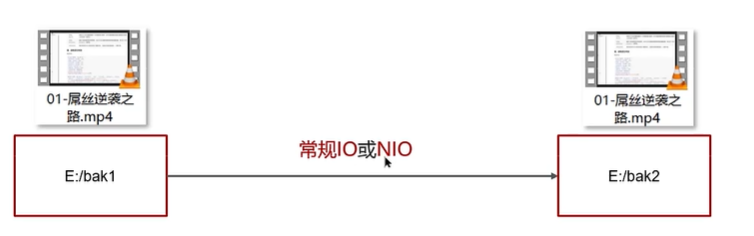
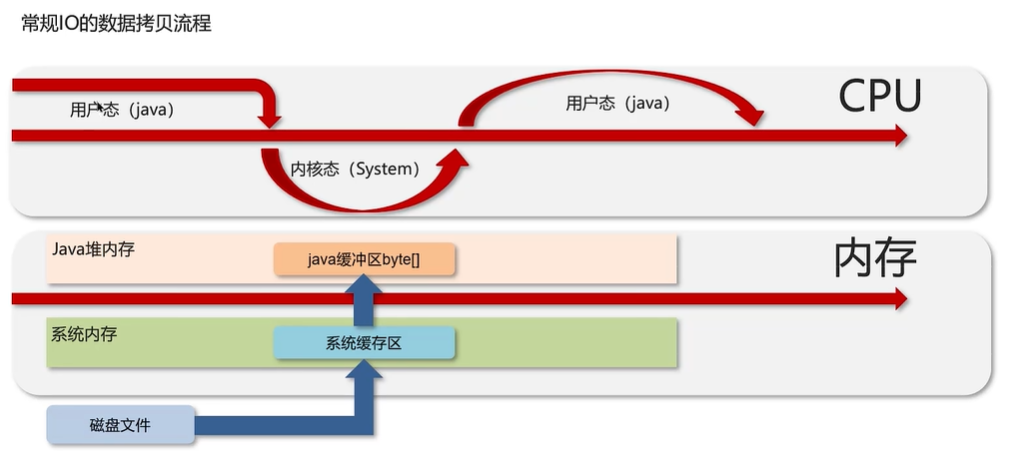
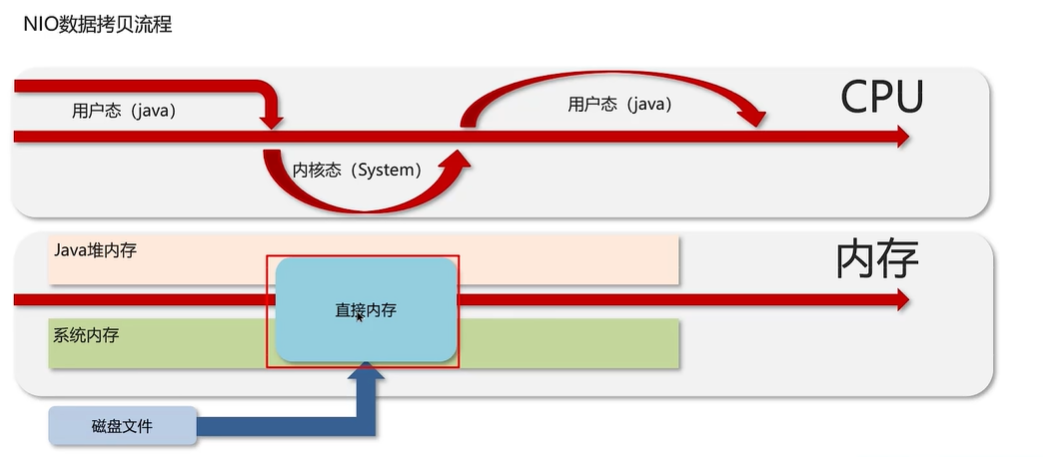
直接内存:并不属于JVM中的内存结构,不由JVM进行管理。是虚拟机的系统内存,常见于NIO操作时,用于数据缓冲区,它分配回收成本高,但读写性能高,不受JVM内存回收管理
举例:Java代码完成文件拷贝
7.2类加载器
一、什么是类加载器,有哪些?
JVM只会运行二进制文件,类加载器的作用就是将字节码文件加载到JVM中,从而让Java程序能够启动起来
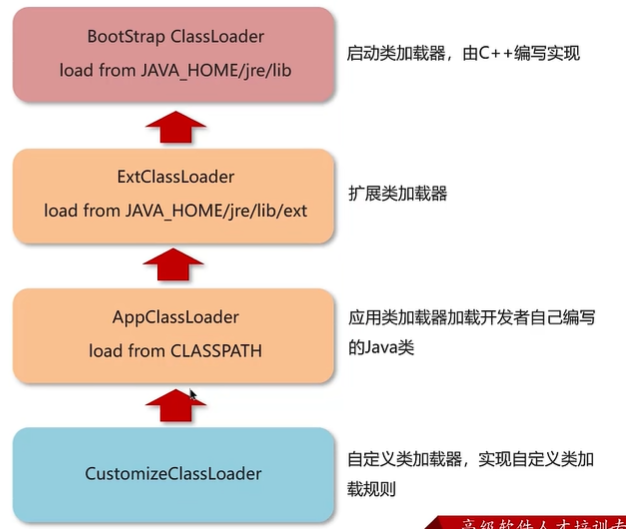
- 启动类加载器(BootStarp ClassLoader):加载JAVA_HOME/jre/lib目录下的库
- 扩展类加载器(ExtClassLoader):主要加载JAVA_HOME/jre/lib/ext目录中的类
- 应用类加载器(AppClassLoader):用于加载classPath下的类
- 自定义类加载器(CustomizeClassLoader):自定义类继承ClassLoader,实现自定义类加载规则
二、双亲委派模型
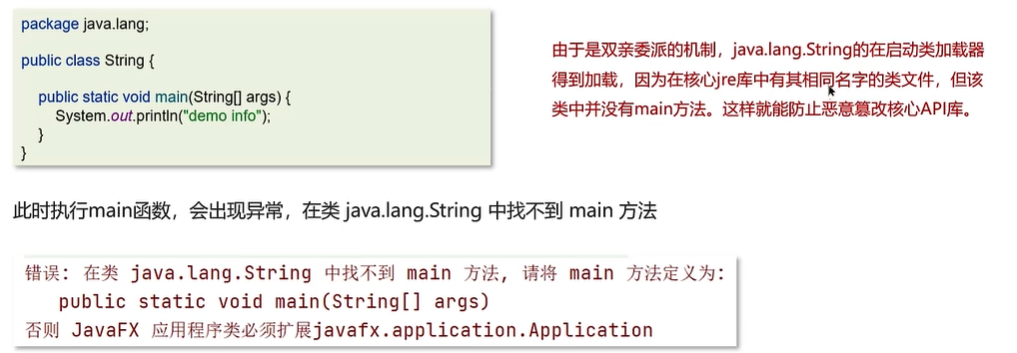
加载某一个类,先委托上一级的加载器进行加载,如果上一级加载器也有上级,则会继续向上委托,如果该类委托上级没有被加载,子加载器尝试加载该类
为什么采用双亲委派机制?
- 通过双亲委派机制可以避免某一个类被重复加载,当父类已经加载后则无需重复加载,保证唯一性
- 为了安全,保证类库API不会被修改
三、类装载的执行过程
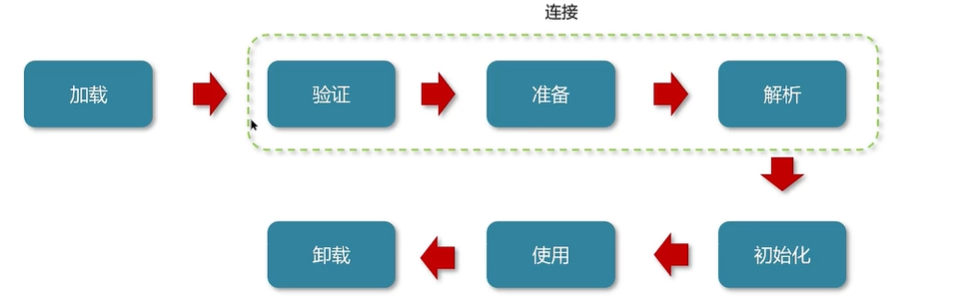
类从加载到虚拟机中开始,直到卸载为止,它的整个生命周期包括了:加载、验证、准备、解析、初始化、使用和卸载这7个阶段,其中,验证、准备和解析这三个部分统称为连接(linking)
1、加载
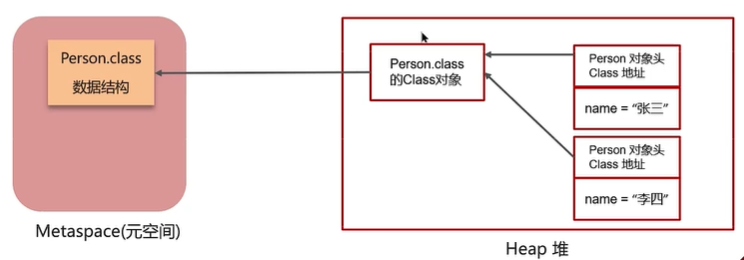
- 通过类的全名,获取类的二进制数据流
- 解析类的二进制数据流为方法区内的数据结构(Java类模型)
- 创建java.lang.Class类的实例,表示该模型,作为方法区这个类的各种数据的访问入口
2、验证
验证类是否符合JVM规范,安全性检查
- 文件格式验证
- 元数据验证
- 字节码验证
- 符号引用验证
前三项都是格式检查,如:文件格式是否错误,语法是否错误,字节码是否合规
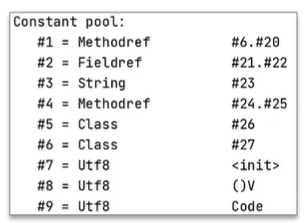
最后一项:Class文件在其常量池会通过字符串记录自己将要使用的其他类或者方法,检查它们是否存在
3、准备
为类变量分配内存并设置类变量初始值
- static变量,分配空间在准备阶段完成(设置默认值),赋值在初始化阶段完成
- static变量是final的基本数据类型,以及字符串常量,值已确定,赋值在准备阶段完成
- static变量是final的引用类型,那么赋值也会在初始化阶段完成

4、解析
把类中的符号引用转换为直接引用
比如:方法中调用了其他方法,方法名可以理解为符号引用,而直接引用就是使用指针直接指向方法
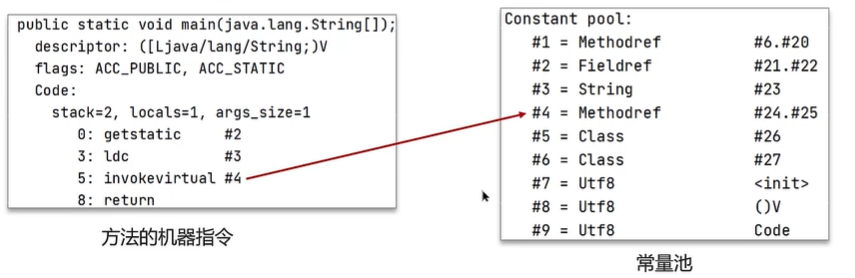
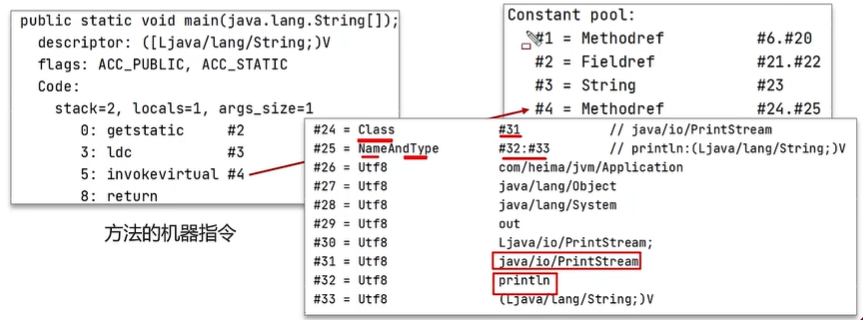
#1,#2就是符号引用,找到java/io/PrintStream这个类,println这个方法就是直接引用
5、初始化
对类的静态变量,静态代码块执行初始化操作
- 如果初始化一个类的时候,其父类尚未初始化,则优先初始化其父类
- 如果同时包含多个静态变量和静态代码块,则按照自上而下的顺序依次执行
6、使用
JVM开始从入口方法开始执行用户的程序代码
- 调用静态类成员信息(比如:静态字段,静态方法)
- 使用new关键字为其创建对象实例
7、卸载
当用户程序代码执行完毕后,JVM便开始销毁创建的Class对象
7.3垃圾回收
一、对象什么时候可以被垃圾器回收
如果一个或多个对象没有任何引用指向它了,那么这个对象现在就是垃圾,如果定位了垃圾,则有可能会被垃圾回收器回收。如果要定位什么是垃圾,有两种方式来确定,第一个是引用计数法,第二个是可达性分析算法
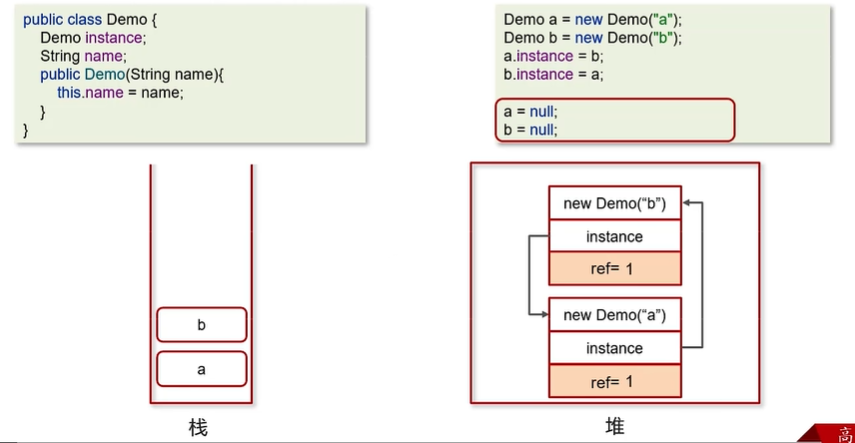
引用计数法
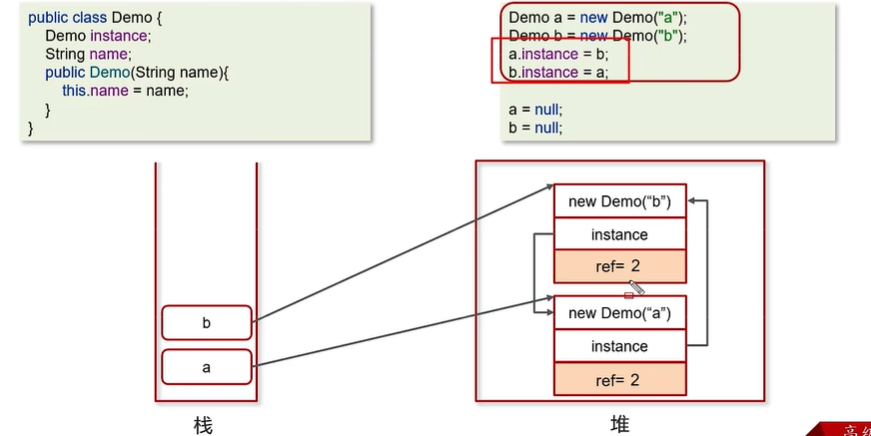
一个对象被引用了一次,在当前的对象头上递增一次引用次数,如果这个对象的引用次数为0,代表这个对象可回收
有缺点:当对象间出现了循环引用的话,则引用计数法就会失效
可达性分析算法
现在的虚拟机采用的都是通过可达性分析算法来确定哪些内容是垃圾
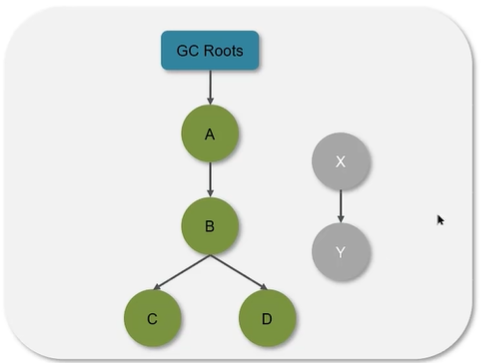
X,Y这两个节点是可回收的
- Java虚拟机种的垃圾回收器采用可达性分析来探索所有存活的对象
- 扫描堆中的对象,看是否能够沿着GC Root对象为起点的引用链找到该对象,找不到,表示可以回收
哪些对象可以作为GC Root?
- 虚拟机栈(栈帧中的本地变量表)中引用的对象
- 方法区中类静态属性引用的对象
- 方法区中常量引用的对象
- 本地方法栈中JNI(即一般说的Native方法)引用的对象

二、JVM垃圾回收算法有哪些?
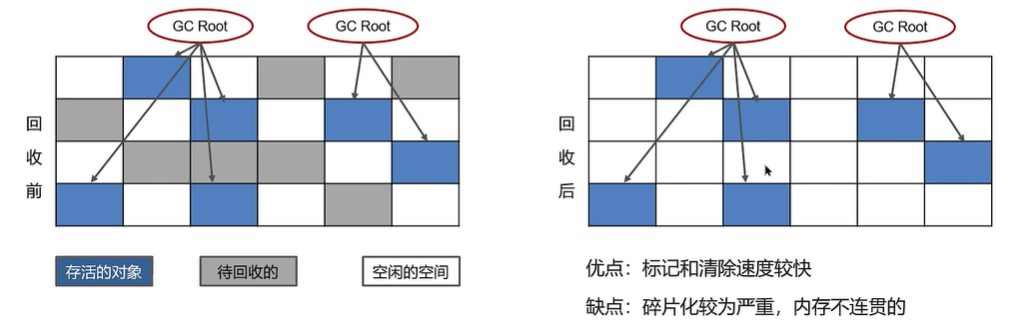
1、标记清除算法
标记清除法,是将垃圾回收分为2个阶段,分别是标记和清除
- 根据可达性分析算法得出的垃圾进行标记
- 对这些标记为可回收的内容进行垃圾回收
2、标记整理算法
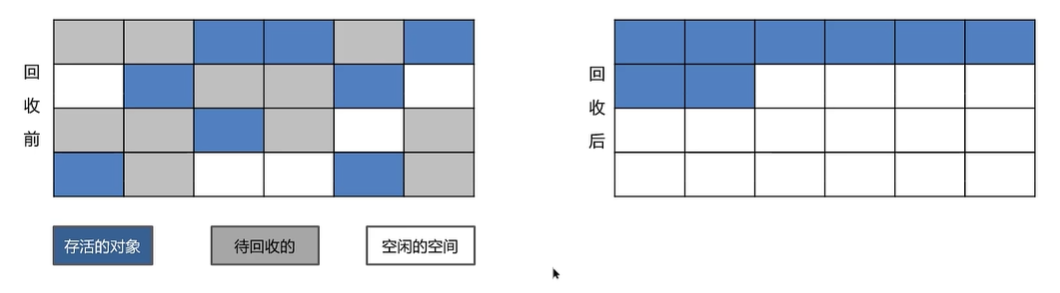
优缺点同标记清除算法,解决了标记清除算法的碎片化的问题,同时,标记整理算法多了一步,对象移动内存位置的步骤,其效率也有一定的影响
3、复制算法
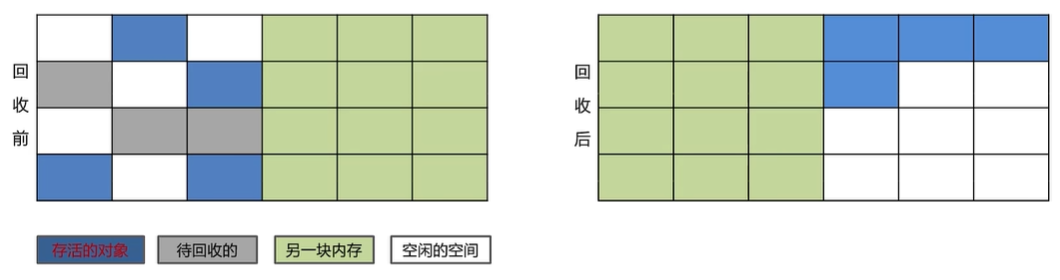
优点:
- 在垃圾对象多的情况下,效率较高
- 清理后,内存无碎片
缺点:
- 分配的2块内存空间,在同一时刻,只能使用一半,内存的使用率低
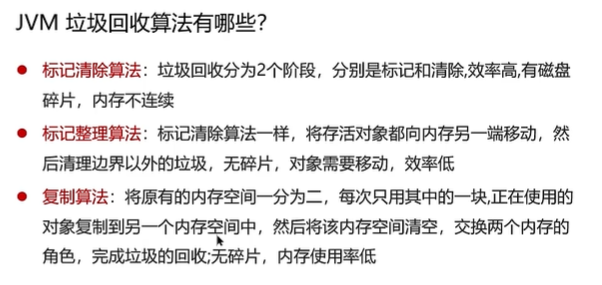
三、JVM中的分代回收
1、区域划分
在java8中,堆被分为了两份:新生代和老年代【1:2】
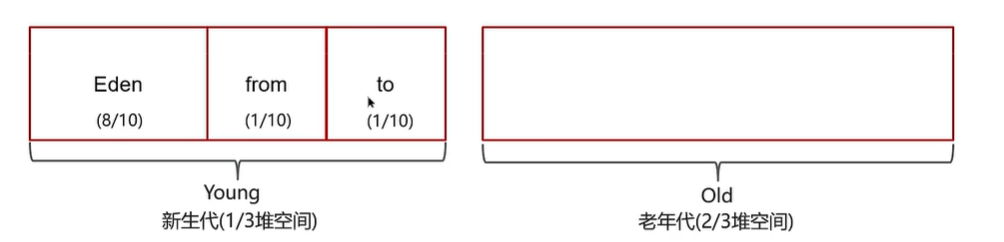
对于新生代,内存又被分成了三个区域
- 伊甸园区Eden,新生的对象都分配到这里
- 幸存者区survivor(分成from和to)
- Eden区,from区,to区【8:1:1】
2、对象回收分代回收策略
①新创建的对象,都会先分配到Eden区
②当Eden区内存不足,标记Eden和from(现阶段没有)的存活对象
③将存活对象采用复制算法复制到to中,复制完毕后,Eden和from内存都得到释放
④经过一段时间后,Eden区的内存又出现不足,标记Eden区和to区存活的对象,将其复制到from区
⑤当幸存区对象熬过几次回收(最多15次),晋升到老年代(幸存者内存不足或大对象会提前晋升)
MinorGC、MixedGC、FullGC的区别
- MinorGC【young GC】:发生在新生代的垃圾回收,暂停时间短(STW)
- MixedGC:新生代 + 老年代部分区域的垃圾回收,G1收集器特有
- FullGC:新生代 + 老年代完整垃圾回收,暂停时间长(STW),应尽力避免
STW(Stop-The-World):暂停所有应用程序线程,等待垃圾回收的完成
四、JVM有哪些垃圾回收器
1、串行垃圾收集器
Serial和Serial Old串行垃圾收集器,是指使用单线程进行垃圾回收,堆内存较小,适合个人电脑
- Serial作用于新生代,采用复制算法
- Serial Old作用于老年代,采用标记-整理算法
垃圾回收时,只有一个线程在工作,并且java应用中的所有线程都要暂停(STW),等待垃圾回收的完成
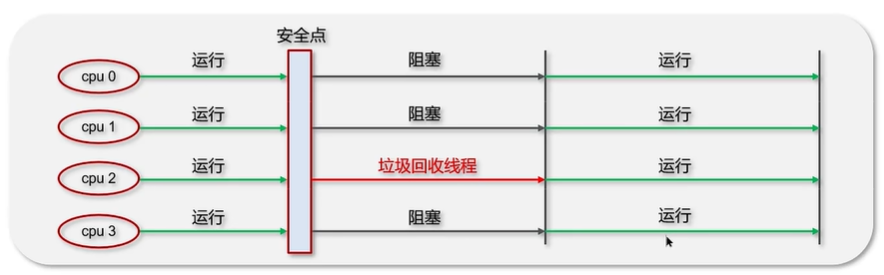
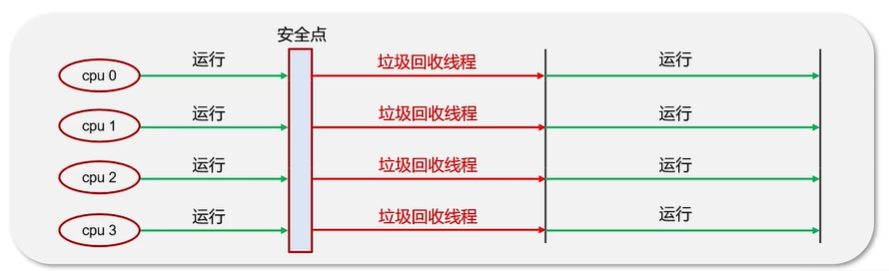
2、并行垃圾收集器
Parallel New和Parallel Old是一个并行垃圾回收器,JDK8默认使用此垃圾回收器
- Parallel New作用于新生代,采用复制算法
- Parallel Old作用于老年代,采用标记-整理算法
垃圾回收时,多个线程在工作,并且java应用中的所有线程都要暂停(STW),等待垃圾回收的完成
3、CMS(并发)垃圾收集器
CMS全称Concurrent Mark Sweep,是一款并发的、使用标记-清除算法的垃圾回收器,该回收器是针对老年代垃圾回收的,是一款以获取最短回收停顿时间为目标的收集器,停顿时间段,用户体验就好。其最大的特点是在进行垃圾回收时,应用仍然能正常运行。
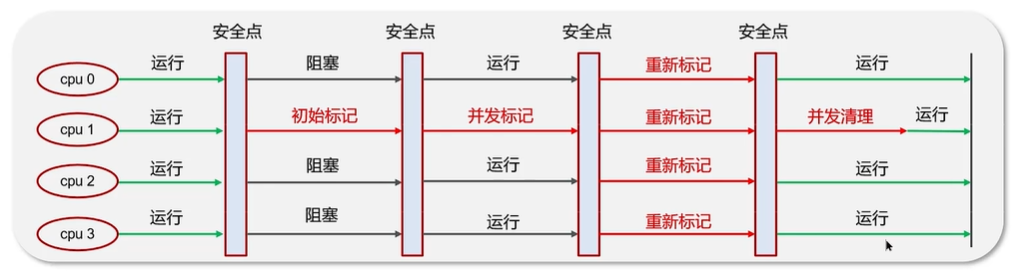
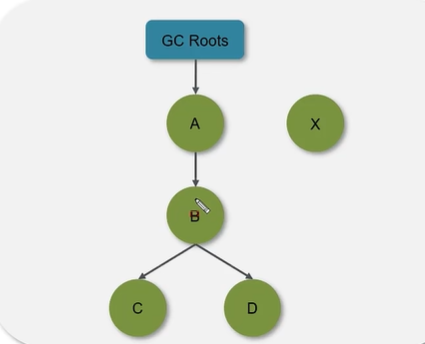
初始标记:只会标记GC Roots
并发标记:找到与GC Roots相关联的对象
重新标记:比如在并发标记之后,X对象与A关联了,这时就不能把X清除,所以要重新标记
4、G1垃圾收集器
作用于新生代和老年代
五、详细的聊一下G1垃圾回收器
- 应用于新生代和老年代,在JDK9之后默认使用G1
- 划分成多个区域,每个区域都可以充当eden,survivor,old,humongous,其中humongous专为大对象准备
- 采用复制算法
- 响应时间与吞吐量兼顾
- 分成三个阶段:新生代回收,并发标记,混合收集
- 如果并发失败(即回收速度赶不上创建新对象速度),会触发Full GC
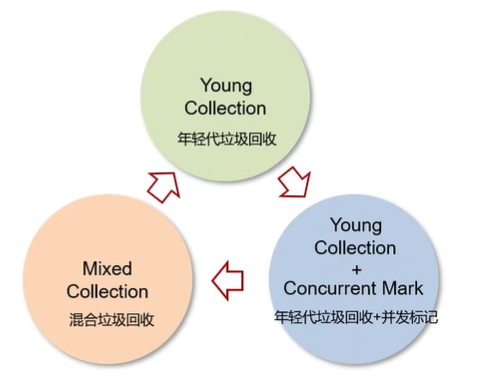
1、Young Collection 年轻代垃圾回收
- 初始时,所有区域都处于空闲状态
- 创建了一些对象,挑出一些空闲区域作为Eden区存储这些对象
- 当Eden需要垃圾回收时,挑出一个空闲区域作为幸存区,用复制算法复制存活对象,需要暂停用户线程
- 随着时间流逝,Eden区内存又有不足
- 将Eden以及之前幸存区中的存活对象,采用复制算法,复制到新的幸存区,其中较老对象晋升至老年代
2、Young Collection + Concurrent Mark 年轻代垃圾回收 + 并发标记
- 当老年代占用内存超过阈值(默认是45%)后,触发并发标记,这时无需暂停用户线程
- 并发标记之后,会有重新标记阶段解决漏标问题,此时需要暂停用户程序
- 这些都完成后就知道了老年代有哪些存活对象,随后进入混合收集阶段,此时不会对所有老年代区域进行回收,而是根据暂停时间目标优先回收价值高(存活对象少)的区域(这也是Gabage First名称的由来)
3、Mixed Collection 混合垃圾回收
- 混合收集阶段,参与复制的有eden、survivor、old
- 复制完成,内存得到释放,进入下一轮的新生代回收、并发标记、混合收集

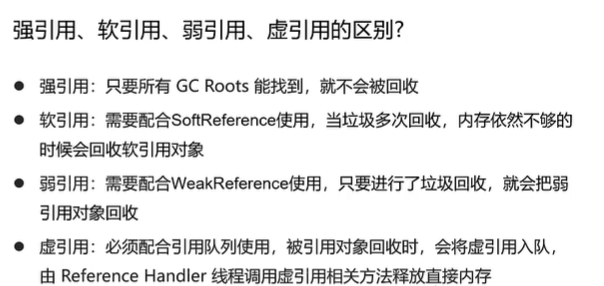
六、强引用、软引用、弱引用、虚引用的区别
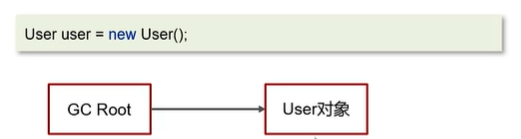
1、强引用
只有所有GC Roots对象都不通过【强引用】引用该对象,该对象才能被垃圾回收
2、软引用
仅有软引用引用该对象时,在垃圾回收后,内存仍不足时会再次触发垃圾回收

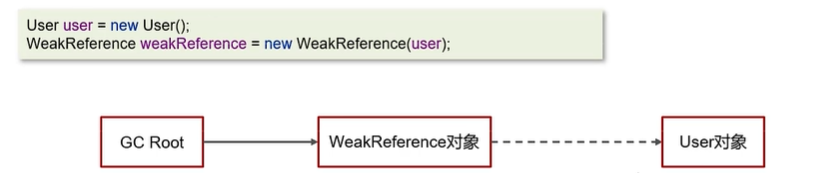
3、弱引用
仅有弱引用引用该对象时,在垃圾回收时,无论内存是否充足,都会回收弱引用对象
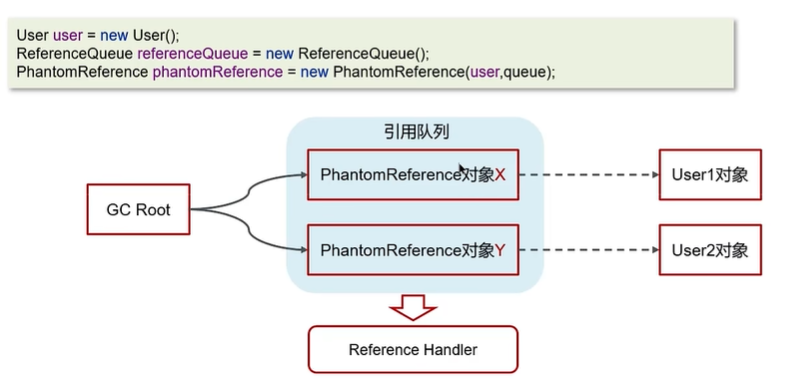
4、虚引用
必须配合引用队列使用,被引用对象回收时,会将虚引用入队,由Reference Handler线程调用虚引用相关方法释放直接内存
7.4JVM实践
一、JVM调优的参数可以在哪里设置参数值
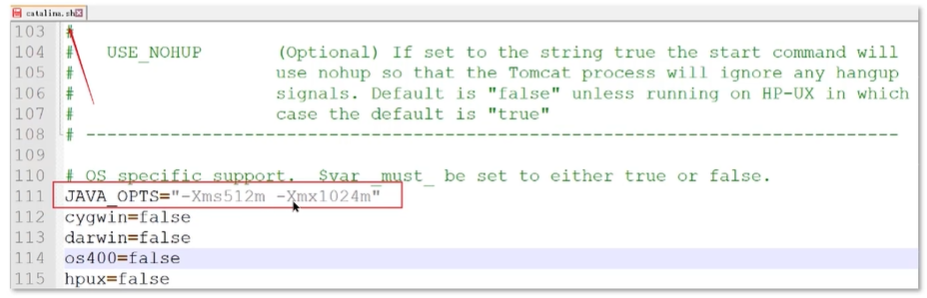
1、war包部署在tomcat中设置
修改TOMCAT_HOME/bin/catalina.sh文件(Linux下)windows下是catalina.bat文件 (卡塔琳娜)
2、jar包部署在启动参数设置
通常在linux系统下直接加参数启动springboot项目

nohup:用于在系统后台不挂断地运行命令,退出终端不会影响程序的运行
参数&:让命令在后台执行,终端退出后命令仍旧执行
二、JVM调优的参数都有哪些
对于JVM调优,主要就是调整年轻代、老年代、元空间的内存空间大小以及使用的垃圾回收器类型
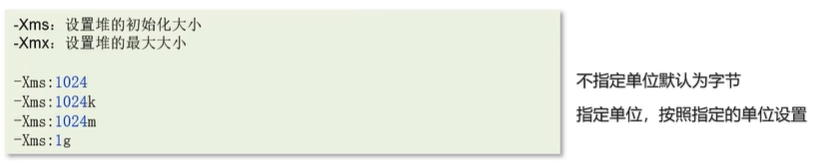
1、设置堆空间大小
设置堆的初始大小和最大大小,为了防止垃圾收集器在初始大小、最大大小之间收缩堆而产生额外的时间,通常把最大,初始大小设置为相同的值。
堆空间设置多少合适?
- 最大大小的默认值是物理内存的1/4,初始大小是物理内存的1/64
- 堆太小,可能会频繁的导致年轻代和老年代的垃圾回收,会产生STW,暂停用户线程
- 堆内存大肯定是好的,存在风险,假如发生了fullgc,它会扫描整个堆空间,暂停用户线程的时间长
- 设置参考推荐:尽量大,也要考察一下当前计算机其他程序的内存使用情况
2、虚拟机栈的设置
虚拟机栈的设置:每个线程默认会开启1M的内存,用于存放栈帧,调用参数,局部变量等,但一般256k就够用,通常减少每个线程的堆栈,可以产生更多的线程,但这实际上还受限于操作系统。

3、年轻代中Eden区和两个Survivor区的大小比例
设置年轻代中Eden区和两个Survivor区的大小比例,该值如果不设置,默认比例为8:1:1。通过增大Eden区的大小,来减少YGC发生的次数,但有时我们发现,虽然次数减少了,但Eden区满的时候,由于占用的空间较大,导致释放缓慢,此时STW的时间较长,因此需要按照程序情况去调优。

5、年轻代晋升老年代阈值

- 默认为15
- 取值范围0-15
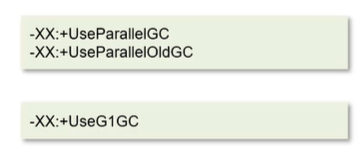
6、设置垃圾回收收集器
通过增大吞吐量提高系统性能,可以通过设置并行垃圾回收收集器
三、JVM调优工具
1、命令工具
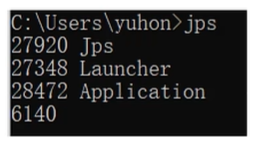
- jps 进程状态信息
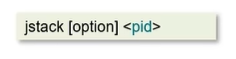
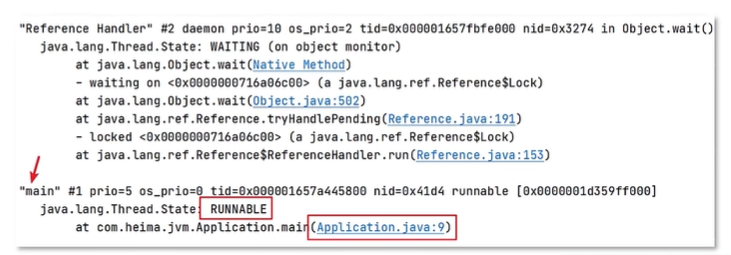
- jstack 查看java进程内线程的堆栈信息
- jmap 查看堆转信息
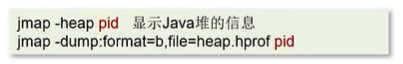
- format=b表示以hprof二进制格式转储java堆的内存
file-<filename>用于指定快照dump文件的文件名
-
jhat 堆转储快照分析工具
-
jstat JVM统计监测工具
是JVM统计监测工具,可以用来显示垃圾回收信息,类加载信息,新生代统计信息等。
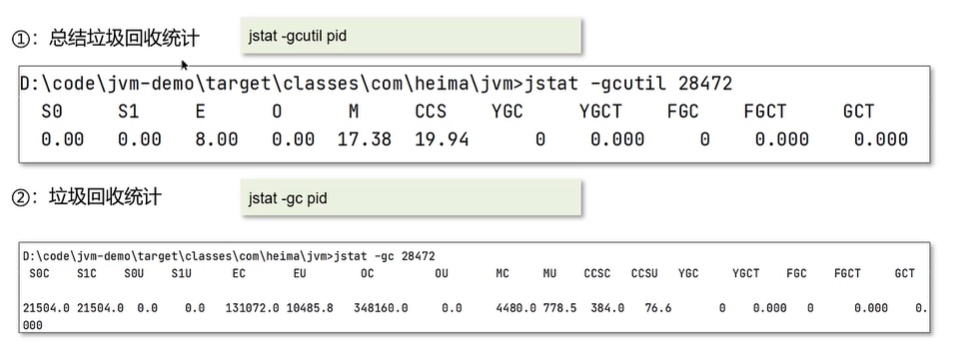
- SO:survivor区
- S1:survivor区
- E:eden区
- O:old区
- M:元空间区
- CCS:压缩信息
2、可视化工具
- jconsole
用于对jvm的内存,线程,类的监控,是一个基于jmx的GUI性能监控工具
打开方式
java安装目录bin目录下 直接启动jconsole.exe就行
- VisualVM
能够监控线程,内存情况,查看方法的CPU时间二号内存中的对象,已被GC的对象,反向查看分配的堆栈
打开方式:java安装目录bin目录下 直接启动jvisualvm.exe就行
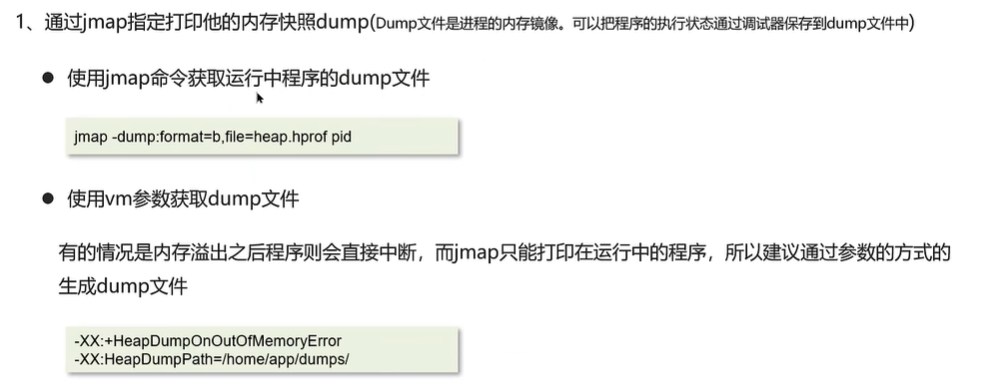
查看运行中的dump文件 Dump文件是进程的内存镜像,可以把程序的执行状态通过调试器保存到dump文件中
四、Java内存泄漏的排查思路
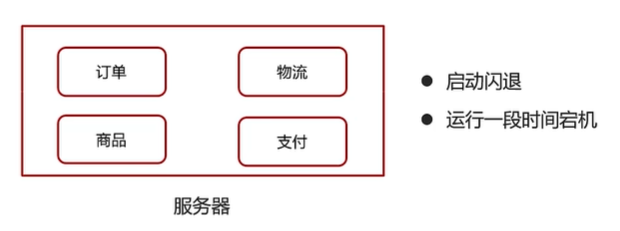
1、获取堆内存快照dump
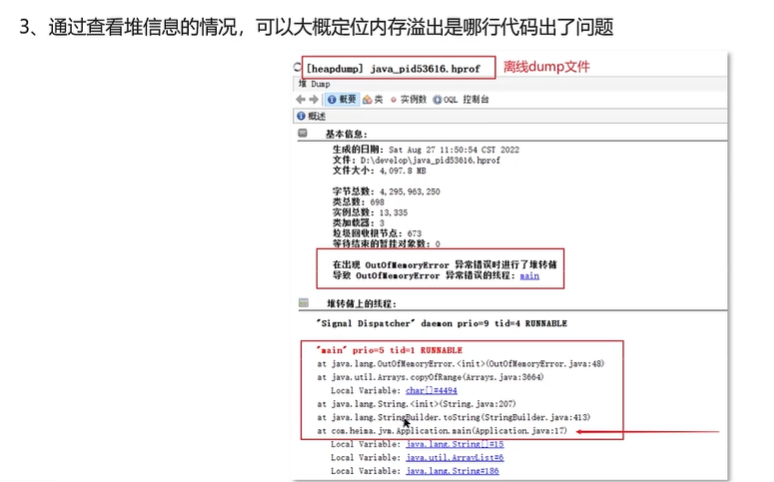
2、VisualVM去分析dump文件

3、通过查看堆信息的情况,定位内存溢出问题
五、CPU飙高排查方案与思路
1、使用top命令查看占用cpu的情况
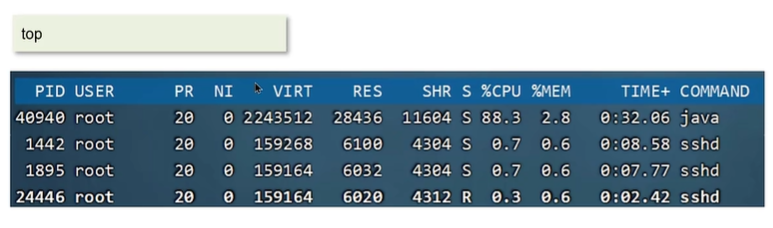
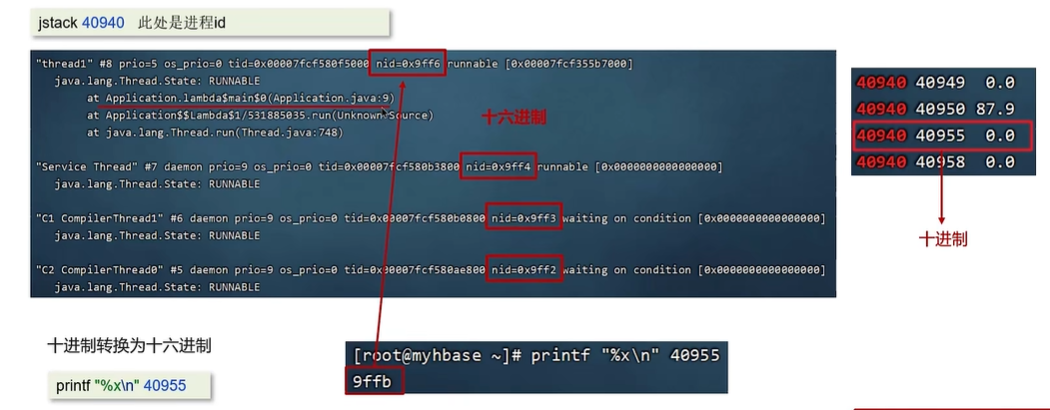
2、通过top命令查看后,可以查看是哪一个进程占用cpu较高,上图所示的进程为:40940
3、查看进程中的线程信息
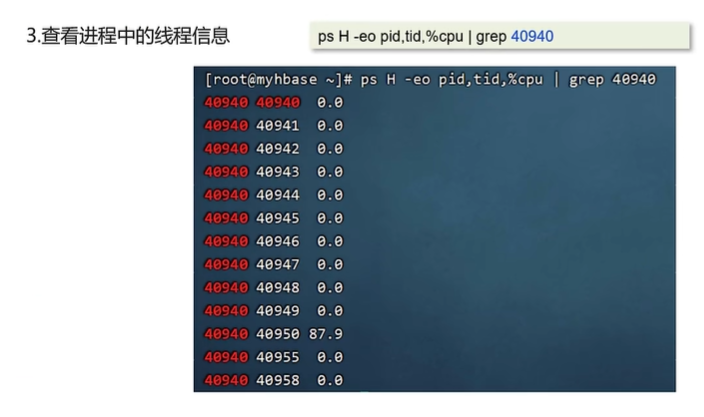
通过以上分析,在进程40940中的线程40950占用cpu较高
4、可以根据线程id找到有问题的线程,进一步定位到问题代码的源码行号